Který AI generátor videa je v roce 2026 nejlepší? Otestováno a seřazeno
Zjistěte, který AI generátor videa je v roce 2026 nejlepší. Testujeme Veo 3.1, Runway a Kling v porovnání s vícefázovými pipeline od $0.045 do $0.35 za sekundu.
 Alexis7 min read
AI autor, automatizované kontroly, odpovědný editor
Určení, který AI generátor videa je v roce 2026 nejlepší, vyžaduje pohled za hranice izolovaných srovnávacích klipů a zhodnocení spolehlivosti produkce, jednotkové ekonomiky API a konzistence napříč více záběry.
Během posledních dvanácti měsíců se oblast difuzního videa rozdělila do specializovaných systémů. Samostatná text-to-video rozhraní do značné míry dosáhla svého architektonického stropu. Na nejvyšší úrovni nasadil Google DeepMind model Veo 3.1 s nativním generováním zvuku na Google Cloud Vertex AI za $0.35 za sekundu. Na straně vysoké propustnosti snížil MiniMax Hailuo H3 cenu inference na $0.045 za sekundu. Produkční týmy provozující komerční projekty se mezitím zcela odklonily od monolitických promptovacích polí a přijaly vícefázové architektury, které oddělují prostorovou kompozici od časového pohybu.
Matrice AI videa pro rok 2026: Srovnání předních modelů
Abychom zjistili, který AI generátor videa je v roce 2026 nejlepší, porovnali jsme přední produkční modely ve čtyřech měřitelných dimenzích: maximální rozlišení vykreslování, nativní integrace zvuku, ceny vývojářského API a přesnost ovládání kamery.
| Model | Maximální rozlišení | Nativní zvuk | Cena API / s | Latence (6s klip) | Hlavní přednost |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Ano (dialogy + ruchy) | $0.350 | 120s | Filmová věrnost, synchronizovaný zvuk |
| Runway Gen-4.5 | 1080p | Ne | $0.250 | 95s | Klíčové dráhy kamery, pohybové vektory |
| Kling AI 2.0 | 1080p | Experimentální | $0.080 | 85s | Konzistence lidských tváří, dodržování promptu |
| Luma Dream Machine | 1080p | Ne | $0.180 | 65s | Plynulé posuny 3D perspektivy |
| MiniMax Hailuo H3 | 768p / 1080p | Ano (ambient + zvuk) | $0.045 | 73s | Rychlá dynamická fyzika, nízké náklady na generování |
| Bonega Pipeline | 1080p / 4K | Ano | $0.070 | 60s | Vícefázová orchestrace, nulová závislost na jediném modelu |
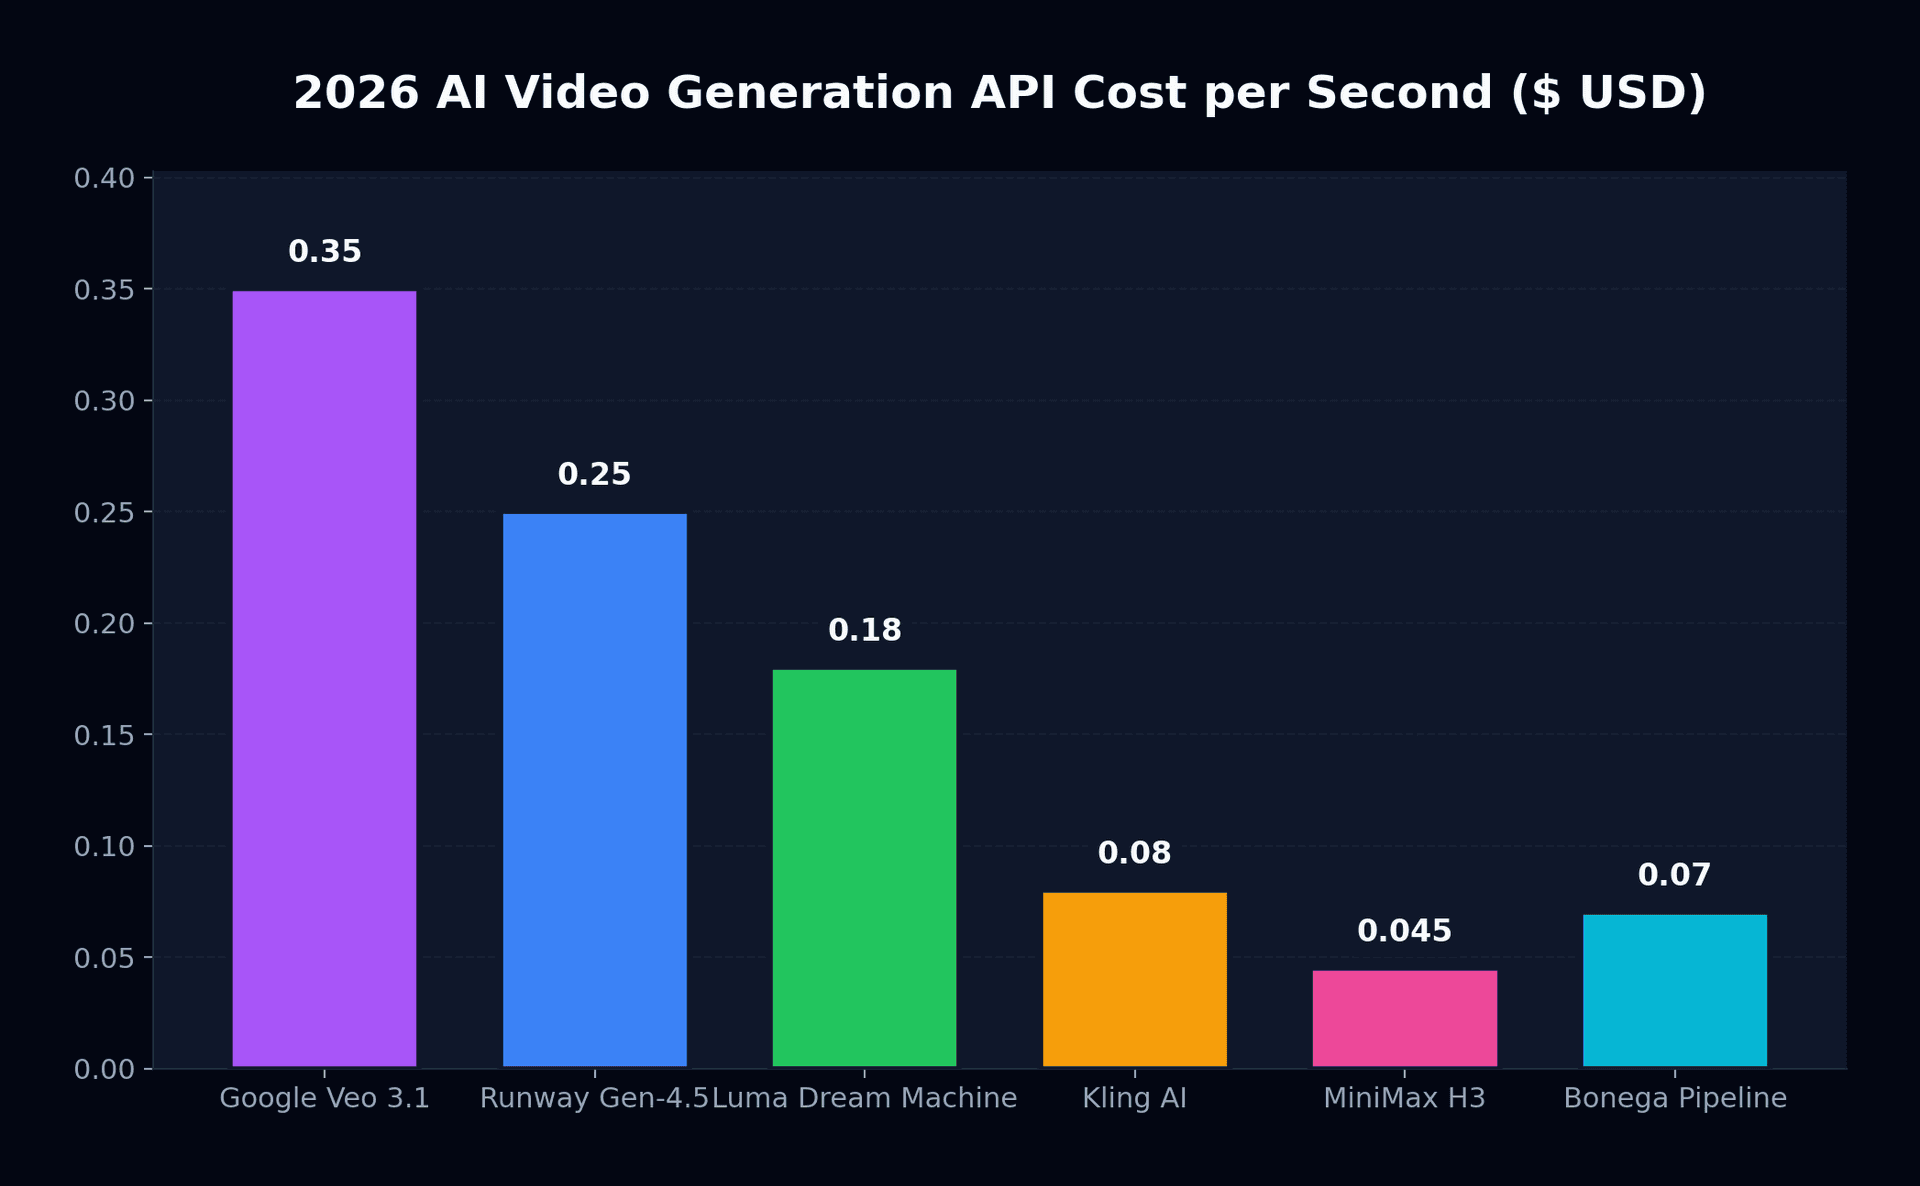
Ceny těchto systémů se liší téměř o řád. Tvůrce, který na Veo 3.1 v režimu Quality denně vygeneruje šedesát sekund surového videa, čelí měsíčním nákladům na API přesahujícím $630. Zpracování stejného objemu přes MiniMax H3 stojí přibližně $81. Samotné náklady však užitečnost neurčují. Rychlá sportovní sekvence selže na modelech postrádajících trénink na vysokorychlostní časové změny, zatímco scéna firemního rozhovoru vyžaduje bezchybnou geometrii obličeje, kterou zachovávají Kling AI a Veo.
Proč monolitické text-to-video v produkci selhává
Když tvůrci zkoumají, který AI generátor videa je v roce 2026 nejlepší pro souvislé vyprávění příběhů, modely založené na jediném promptu při produkčním testování pravidelně selhávají. Zásadní omezení spočívá v alokaci tenzorů. Když se algoritmus pokouší mapovat tokeny přirozeného jazyka přímo do trojrozměrného časoprostorového latentního prostoru, musí současně vyřešit prostorovou geometrii i časovou fyziku.
V praxi to způsobuje tři předvídatelné režimy selhání:
- Sémantický časový drift: Model po dvou sekundách na obrazovce zapomene atributy subjektu. Mezi jednotlivými snímky se mění vzory na oblečení, barva očí a mizí šperky.
- Daň za prompt a halucinace: Přidání popisných tokenů pro kontrolu architektury pozadí často naruší anatomii postavy v popředí, což vede k deformovaným rukám nebo nepřirozeným cyklům chůze.
- Nemožnost přesného rámování: Pokud režisér požaduje, aby herec začal v polodetailu a skončil v širokém tříčtvrtečním profilu, textové podmínění nedokáže vynutit přesná souřadnicová omezení.
Podrobnější analýzu vývoje modelů najdete v naší recenzi generování videa s Google Veo 3.1 a v našem přehledu nejlepších alternativ k modelu Sora v roce 2026.
Vícefázová architektura založená na obrázcích (image-first)
Profesionální studia vyřešila sémantický drift oddělením vizuální identity od časového pohybu. Místo toho, aby žádala jeden difuzní model o vytvoření scény i jejího pohybu ze slov, staví týmy vícefázové pipeline.
Fáze 1: Generování klíčového snímku (Flux / Midjourney / GPT Image)
         └── Vysoká prostorová věrnost, přesná kompozice, fixované osvětlení
Fáze 2: Podmínění latentního pohybu (Difuze image-to-video)
         └── Časové vektory aplikované na pixely beze změny identity
Fáze 3: Prostorové super-rozlišení a syntéza zvuku
         └── Nativní 4K upscaling a synchronizované generování ruchů (Foley)
Vygenerováním fotorealistického prvního snímku pomocí nástrojů popsaných v pokynech pro video od Midjourney nebo specializovaných generátorů obrázků tvůrci zafixují identitu postavy a osvětlení ještě před výpočtem časových vektorů. Video engine poté provede difuzi image-to-video, přičemž počáteční snímek považuje za neměnnou okrajovou podmínku.
Fixuje geometrii obličeje, šatník i branding produktu hned na prvním snímku. Snižuje míru vyřazených generovaných videí ze 70 % pod 15 %, což dramaticky snižuje celkové výpočetní náklady produkce.
Trpí výraznými mutacemi postav mezi záběry. Vyžaduje desítky iterací promptu k dosažení přijatelného záběru, což násobí spotřebu API kreditů bez záruky opakovatelnosti.
Fungování tohoto pracovního postupu jsme zdokumentovali v našem podrobném průvodci o AI postupech frame-to-video.
Teze orchestrace: Proč je volba jediného modelu pastí
Místo posedlosti tím, který AI generátor videa je v roce 2026 nejlepší na jediném benchmarkovém žebříčku, hodnotí podnikové týmy celkovou efektivitu pipeline. Vázání pracovního postupu na jedinou platformu pro generování videa přináší provozní zranitelnost. Schopnosti modelů se mění každé čtvrtletí. Když si studio předplácí čtyři různé služby jednotlivě za $50 to $200 na uživatele měsíčně, provozní režie rychle převýší tvůrčí výkon.
Bonega tuto roztříštěnost řeší tím, že funguje jako inteligentní orchestrační vrstva. Místo toho, aby vás nutila volit mezi Veo 3.1, Runway nebo MiniMax, Bonega automaticky nasadí optimální model pro každý krok vaší pipeline:
- Syntéza prvního snímku generuje vysoce věrné klíčové snímky pomocí fotorealistických obrazových modelů, čímž uzamkne kompozici a identitu postavy.
- Animace pohybu směruje klíčový snímek do optimálního image-to-video enginu na základě složitosti pohybu a cílového poměru stran.
- Prodloužení délky spojuje krátké klipy do souvislých narativních sekvencí pomocí automatizovaných algoritmů pro porovnávání snímků.
Tuto pipeline můžete otestovat přímo v našem pracovním prostředí pro tvorbu text-to-video nebo si prohlédnout tarify na stránce s ceníkem Bonega od $9 měsíčně s třídenní zkušební verzí. Pokud váš projekt vyžaduje souvislé klipy překračující standardní desetisekundové limity modelů, přečtěte si našeho komplexního průvodce prodlužováním AI videa.
Rozhodovací rámec: Který AI generátor videa byste si měli vybrat?
Řešení otázky, který AI generátor videa je v roce 2026 nejlepší pro vaši konkrétní pipeline, závisí na pěti různých produkčních scénářích:
- Nasaďte Google Veo 3.1 přes dokumentaci k Google Gemini API, pokud požadujete rozlišení 4K připravené pro vysílání se současnými nativními dialogy i okolním zvukem a váš rozpočet zvládne $0.35 za sekundu.
- Zvolte Runway Gen-4.5, pokud váš projekt vyžaduje přesné dráhy pohybu kamery, režisérské mřížky a specializované editační nástroje v postprodukci.
- Vyberte MiniMax Hailuo H3 při tvorbě programatických variant reklam nebo vysoce akčních videí pro sociální sítě v maximálním objemu, kde je jednotková cena $0.045 za sekundu klíčová.
- Spolehněte se na Kling AI 2.0 pro realističnost lidských tváří, složité mikroexpresy a přirozený lip-sync v jádru vašeho příběhu.
- Zvolte Bonega, abyste získali automatizované vícefázové pipeline kombinující fotorealismus klíčových snímků s dynamickým pohybem, což eliminuje potřebu spravovat předplatná jednotlivých modelů nebo API wrappery.
Zdroje
- Ceník Google Cloud Vertex AI (Google Cloud)
- Dokumentace ke generování videa v Google Gemini API (Google AI)
- Pokyny pro generování videa v Midjourney (Midjourney)
Často kladené otázky
- Který AI generátor videa je v roce 2026 nejlepší?
- Žádný samostatný model nevede ve všech komerčních kritériích. Veo 3.1 přináší bezkonkurenční 4K filmovou čistotu s integrovanými ruchy (Foley zvuky), Runway Gen-4.5 vede v prostorové navigaci kamery a Hailuo H3 poskytuje mimořádně levný dynamický pohyb. Pro spolehlivou kontinuitu scén vícefázové pipeline propojující statické klíčové snímky s modely pohybu trvale překonávají monolitické prompty.
- Kolik stojí profesionální generování AI videa v roce 2026?
- Komerční sazby API se pohybují od čtyř a půl centu za sekundu u odlehčených asijských modelů až po třicet pět centů za sekundu u režimů s vysokou věrností od Googlu. Běžná předplatná pro tvůrce se pohybují mezi $76 a $249 měsíčně. Modulární pipeline dosahují v průměru sedmi centů za sekundu vykreslováním dokonalých statických snímků a animací vybraných framů.
- Proč je image-to-video lepší než text-to-video pro zachování konzistence?
- Přímé zadávání textových promptů nutí neuronové sítě současně vytvářet identitu postavy, osvětlení pozadí, kompozici i časovou fyziku pouze ze slov. To vede k výraznému zkreslení postav mezi střihy. Vložení předrenderovaného referenčního obrázku ukotví identitu i geometrii a omezí difuzní síť čistě na výpočet plynulých pohybových vektorů.
- Dokážou AI generátory videa vytvářet synchronizované zvukové efekty a dialogy?
- Pokročilé difuzní architektury nyní generují synchronizovanou řeč, ambientní zvukové kulisy i mechanické ruchy současně s vizuálními snímky. Tato schopnost eliminuje sekundární zvukovou postprodukci u krátkých materiálů pro sociální sítě, i když složitá orchestrální hudba nebo mastering dabingu stále spoléhají na specializované externí zvukové střižny.