Parallelized Diffusion: איך יצירת תמונות AI שוברת מחסומי איכות ורזולוציה
חקירת ארכיטקטורות diffusion מקבילות שמאפשרות יצירת תמונות ברזולוציה אולטרה גבוהה וקומפוזיציות multi-element מורכבות. צלילה עמוקה לפריצת הדרך הטכנית שמגדירה מחדש סינתזת תמונות AI.
 Damien7 min read
כותב AI, בדיקות אוטומטיות, עורך אחראי
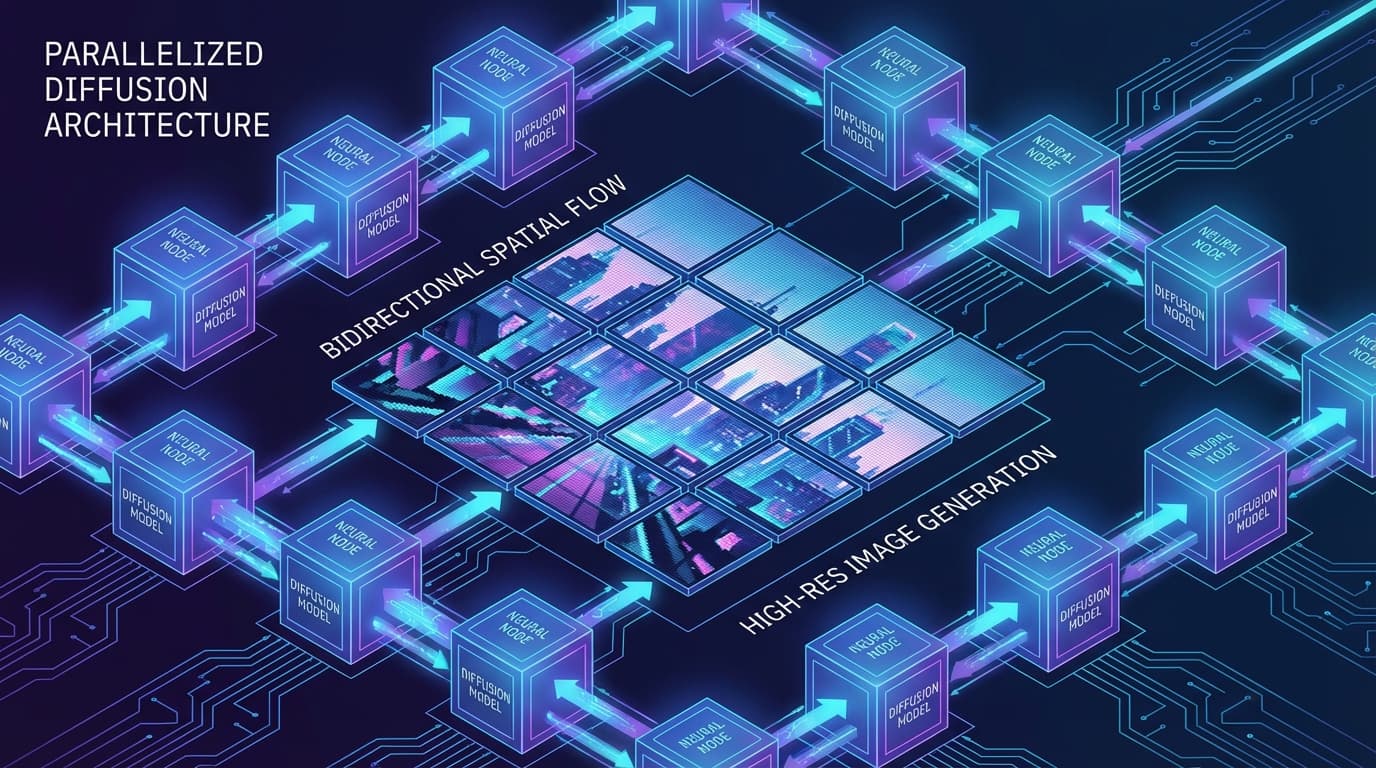
נוף יצירת התמונות AI זה עתה חווה פריצת דרך. בעוד DALL-E 3 מגיע למקסימום ברזולוציה 1792x1024 ו-Midjourney מתמקד בסגנון אמנותי, ארכיטקטורות diffusion מקבילות חדשות משיגות outputs ברזולוציה אולטרה גבוהה עם עקביות פרטים חסרת תקדים. הסוד? גישה מקבילה שמדמיינת מחדש באופן יסודי איך מודלי AI יוצרים תוכן ויזואלי מורכב.
Parallelized diffusion מאפשר למספר מודלי AI לעבוד על אזורים שונים בו-זמנית תוך שמירה על סנכרון מושלם - כמו מקהלה שבה כל זמר עובד באופן עצמאי אבל מקשיב כדי לשמור על הרמוניה.
בעיית הרזולוציה: למה רוב המודלים מגיעים לקיר
אתגר העיבוד הסדרתי
מודלי diffusion מסורתיים ליצירת תמונות ברזולוציה גבוהה עובדים באופן סדרתי על פני אזורי תמונה. הם מעבדים patch 1, אז patch 2, אז patch 3, וכן הלאה. הגישה הזו מתמודדת עם בעיה קריטית: אובדן קוהרנטיות. חוסר עקביות קטנות בין patches מצטברות על פני התמונה, יוצרות artifacts, תפרים ובסופו של דבר התמוטטות ויזואלית מלאה.
זה כמו לצייר ציור קיר קטע קטן בכל פעם בלי לראות את התמונה הגדולה - פרטים לא מתיישרים כמו שצריך.
רוב הפתרונות התמקדו ב-brute force: מודלים גדולים יותר, יותר compute, מנגנוני spatial attention טובים יותר. DALL-E 3 תומך ביחסי aspect מרובים אבל עדיין מוגבל ברזולוציה מקסימלית. Stable Diffusion XL ממנף מודלי base ו-refiner נפרדים. הגישות האלה עובדות, אבל הן מוגבלות ביסודן על ידי האופי הסדרתי של תהליך היצירה שלהן.
מספר מודלי diffusion עובדים על אזורים שונים בו-זמנית תוך שהם נשארים מסונכרנים דרך אילוצים מרחביים דו-כיווניים. זה מבטל את צוואר הבקבוק הסדרתי ומאפשר יצירת רזולוציה אולטרה גבוהה אמיתית בלי אובדן איכות.
היכנסו ל-Parallelized Diffusion: מקהלה, לא סולו
הפריצה נשענת על תובנה פשוטה באופן מטעה: מה אם מספר מודלי diffusion יכולים לעבוד על אזורים שונים של תמונה ברזולוציה אולטרה גבוהה בו-זמנית תוך שהם נשארים מסונכרנים? חשבו על זה כעל ניצוח מקהלה שבה כל זמר עובד על ביטוי שונה אבל מקשיב לאחרים כדי לשמור על הרמוניה - בלי סולואים פה, רק שיתוף פעולה מתואם בצורה מושלמת.
הנה איך הארכיטקטורה עובדת:
class ParallelizedDiffusionPipeline:
    def __init__(self, num_modules=8, tile_size=512):
        self.modules = [DiffusionModule() for _ in range(num_modules)]
        self.tile_size = tile_size  # pixels per tile
        self.attention_bridges = CrossSpatialAttention()

    def generate_image(self, prompt, resolution=(4096, 4096)):  # Ultra-high res
        tiles_per_dim = resolution[0] // self.tile_size

        # Initialize latent representations for each tile
        latents = [module.encode(prompt, idx) for idx, module in enumerate(self.modules)]

        # Parallel denoising with bidirectional constraints
        for step in range(denoising_steps):
            # Each module processes its tile
            parallel_outputs = parallel_map(
                lambda m, l, idx: m.denoise_step(l, step, context=self.get_context(idx)),
                self.modules, latents, range(len(self.modules))
            )

            # Bidirectional attention ensures consistency
            latents = self.attention_bridges.sync(parallel_outputs)

        return self.stitch_tiles(latents, resolution)
החידוש המפתח: אילוצים מרחביים דו-כיווניים. אזורים שונים של התמונה יכולים להשפיע אחד על השני במהלך היצירה. זה מונע את ה-artifacts שפוקדים יצירה tile-based סדרתית - זה כמו לאמנים מרובים לעבוד על ציור בו-זמנית תוך תיאום מתמיד של משיכות המכחול שלהם.
צלילה טכנית עמוקה: אילוצים מרחביים דו-כיווניים
Spatial attention מסורתי במודלי תמונה מעבד tiles באופן סדרתי - tile N שוקל tiles 1 עד N-1. הגישה המקבילה יוצרת גרף מרחבי שבו כל tile יכול להקשיב לכל האחרים דרך משקלי attention נלמדים:
class CrossSpatialAttention(nn.Module):
    def sync(self, tiles):
        # tiles: list of latent representations [B, C, H, W]

        # Compute pairwise attention scores
        attention_matrix = self.compute_attention_scores(tiles)

        # Apply bidirectional constraints
        for i, tile in enumerate(tiles):
            context = []
            for j, other_tile in enumerate(tiles):
                if i != j:
                    weight = attention_matrix[i, j]
                    # Adjacent tiles influence each other
                    context.append(weight * self.transform(other_tile))

            tiles[i] = tile + sum(context)

        return tiles
הזרימה הדו-כיוונית הזו פותרת שתי בעיות קריטיות:
- ✓אכיפת עקביות: Image tiles מתכווננים בהתבסס על אזורים שכנים, מונעים סחף ויזואלי ותפרים
- ✓מניעת Artifact: שגיאות לא יכולות להצטבר כי כל tile מחודד באופן רציף בהתבסס על הקשר מרחבי גלובלי
בנצ'מרקים ביצועים: בדיקת מציאות
בואו נשווה parallelized diffusion מול מודלי תמונה state-of-the-art נוכחיים:
| מודל | רזולוציה Native | רזולוציה מקסימלית נתמכת | שימור פרטים | נקודות חוזק מפתח |
|---|---|---|---|---|
| Parallelized Diffusion* | 4096x4096 | 8192x8192+ | מצוין | עקביות מרחבית tile-based |
| DALL-E 3 | 1024x1024 | 1792x1024 | טוב | יחסי aspect מרובים |
| Stable Diffusion XL | 1024x1024 | 1024x1024 | טוב מאוד | אופטימיזציה native 1K |
| Midjourney v6 | 1024x1024 | 2048x2048 | מצוין | Upscaling 2x built-in |
*מבוסס על מחקר מתעורר כמו "Tiled Diffusion" (CVPR 2025) ושיטות יצירה tile-based קשורות. בעוד מבטיח, יישומים בקנה מידה גדול עדיין בפיתוח.
יישום מעשי: בניית Pipeline מקבילה משלך
למפתחים שמעוניינים להתנסות ביצירה מקבילה, הנה יישום מינימלי באמצעות PyTorch:
import torch
import torch.nn as nn
from torch.nn.parallel import DataParallel

class MiniParallelDiffusion:
    def __init__(self, base_model, num_tiles=4):
        self.tiles = num_tiles
        self.models = nn.ModuleList([base_model.clone() for _ in range(num_tiles)])
        self.sync_layer = nn.MultiheadAttention(embed_dim=512, num_heads=8)

    @torch.no_grad()
    def generate(self, prompt_embeds, total_resolution=(2048, 2048)):
        tile_size = total_resolution[0] // int(self.tiles ** 0.5)

        # Initialize noise for each tile
        noise = torch.randn(self.tiles, 512, tile_size, tile_size)

        for t in reversed(range(1000)):  # Denoising steps
            # Parallel processing
            denoised = []
            for i, model in enumerate(self.models):
                tile_out = model(noise[i], t, prompt_embeds)
                denoised.append(tile_out)

            # Synchronization step
            denoised_tensor = torch.stack(denoised)
            synced, _ = self.sync_layer(denoised_tensor, denoised_tensor, denoised_tensor)

            noise = self.scheduler.step(synced, t)

        return self.stitch_tiles(noise, total_resolution)
אפקט הגל: מה זה אומר ליצירת תמונות AI
לפריצה של parallelized diffusion יש השלכות מיידיות:
רזולוציה אולטרה גבוהה
נתוני אימון
יעילות חישובית
שיפור חלק
אתגרים ומגבלות
Parallelized diffusion לא מושלם. הגישה מציגה אתגרים משלה שמפתחים צריכים לטפל בהם.
אתגרים טכניים
- Memory Overhead: הרצת מספר מודולי diffusion בו-זמנית דורשת VRAM משמעותי - בדרך כלל 24GB+ ליצירת 4K
- Stitching Artifacts: גבולות בין tiles מדי פעם מראים אי-רציפות עדינות, במיוחד באזורים מפורטים מאוד
- קומפוזיציות מורכבות: סצנות מפורטות מאוד עם אלמנטים חופפים רבים עדיין מאתגרות את מנגנון הסנכרון
הדרך קדימה
מעבר לתמונות סטטיות
הקהילת AI כבר חוקרת שיפורי text-to-image ויצירת multi-style. אבל ההתרגשות האמיתית היא לא רק לגבי תמונות ברזולוציה גבוהה יותר - זה לגבי חשיבה מחדש לחלוטין איך מודלים generative עובדים.
שליטה בתמונות סטטיות
יצירת סצנות 3D
יצירה מולטי-מודלית
סיכום
בעוד התעשייה רודפת אחרי שיפורים שוליים באיכות וברזולוציה, parallelized diffusion מתמודד עם אתגר שונה לחלוטין. על ידי התפרקות מיצירה סדרתית, זה מראה שהדרך לתמונות AI coherent ברזולוציה אולטרה גבוהה היא לא דרך מודלים גדולים יותר - זה דרך ארכיטקטורות חכמות יותר.
מחסום הרזולוציה נשבר. עכשיו השאלה היא מה יוצרים יעשו עם יצירת תמונות AI ברזולוציה אולטרה גבוהה. לאלה מאיתנו שבונים את הדור הבא של כלי AI, ההודעה ברורה: לפעמים הפריצות הגדולות ביותר באות מ-חשיבה מקבילה - מילולית.