2026年に最適なAI動画生成ツールはどれか?徹底検証&ランキング
2026年に最適なAI動画生成ツールを検証。Veo 3.1、Runway、Klingを、1秒あたり$0.045から$0.35のマルチステージパイプラインと比較テストしました。
 Alexis12 min read
AI著者、自動チェック済み、編集者が責任を担保
2026年に最適なAI動画生成ツールを判断するには、個別のベンチマーククリップの枠を超えて、制作上の信頼性、APIのユニットエコノミクス、そして複数ショット間の一貫性を評価する必要があります。
過去12か月間で、動画ディフュージョンを取り巻く環境は特化型エンジンへと細分化されました。スタンドアロン型のtext-to-videoインターフェースは、構造的なプラトー(頭打ち)にほぼ達しています。ハイエンド領域では、Google DeepMindがGoogle Cloud Vertex AI上でネイティブ音声生成機能を備えたVeo 3.1を1秒あたり$0.35で展開しました。高スループット領域では、MiniMax Hailuo H3が推論価格を1秒あたり$0.045まで引き下げました。一方、商用ワークロードを運用する制作チームは、単一のプロンプト入力欄から完全に脱却し、空間的な構図と時間的な動きを分離するマルチステージアーキテクチャを採用しています。
2026年AI動画マトリクス:主要モデルのベンチマーク比較
2026年に最適なAI動画生成ツールを特定するため、主要な商用モデルを最大レンダリング解像度、ネイティブ音声統合、開発者向けAPI価格、カメラ制御精度の4つの測定可能な軸で比較しました。
| モデル | 最大解像度 | ネイティブオーディオ | APIコスト / 秒 | レイテンシ(6秒クリップ) | 主な強み |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | あり(対話+フォーリー音) | $0.350 | 120s | 映画品質の忠実度、同期サウンド |
| Runway Gen-4.5 | 1080p | なし | $0.250 | 95s | キーフレームカメラパス、モーションベクター |
| Kling AI 2.0 | 1080p | 実験的 | $0.080 | 85s | 人物の顔の一貫性、プロンプト忠実度 |
| Luma Dream Machine | 1080p | なし | $0.180 | 65s | 滑らかな3D視点シフト |
| MiniMax Hailuo H3 | 768p / 1080p | あり(環境音+サウンド) | $0.045 | 73s | 高速なダイナミック物理挙動、低生成コスト |
| Bonega Pipeline | 1080p / 4K | あり | $0.070 | 60s | マルチステージオーケストレーション、モデルロックインなし |
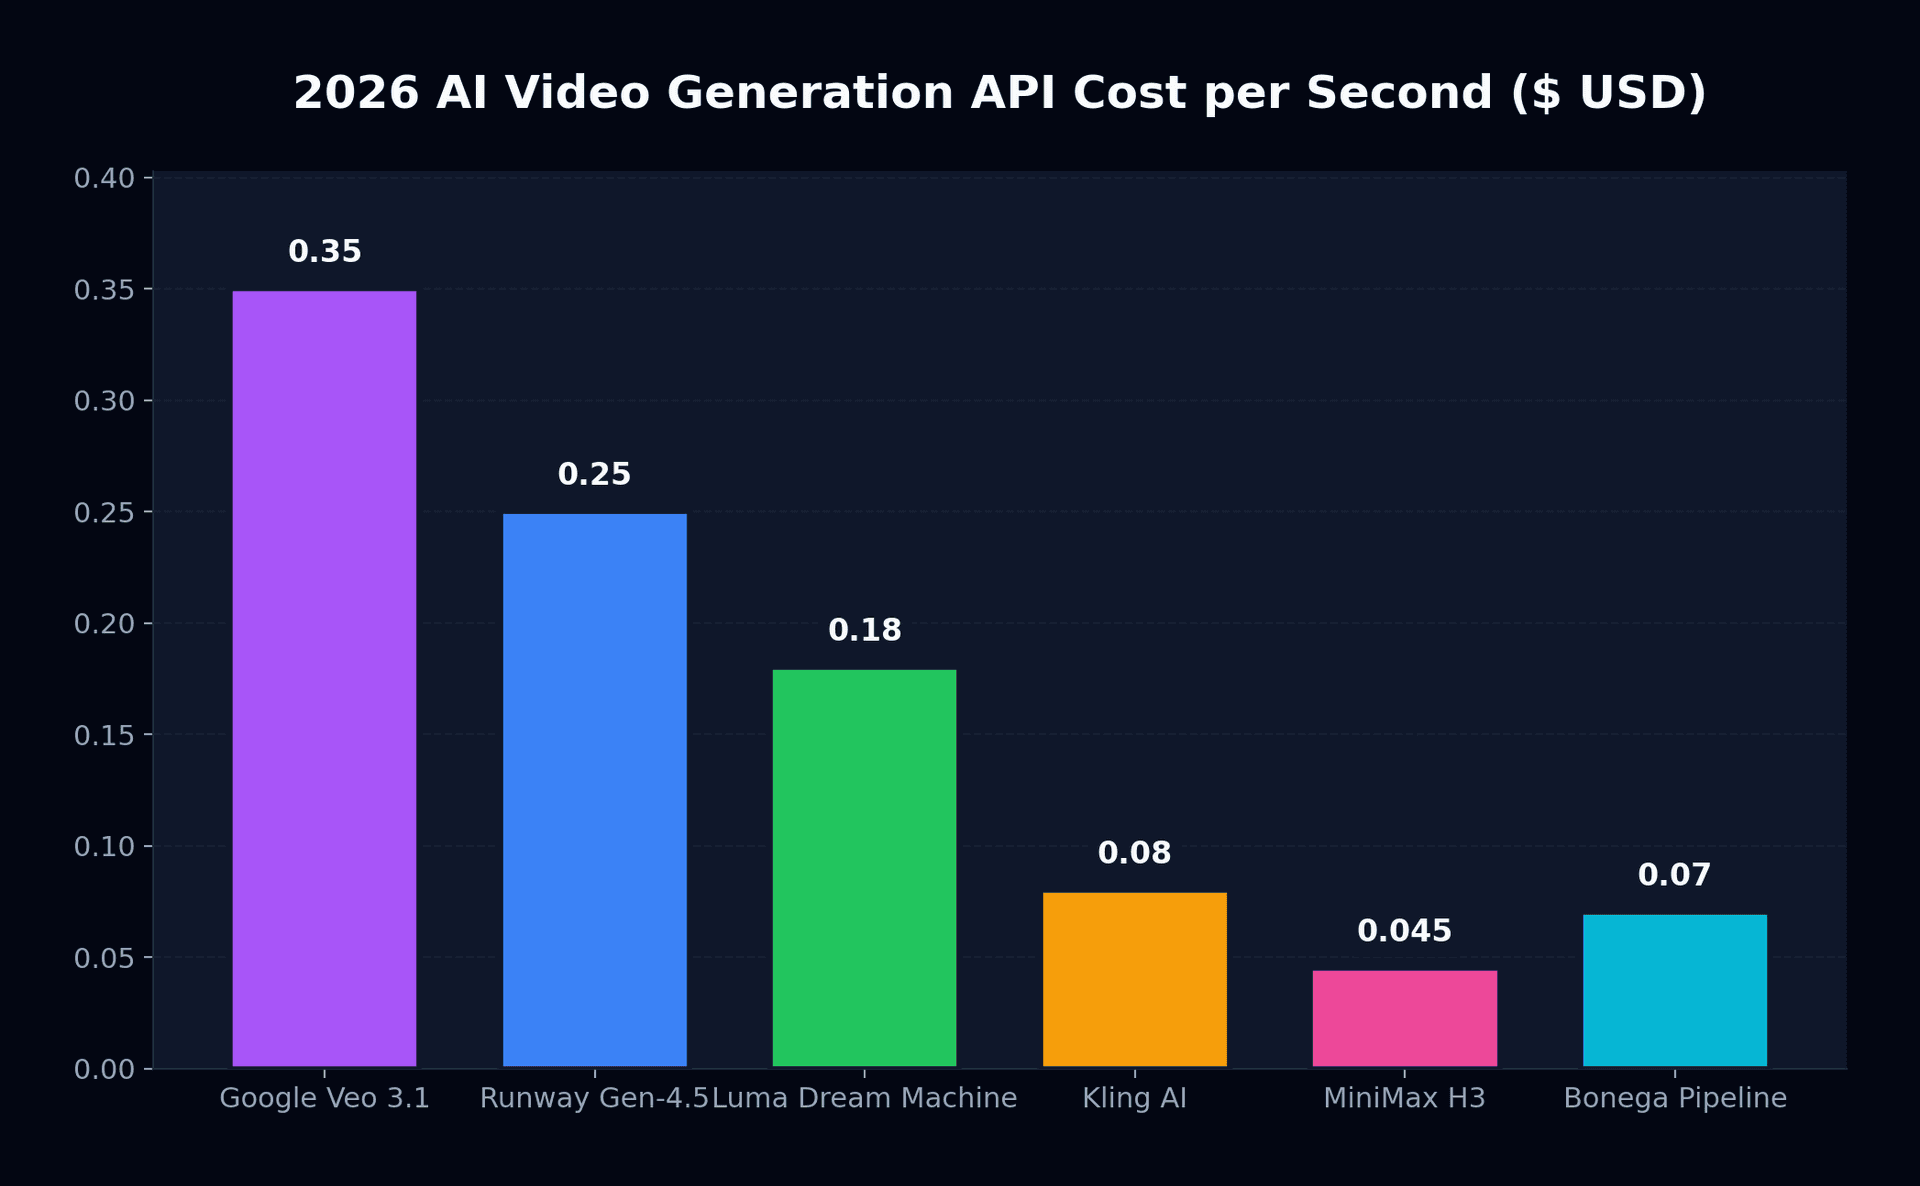
これらのエンジン間の価格差はほぼ1桁に達します。Veo 3.1のQualityモードで毎日60秒の未編集動画を生成するクリエイターの場合、月間のAPI消費額は$630を超えます。同じボリュームをMiniMax H3で処理した場合のコストは約$81です。しかし、コストだけで実用性が決まるわけではありません。高速度の時間軸トレーニングが不足しているモデルでは激しいアクションスポーツシーンが破綻する一方、企業のインタビューシーンではKling AIやVeoが保持する精緻な顔のジオメトリが不可欠となります。
単一のText-to-Videoがプロダクションで失敗する理由
継続的なストーリーテリングにおいて2026年に最適なAI動画生成ツールを調査する際、プロダクションのテスト環境では単一プロンプト型のモデルが日常的に力不足に陥ります。その根本的な限界はテンソル割り当てに起因します。アルゴリズムが自然言語トークンを3次元の時空間潜在空間に直接マッピングしようとする場合、空間ジオメトリと時間物理を同時に解決しなければなりません。
実際には、これにより3つの予測可能な失敗パターンが発生します。
- セマンティックな時間的ドリフト: 画面上に現れてから2秒後に、モデルが被写体の属性を忘れてしまいます。カット間で服の柄が変化し、目の色が変わり、装飾品が消滅します。
- プロンプト負荷とハルシネーション: 背景の建築物を制御するために説明トークンを追加すると、前景のキャラクターの解剖学的構造が損なわれ、歪んだ手や不自然な歩行サイクルが生じやすくなります。
- 正確な構図設定の不可能さ: 監督が俳優の動きとしてミディアムクローズアップから始まりワイドな4分の3プロファイルで終えることを求めても、テキストによる条件付けでは正確な座標制約を強制できません。
モデルの進化に関するより詳細な分析については、Google Veo 3.1の動画生成のレビューや、2026年における最高のSora代替ツールの解説をご覧ください。
マルチステージのImage-Firstアーキテクチャ
プロの制作スタジオは、視覚的アイデンティティと時間的モーションを切り離すことでセマンティックドリフトを解決しました。単一のディフュージョンモデルに言葉からシーンとその動きの両方を創出させるのではなく、複数のステージで構成されるパイプラインを構築しています。
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
└── Native 4K upscaling and synchronized Foley generationMidjourneyの動画ガイドラインに記載されているツールや特化型の画像生成ツールを用いて写真のような高品質な第1フレームを生成することで、クリエイターは時間ベクトルを計算する前にキャラクターのアイデンティティとライティングを固定します。その後、動画エンジンが初期フレームを変更不可能な境界条件として扱い、image-to-videoディフュージョンを実行します。
最初のフレームで顔のジオメトリ、衣装、製品ブランディングを固定。生成破棄率を70%から15%未満に低減し、全体的な制作計算コストを大幅に削減します。
カット間で深刻なキャラクター変形が発生。許容可能な構図を得るために何十回ものプロンプト試行が必要となり、再現性を保証できないままAPIクレジット消費を増大させます。
このワークフローの仕組みについては、フレームtoビデオAIワークフローの詳細ガイドにまとめています。
オーケストレーション論:単一モデルの選択が罠となる理由
単一のベンチマークリーダーボード上で2026年に最適なAI動画生成ツールがどれかに固執するよりも、エンタープライズチームはパイプライン全体の効率を評価します。ワークフローを単一の動画生成プラットフォームに依存させると、運用上の脆弱性が生じます。モデルの機能は四半期ごとに変化します。制作スタジオが個別に4つの異なるサービスへ1シートあたり月額$50から$200で契約すると、運用オーバーヘッドは瞬く間にクリエイティブな成果を圧迫します。
Bonegaはインテリジェントなオーケストレーション層として機能することで、この分断を解消します。Veo 3.1、Runway、MiniMaxのいずれかを選択させるのではなく、Bonegaはパイプラインの各ステップに最適なモデルを自動的に割り当てます。
- 第1フレームの合成: フォトリアリスティックな画像モデルを使用して高忠実度のキーフレームを生成し、構図とキャラクターのアイデンティティを固定します。
- モーションアニメーション: 動きの複雑さと対象のアスペクト比に基づいて、キーフレームを最適なimage-to-videoエンジンにルーティングします。
- 動画の延長: 自動フレームマッチングアルゴリズムにより、短いクリップをつなぎ合わせて一貫した物語シーケンスを構築します。
このパイプラインは、当社のText-to-Video作成ワークスペースで直接テストできます。また、プランの確認はBonegaの料金ページ(月額$9から、3日間トライアル付き)をご覧ください。プロジェクトで標準的な10秒のモデル上限を超える連続クリップが必要な場合は、AI動画延長ガイドをご覧ください。
意思決定フレームワーク:どのAI動画生成ツールを選ぶべきか?
ご自身のパイプラインにとって2026年に最適なAI動画生成ツールを判断するには、以下の5つの明確な制作シナリオに集約されます。
- 同期の対話音声および環境音を備えた放送品質の4K解像度が必要で、予算が1秒あたり$0.35を許容できる場合は、Google Gemini APIドキュメント経由でGoogle Veo 3.1を導入してください。
- 正確なカメラモーションパス、ディレクターグリッド、特化したポストプロダクション編集コントロールが必要なプロジェクトには、Runway Gen-4.5を採用してください。
- プログラムによる広告バリエーションや高アクションのSNS動画を最大ボリュームで作成し、1秒あたり$0.045のユニットエコノミクスが極めて重要な場合は、MiniMax Hailuo H3を選択してください。
- 物語の核となる人物の顔のリアリズム、複雑な微小表情、自然なリップシンクを重視する場合は、Kling AI 2.0に依拠してください。
- キーフレームのフォトリアリズムとダイナミックなモーションを両立させ、個々のモデルサブスクリプションやAPIラッパーの管理を不要にする自動マルチステージパイプラインを実現したい場合は、Bonegaを選択してください。
参考文献
- Google Cloud Vertex AI Pricing (Google Cloud)
- Google Gemini API Video Generation Documentation (Google AI)
- Midjourney Video Generation Guidelines (Midjourney)
よくあるご質問
- 2026年に最適なAI動画生成ツールはどれですか?
- すべての商用基準において単独でトップに立つエンジンは存在しません。Veo 3.1は内蔵フォーリーサウンドを備えた比類のない4Kシネマティックな鮮明さを誇り、Runway Gen-4.5は空間カメラナビゲーションでリードし、Hailuo H3は極めて低コストなダイナミックモーションを提供します。信頼性の高いシーンの連続性を確保するには、静止画キーフレームとモーションモデルを連携させるマルチステージパイプラインが、単一プロンプトの手法を一貫して上回ります。
- 2026年のプロ向けAI動画生成のコストはどのくらいですか?
- 商用API料金は、軽量なアジア系エンジンの1秒あたり4.5セントから、Googleの高忠実度モードの1秒あたり35セントまで幅があります。一般的なクリエイター向けサブスクリプションは月額$76から$249の範囲です。高精細な静止画をレンダリングして選択したフレームをアニメーション化するモジュール式パイプラインでは、1秒あたり平均7セントとなります。
- 一貫性の面で、なぜtext-to-videoよりもimage-to-videoのほうが優れているのですか?
- テキストからの直接プロンプト生成では、ニューラルネットワークが言葉のみからキャラクターのアイデンティティ、背景のライティング、構図、時間的物理挙動を同時に捏造する必要があります。これにより、カット間で深刻なキャラクターの変形が生じます。事前にレンダリングされた参照画像を入力することでアイデンティティと幾何構造が固定され、ディフュージョンネットワークの処理を滑らかなモーションベクターの計算のみに限定できます。
- AI動画生成ツールは同期された効果音や音声を生成できますか?
- 高度なディフュージョンアーキテクチャにより、映像フレームと連動して同期された音声、環境音、機械的なフォーリーオーディオを生成できるようになりました。この機能により、SNS向けの短い素材であれば二次的な音声ポストプロダクションが不要になります。ただし、複雑なオーケストラ劇伴やナレーションのマスタリングには、現在も専用の外部オーディオワークステーションが使用されています。