병렬화 확산: AI 이미지 생성이 품질 및 해상도 장벽을 깨는 방법
초고해상도 이미지 생성 및 복잡한 다중 요소 구성을 가능하게 하는 병렬화 확산 아키텍처를 탐구합니다. AI 이미지 합성을 재정의하는 기술적 획기적 발견에 대한 심층 탐구.
 Damien14 min read
AI 작성, 자동 검수, 편집자 책임
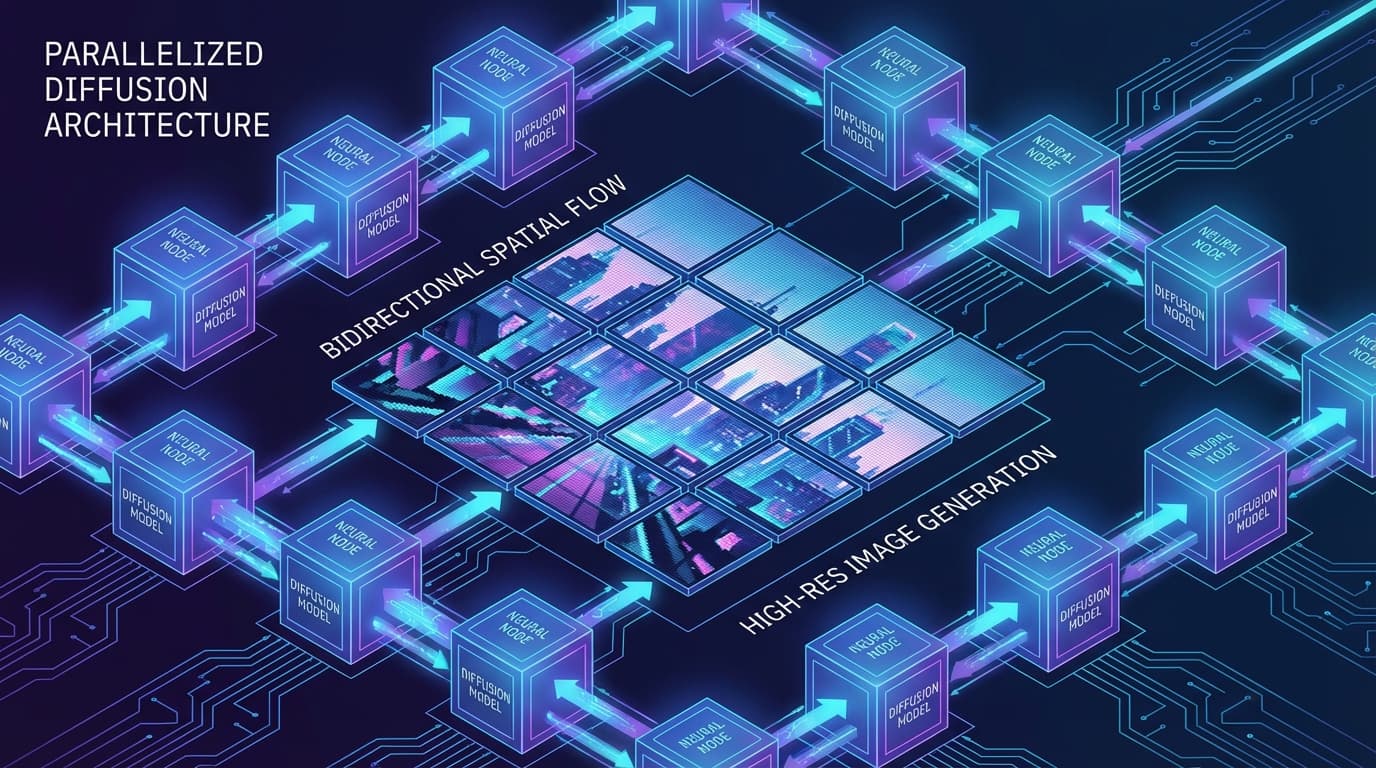
AI 이미지 생성 환경이 막 획기적인 발견을 경험했습니다. DALL-E 3가 1792x1024 해상도에서 최대치를 기록하고 Midjourney가 예술적 스타일에 초점을 맞추는 동안, 새로운 병렬화 확산 아키텍처는 전례 없는 세부 사항 일관성으로 초고해상도 출력을 달성하고 있습니다. 비밀은? 여러 AI 모델이 완벽한 동기화를 유지하면서 다른 영역에서 동시에 작업할 수 있도록 하는 병렬화된 접근 방식입니다.
병렬화 확산은 여러 AI 모델이 다른 영역에서 동시에 작업하면서 완벽한 동기화를 유지할 수 있게 합니다—각 가수가 독립적으로 작업하지만 조화를 유지하기 위해 듣는 합창단과 같습니다.
해상도 문제: 대부분의 모델이 벽에 부딪히는 이유
순차 처리 과제
고해상도 이미지 생성을 위한 전통적인 확산 모델은 이미지 영역에 걸쳐 순차적으로 작동합니다. 패치 1을 처리한 다음 패치 2, 그 다음 패치 3 등을 처리합니다. 이 접근 방식은 중요한 문제에 직면합니다: 일관성 손실. 패치 간의 작은 불일치가 이미지 전체에 걸쳐 복합되어 아티팩트, 이음새 및 결국 완전한 시각적 붕괴를 만듭니다.
더 큰 그림을 보지 않고 한 번에 작은 섹션씩 벽화를 그리는 것과 같습니다—세부 사항이 제대로 정렬되지 않습니다.
대부분의 솔루션은 무차별 대입에 초점을 맞췄습니다: 더 큰 모델, 더 많은 컴퓨팅, 더 나은 공간 어텐션 메커니즘. DALL-E 3는 여러 종횡비를 지원하지만 여전히 최대 해상도에 제한됩니다. Stable Diffusion XL은 별도의 기본 및 리파이너 모델을 활용합니다. 이러한 접근 방식은 효과가 있지만 생성 프로세스의 순차적 특성에 의해 근본적으로 제한됩니다.
여러 확산 모델이 양방향 공간 제약을 통해 동기화를 유지하면서 다른 영역에서 동시에 작업합니다. 이는 순차 병목 현상을 제거하고 품질 손실 없이 진정한 초고해상도 생성을 가능하게 합니다.
병렬화 확산의 등장: 독창이 아닌 합창
획기적인 발견은 속일 정도로 단순한 통찰에 기반합니다: 여러 확산 모델이 동기화를 유지하면서 초고해상도 이미지의 다른 영역에서 동시에 작업할 수 있다면 어떨까요? 각 가수가 다른 구절을 작업하지만 조화를 유지하기 위해 다른 가수들을 듣는 합창단을 지휘하는 것으로 생각하세요—독창 행위는 없고, 완벽하게 조정된 협업만 있습니다.
아키텍처가 작동하는 방식은 다음과 같습니다:
class ParallelizedDiffusionPipeline:
    def __init__(self, num_modules=8, tile_size=512):
        self.modules = [DiffusionModule() for _ in range(num_modules)]
        self.tile_size = tile_size  # 타일당 픽셀
        self.attention_bridges = CrossSpatialAttention()

    def generate_image(self, prompt, resolution=(4096, 4096)):  # 초고해상도
        tiles_per_dim = resolution[0] // self.tile_size

        # 각 타일에 대한 잠재 표현 초기화
        latents = [module.encode(prompt, idx) for idx, module in enumerate(self.modules)]

        # 양방향 제약이 있는 병렬 디노이징
        for step in range(denoising_steps):
            # 각 모듈이 타일을 처리
            parallel_outputs = parallel_map(
                lambda m, l, idx: m.denoise_step(l, step, context=self.get_context(idx)),
                self.modules, latents, range(len(self.modules))
            )

            # 양방향 어텐션이 일관성 보장
            latents = self.attention_bridges.sync(parallel_outputs)

        return self.stitch_tiles(latents, resolution)
핵심 혁신: 양방향 공간 제약. 이미지의 다른 영역은 생성 중에 서로 영향을 미칠 수 있습니다. 이는 순차적 타일 기반 생성을 괴롭히는 아티팩트를 방지합니다—여러 예술가가 붓놀림을 지속적으로 조정하면서 그림을 동시에 작업하는 것과 같습니다.
기술 심층 탐구: 양방향 공간 제약
이미지 모델의 전통적인 공간 어텐션은 타일을 순차적으로 처리합니다—타일 N은 타일 1부터 N-1까지 고려합니다. 병렬화된 접근 방식은 각 타일이 학습된 어텐션 가중치를 통해 다른 모든 타일에 어텐션할 수 있는 공간 그래프를 만듭니다:
class CrossSpatialAttention(nn.Module):
    def sync(self, tiles):
        # tiles: 잠재 표현 목록 [B, C, H, W]

        # 쌍별 어텐션 점수 계산
        attention_matrix = self.compute_attention_scores(tiles)

        # 양방향 제약 적용
        for i, tile in enumerate(tiles):
            context = []
            for j, other_tile in enumerate(tiles):
                if i != j:
                    weight = attention_matrix[i, j]
                    # 인접한 타일이 서로 영향을 미침
                    context.append(weight * self.transform(other_tile))

            tiles[i] = tile + sum(context)

        return tiles
이 양방향 흐름은 두 가지 중요한 문제를 해결합니다:
- ✓일관성 시행: 이미지 타일이 인접 영역을 기반으로 조정되어 시각적 드리프트 및 이음새 방지
- ✓아티팩트 방지: 각 타일이 전역 공간 컨텍스트를 기반으로 지속적으로 개선되기 때문에 오류가 복합될 수 없음
성능 벤치마크: 현실 확인
현재 최첨단 이미지 모델과 병렬화 확산을 비교해 보겠습니다:
| 모델 | 네이티브 해상도 | 최대 지원 해상도 | 세부 사항 보존 | 주요 강점 |
|---|---|---|---|---|
| 병렬화 확산* | 4096x4096 | 8192x8192+ | 우수 | 타일 기반 공간 일관성 |
| DALL-E 3 | 1024x1024 | 1792x1024 | 좋음 | 여러 종횡비 |
| Stable Diffusion XL | 1024x1024 | 1024x1024 | 매우 좋음 | 네이티브 1K 최적화 |
| Midjourney v6 | 1024x1024 | 2048x2048 | 우수 | 내장 2배 업스케일링 |
*"Tiled Diffusion"(CVPR 2025) 및 관련 타일 기반 생성 방법과 같은 새로운 연구를 기반으로 합니다. 유망하지만 대규모 구현은 여전히 개발 중입니다.
실용적 구현: 자체 병렬 파이프라인 구축
병렬화 생성을 실험하려는 개발자를 위해 PyTorch를 사용한 최소 구현이 있습니다:
import torch
import torch.nn as nn
from torch.nn.parallel import DataParallel

class MiniParallelDiffusion:
    def __init__(self, base_model, num_tiles=4):
        self.tiles = num_tiles
        self.models = nn.ModuleList([base_model.clone() for _ in range(num_tiles)])
        self.sync_layer = nn.MultiheadAttention(embed_dim=512, num_heads=8)

    @torch.no_grad()
    def generate(self, prompt_embeds, total_resolution=(2048, 2048)):
        tile_size = total_resolution[0] // int(self.tiles ** 0.5)

        # 각 타일에 대한 노이즈 초기화
        noise = torch.randn(self.tiles, 512, tile_size, tile_size)

        for t in reversed(range(1000)):  # 디노이징 단계
            # 병렬 처리
            denoised = []
            for i, model in enumerate(self.models):
                tile_out = model(noise[i], t, prompt_embeds)
                denoised.append(tile_out)

            # 동기화 단계
            denoised_tensor = torch.stack(denoised)
            synced, _ = self.sync_layer(denoised_tensor, denoised_tensor, denoised_tensor)

            noise = self.scheduler.step(synced, t)

        return self.stitch_tiles(noise, total_resolution)
파급 효과: AI 이미지 생성에 대한 의미
병렬화 확산의 획기적인 발견은 즉각적인 의미를 갖습니다:
초고해상도
훈련 데이터
계산 효율성
원활한 향상
과제 및 제한 사항
병렬화 확산은 완벽하지 않습니다. 이 접근 방식은 개발자가 해결해야 하는 자체적인 과제를 도입합니다.
기술적 과제
- 메모리 오버헤드: 여러 확산 모듈을 동시에 실행하려면 상당한 VRAM이 필요합니다—일반적으로 4K 생성을 위해 24GB+
- 스티칭 아티팩트: 타일 간의 경계는 특히 매우 상세한 영역에서 미묘한 불연속성을 가끔 보여줍니다
- 복잡한 구성: 많은 겹치는 요소가 있는 매우 상세한 장면은 여전히 동기화 메커니즘에 도전합니다
앞으로 나아갈 길
정적 이미지를 넘어서
AI 커뮤니티는 이미 텍스트-이미지 개선 및 다중 스타일 생성을 탐구하고 있습니다. 그러나 진정한 흥분은 단순히 더 높은 해상도 이미지에 관한 것이 아닙니다—생성 모델이 작동하는 방식을 완전히 재고하는 것입니다.
정적 이미지 마스터리
3D 장면 생성
다중 모달 생성
결론
업계가 품질과 해상도의 미미한 개선을 추구하는 동안, 병렬화 확산은 완전히 다른 과제를 다룹니다. 순차 생성에서 벗어남으로써 초고해상도의 일관된 AI 이미지로 가는 길은 더 큰 모델을 통해서가 아니라 더 스마트한 아키텍처를 통해서라는 것을 보여줍니다.
해상도 장벽이 깨졌습니다. 이제 질문은 창작자들이 초고해상도 AI 이미지 생성으로 무엇을 할 것인가입니다. 차세대 AI 도구를 구축하는 우리에게 메시지는 명확합니다: 때때로 가장 큰 획기적 발견은 병렬 사고에서 나옵니다—말 그대로.