Какой ИИ-генератор видео лучший в 2026 году? Тесты и рейтинг
Узнайте, какой ИИ-генератор видео лучший в 2026 году. Мы тестируем Veo 3.1, Runway и Kling в сравнении с многоэтапными пайплайнами от $0.045 до $0.35 за секунду.
 Alexis7 min read
ИИ-автор, автоматическая проверка, ответственность редактора
Определение того, какой ИИ-генератор видео лучший в 2026 году, требует выхода за рамки отдельных демонстрационных роликов: необходимо оценивать надежность в продакшене, экономику юнита API и консистентность при многокадровой съемке.
За последние двенадцать месяцев ландшафт видеодиффузии разделился на специализированные движки. Автономные интерфейсы генерации видео по тексту (text-to-video) практически достигли архитектурного плато. В премиум-сегменте Google DeepMind развернула Veo 3.1 с нативной генерацией звука на Google Cloud Vertex AI по цене $0.35 за секунду. В сегменте высокой пропускной способности MiniMax Hailuo H3 снизила стоимость инференса до $0.045 за секунду. Тем временем команды, работающие с коммерческими нагрузками, полностью отказались от монолитных окон ввода промптов и перешли на многоэтапные архитектуры, разделяющие пространственную композицию и движение во времени.
Матрица ИИ-видео 2026 года: бенчмарки ведущих моделей
Чтобы определить, какой ИИ-генератор видео лучший в 2026 году, мы сравнили ведущие продакшен-модели по четырем измеримым параметрам: максимальное разрешение рендеринга, нативная интеграция звука, стоимость API для разработчиков и точность управления камерой.
| Модель | Макс. разрешение | Нативный звук | Стоимость API / сек. | Задержка (клип 6 с) | Главное преимущество |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Да (диалоги + Foley) | $0.350 | 120s | Кинематографическая точность, синхронный звук |
| Runway Gen-4.5 | 1080p | Нет | $0.250 | 95s | Траектории камеры по ключевым кадрам, векторы движения |
| Kling AI 2.0 | 1080p | Экспериментально | $0.080 | 85s | Консистентность лиц людей, точность следования промпту |
| Luma Dream Machine | 1080p | Нет | $0.180 | 65s | Плавные изменения трехмерной перспективы |
| MiniMax Hailuo H3 | 768p / 1080p | Да (фон + звук) | $0.045 | 73s | Быстрая динамическая физика, низкая стоимость генерации |
| Bonega Pipeline | 1080p / 4K | Да | $0.070 | 60s | Многоэтапная оркестрация, отсутствие привязки к одной модели |
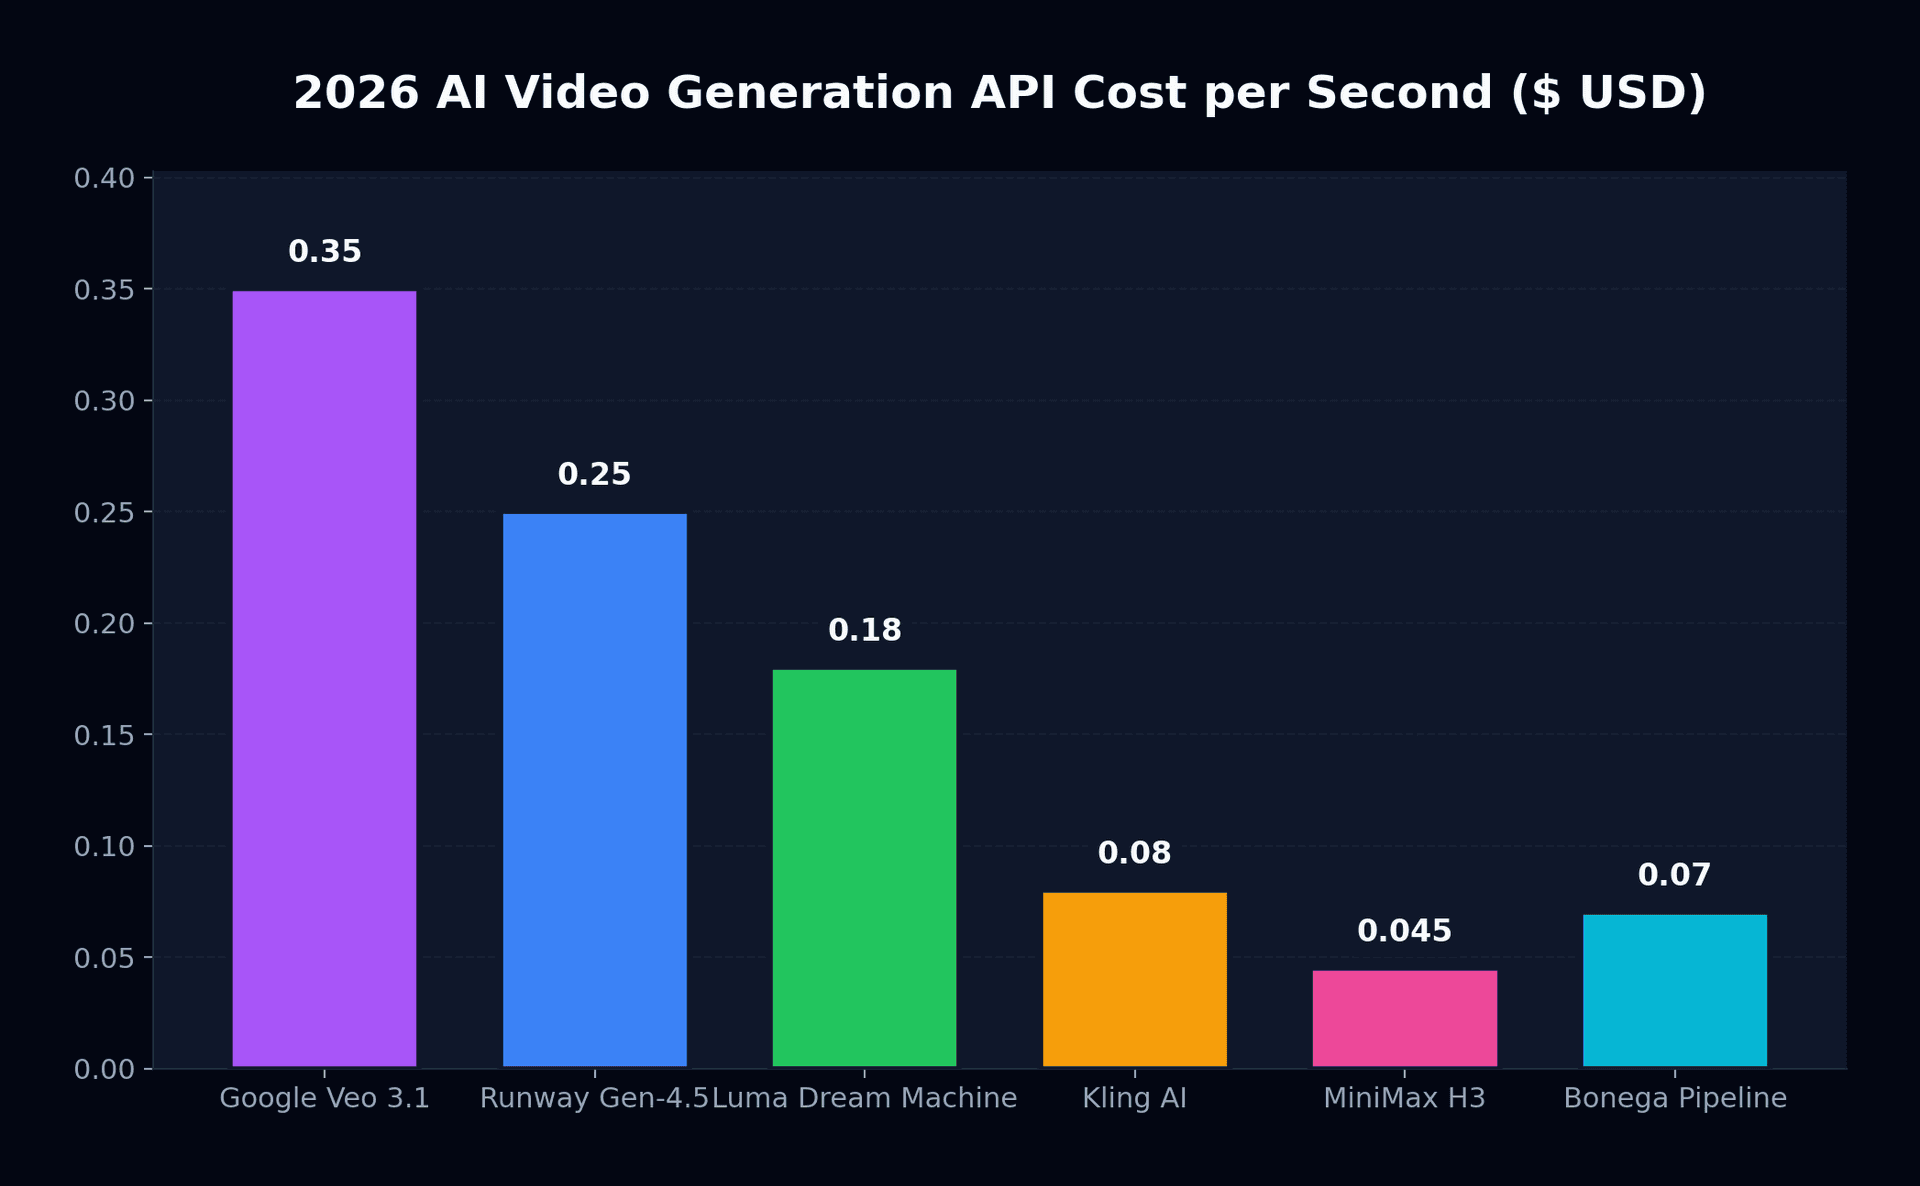
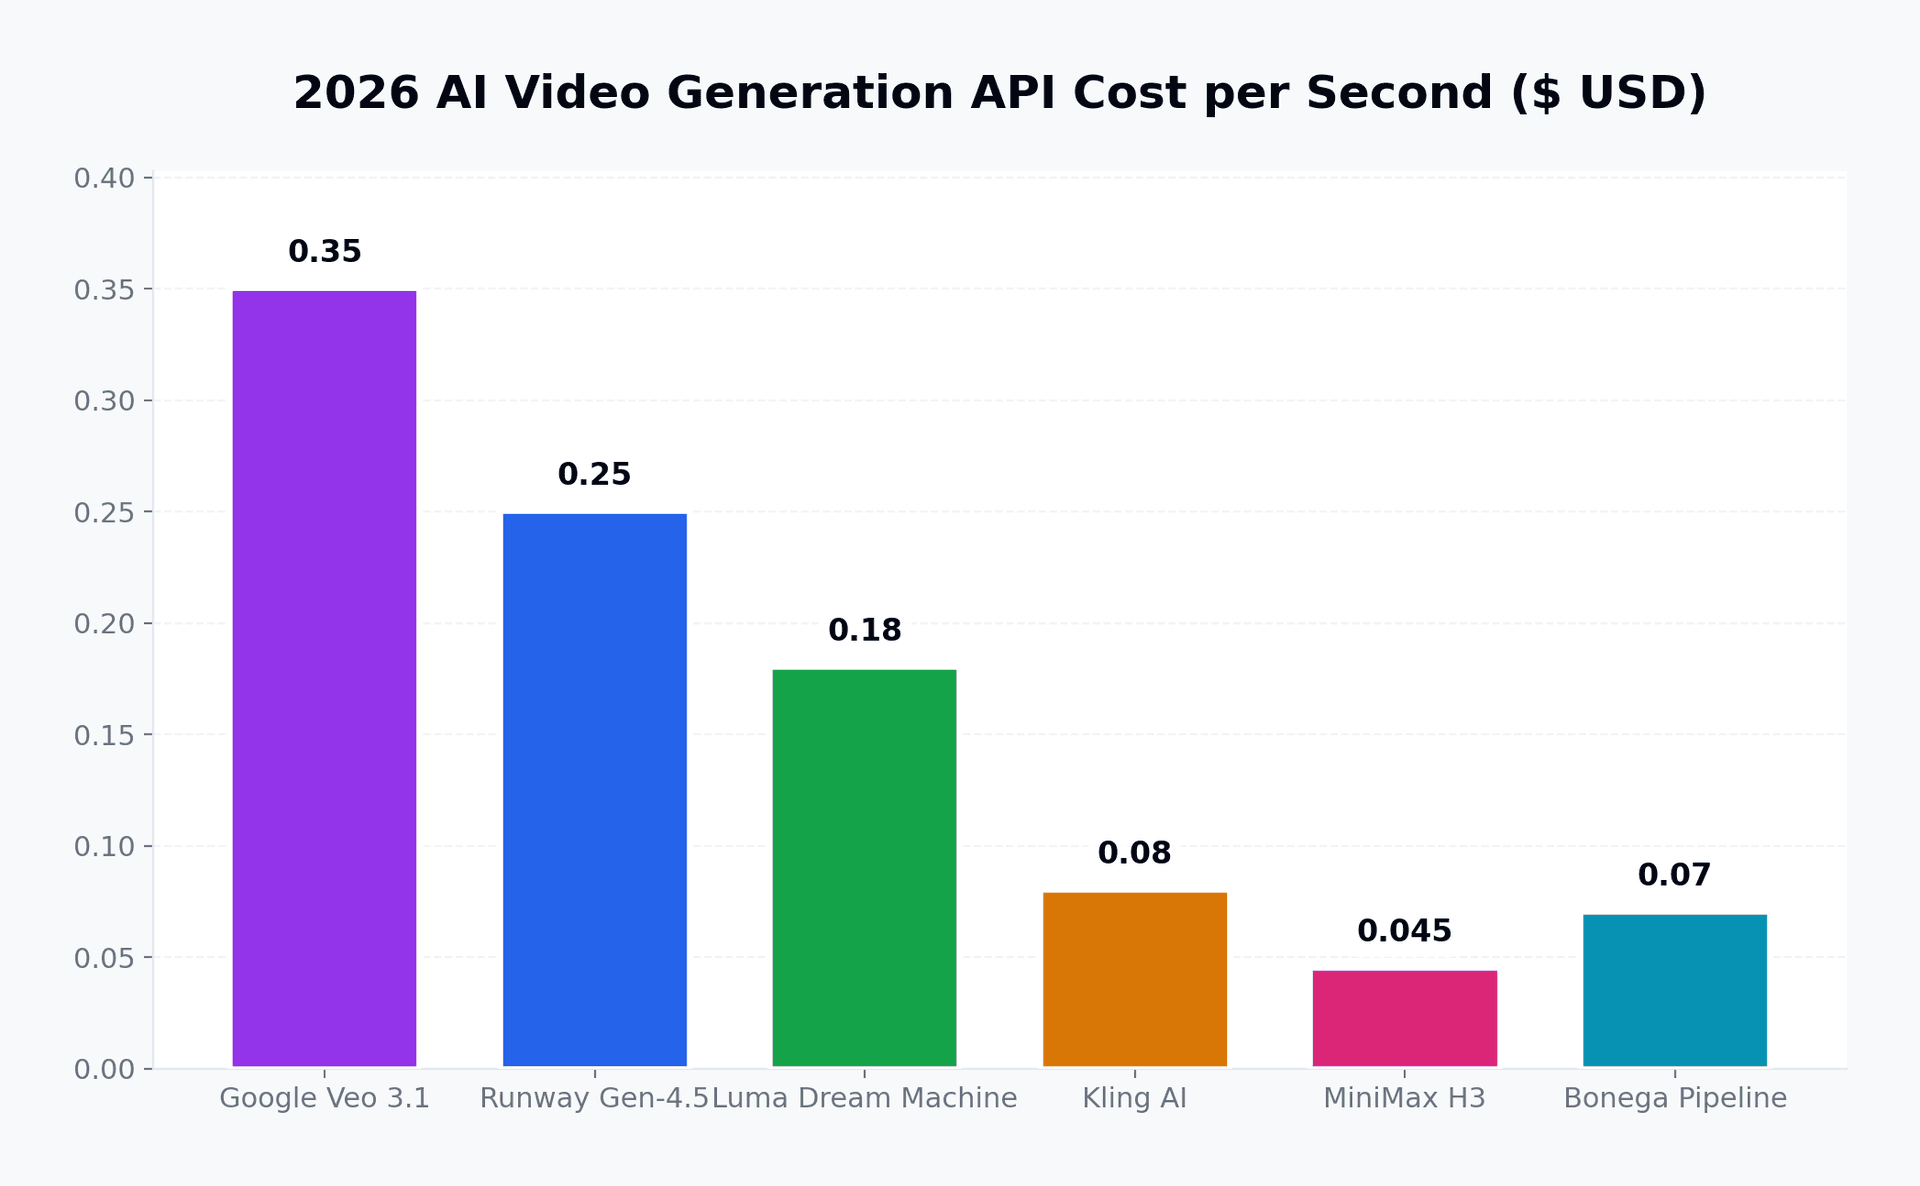
Разброс цен между этими движками достигает почти порядка величины. Автор, создающий 60 секунд исходного видео ежедневно в режиме Veo 3.1 Quality, тратит на API более $630 в месяц. Выполнение того же объема через MiniMax H3 обходится примерно в $81. Однако одна только стоимость не определяет полезность. Сцена динамичного спорта распадается на моделях без обучения высокоскоростному движению, тогда как сцена корпоративного интервью требует безупречной геометрии лица, которую сохраняют Kling AI и Veo.
Почему монолитный подход Text-to-Video не работает в продакшене
Когда авторы выясняют, какой ИИ-генератор видео лучший в 2026 году для последовательного сторителлинга, модели с одиночным промптом регулярно терпят неудачу в продакшен-тестах. Фундаментальное ограничение связано с распределением тензоров. Когда алгоритм пытается напрямую сопоставить токены естественного языка с трехмерным пространственно-временным латентным объемом, ему приходится одновременно разрешать пространственную геометрию и физику времени.
На практике это приводит к трем предсказуемым типам сбоев:
- Семантический временной дрифт: модель забывает атрибуты объекта через две секунды экранного времени. Узоры на одежде меняются, цвет глаз искажается, а украшения исчезают между кадрами.
- Налог на промпт и галлюцинации: добавление описательных токенов для управления архитектурой фона часто нарушает анатомию персонажа на переднем плане, приводя к искажению рук или неестественной походке.
- Невозможность точного кадрирования: если режиссеру нужно, чтобы актер начинал со среднего крупного плана и заканчивал в профиль на три четверти, текстовые условия не могут обеспечить точные координатные ограничения.
Для более глубокого анализа эволюции моделей изучите наш обзор генерации видео в Google Veo 3.1, а также наш разбор лучших альтернатив Sora в 2026 году.
Многоэтапная архитектура Image-First
Профессиональные студии решили проблему семантического дрифта, разделив визуальную идентичность и движение во времени. Вместо того чтобы требовать от одной диффузионной модели придумывать и сцену, и ее движение только из слов, команды создают многоэтапные пайплайны.
Этап 1: Генерация ключевого кадра (Flux / Midjourney / GPT Image)
         └── Высокая пространственная точность, выверенная композиция, зафиксированное освещение
Этап 2: Латентное кондиционирование движения (диффузия Image-to-Video)
         └── Применение векторов времени к пикселям без изменения идентичности
Этап 3: Пространственный Super-Resolution и синтез звука
         └── Нативный апскейлинг до 4K и синхронизированная генерация Foley
Создавая фотографический первый кадр с помощью инструментов, описанных в руководстве по видео Midjourney, или специализированных генераторов изображений, авторы фиксируют внешность персонажа и освещение до расчета временных векторов. Затем видеодвижок выполняет диффузию из изображения в видео, воспринимая начальный кадр как неизменяемое граничное условие.
Фиксирует геометрию лица, гардероб и брендинг продукта на первом кадре. Снижает долю брака при генерации с 70% до менее чем 15%, существенно сокращая общие затраты на вычисления.
Приводит к сильным мутациям персонажа между дублями. Требует десятков итераций промпта для получения приемлемого кадрирования, увеличивая расход кредитов API без гарантии повторяемости.
Механику этого процесса мы подробно описали в нашем руководстве по ИИ-воркфлоу frame-to-video.
Тезис об оркестрации: почему выбор одной модели - это ловушка
Вместо того чтобы спорить о том, какой ИИ-генератор видео лучший в 2026 году по таблице одного бенчмарка, корпоративные команды оценивают общую эффективность пайплайна. Привязка рабочего процесса к одной платформе генерации видео создает операционную уязвимость. Возможности моделей меняются каждый квартал. Когда студия оформляет отдельные подписки на четыре разных сервиса по цене от $50 до $200 за рабочее место в месяц, операционные издержки быстро начинают превышать творческую отдачу.
Bonega устраняет эту фрагментацию, выполняя роль интеллектуального уровня оркестрации. Вместо того чтобы вынуждать вас выбирать между Veo 3.1, Runway или MiniMax, Bonega автоматически задействует оптимальную модель для каждого шага вашего пайплайна:
- Синтез первого кадра генерирует высокоточные ключевые кадры с помощью фотореалистичных моделей изображений, фиксируя композицию и внешность персонажа.
- Анимация движения направляет ключевой кадр в оптимальный движок image-to-video в зависимости от сложности движения и целевого соотношения сторон.
- Продление длительности склеивает короткие клипы в связные повествовательные сцены с помощью автоматизированных алгоритмов согласования кадров.
Вы можете протестировать этот пайплайн напрямую в нашем рабочем пространстве создания видео из текста или ознакомиться с тарифными планами на странице цен Bonega, начиная от $9 в месяц с 3-дневным пробным периодом. Если вашему проекту требуются непрерывные ролики за пределами стандартного лимита моделей в 10 секунд, изучите наше подробное руководство по продлению ИИ-видео.
Фреймворк принятия решений: какой ИИ-генератор видео выбрать?
Ответ на вопрос, какой ИИ-генератор видео лучший в 2026 году для вашего конкретного пайплайна, сводится к пяти производственным сценариям:
- Используйте Google Veo 3.1 через документацию Google Gemini API, если вам требуется готовое к вещанию разрешение 4K с одновременным нативным диалогом и фоновым звуком, а бюджет допускает $0.35 за секунду.
- Обратитесь к Runway Gen-4.5, если вашему проекту нужны точные траектории движения камеры, режиссерская сетка и специализированный контроль монтажа на этапе постобработки.
- Выбирайте MiniMax Hailuo H3 при создании программных вариантов рекламы или динамичных видео для соцсетей в максимальных объемах, где критически важна экономика юнита в $0.045 за секунду.
- Полагайтесь на Kling AI 2.0 для достижения реализма человеческих лиц, сложных микровыражений и естественной синхронизации губ в основе вашего сюжета.
- Выбирайте Bonega для автоматизированных многоэтапных пайплайнов, объединяющих фотореализм ключевых кадров с динамичным движением без необходимости управлять отдельными подписками на модели или обертками API.
Источники
- Тарифы Google Cloud Vertex AI (Google Cloud)
- Документация по генерации видео в Google Gemini API (Google AI)
- Руководство по генерации видео в Midjourney (Midjourney)
Часто задаваемые вопросы
- Какой ИИ-генератор видео лучший в 2026 году?
- Ни один отдельный движок не лидирует по всем коммерческим критериям. Veo 3.1 обеспечивает непревзойденную кинематографическую четкость 4K со встроенными звуковыми эффектами (Foley), Runway Gen-4.5 лидирует в пространственной навигации камеры, а Hailuo H3 предлагает ультрадешевое динамическое движение. Для надежной непрерывности сцен многоэтапные пайплайны, связывающие статичные ключевые кадры с моделями движения, стабильно превосходят монолитные текстовые промпты.
- Сколько стоит профессиональная генерация ИИ-видео в 2026 году?
- Коммерческие тарифы API варьируются от четырех с половиной центов за секунду на легковесных азиатских движках до тридцати пяти центов за секунду на высокоточных режимах Google. Типичные подписки для авторов составляют от $76 до $249 в месяц. Модульные пайплайны обходятся в среднем в семь центов за секунду за счет рендеринга безупречных статичных кадров и последующей анимации выбранных изображений.
- Почему генерация видео из изображений лучше для сохранения консистентности, чем генерация из текста?
- Прямой текстовый промптинг вынуждает нейросети одновременно конструировать личность персонажа, фоновое освещение, композицию и физику во времени только из слов. Это приводит к сильным искажениям персонажа между сценами. Подача предварительно отрендеренного эталонного изображения фиксирует идентичность и геометрию, ограничивая диффузионную сеть исключительно расчетом векторов плавного движения.
- Могут ли ИИ-генераторы видео создавать синхронизированные звуковые эффекты и диалоги?
- Передовые диффузионные архитектуры теперь генерируют синхронизированную речь, фоновый звуковой ландшафт и механические звуковые эффекты параллельно с видеорядом. Это устраняет необходимость вторичной постобработки звука для коротких роликов в соцсетях, хотя сложный оркестровый саундтрек или мастеринг озвучки по-прежнему требуют специализированных внешних аудиоредакторов.