Vilken AI-videogenerator är bäst 2026? Testad och rankad
Upptäck vilken AI-videogenerator som är bäst 2026. Vi testar Veo 3.1, Runway och Kling mot flerstegspipelines från $0.045 till $0.35 per sekund.
 Alexis6 min read
AI-författare, automatiserade kontroller, ansvarig redaktör
Att avgöra vilken AI-videogenerator som är bäst 2026 kräver att man blickar bortom isolerade benchmark-klipp för att utvärdera produktionspålitlighet, enhetsekonomi för API:er och kontinuitet över flera tagningar.
Under de senaste tolv månaderna har landskapet för videodiffusion splittrats i specialiserade motorer. Fristående text-till-video-gränssnitt har i stort sett nått en arkitektonisk platå. I toppskiktet lanserade Google DeepMind Veo 3.1 med inbyggd ljudgenerering på Google Cloud Vertex AI för $0.35 per sekund. I segmentet för hög genomströmning sänkte MiniMax Hailuo H3 inferenspriserna till $0.045 per sekund. Samtidigt har produktionsteam som kör kommersiella arbetsflöden helt övergett monolitiska promptfält och anammat flerstegsarkitekturer som separerar rumslig komposition från tidsmässig rörelse.
AI-videomatrisen 2026: Riktmärken för ledande modeller
För att avgöra vilken AI-videogenerator som är bäst 2026 jämförde vi de ledande produktionsmodellerna över fyra mätbara dimensioner: maximal renderingsupplösning, inbyggd ljudintegrering, prissättning för utvecklar-API och precision i kamerakontroll.
| Modell | Max upplösning | Inbyggt ljud | API-kostnad / sek | Latens (6s-klipp) | Främsta styrka |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Ja (dialog + Foley) | $0.350 | 120s | Filmisk kvalitet, synkroniserat ljud |
| Runway Gen-4.5 | 1080p | Nej | $0.250 | 95s | Kamerabanor med keyframes, rörelsevektorer |
| Kling AI 2.0 | 1080p | Experimentell | $0.080 | 85s | Ansiktskontinuitet för människor, promptföljsamhet |
| Luma Dream Machine | 1080p | Nej | $0.180 | 65s | Flytande 3D-perspektivskiften |
| MiniMax Hailuo H3 | 768p / 1080p | Ja (omgivningsljud + effekter) | $0.045 | 73s | Snabb dynamisk fysik, låg genereringskostnad |
| Bonega Pipeline | 1080p / 4K | Ja | $0.070 | 60s | Flerstegsorkestrering, ingen modellinlåsning |
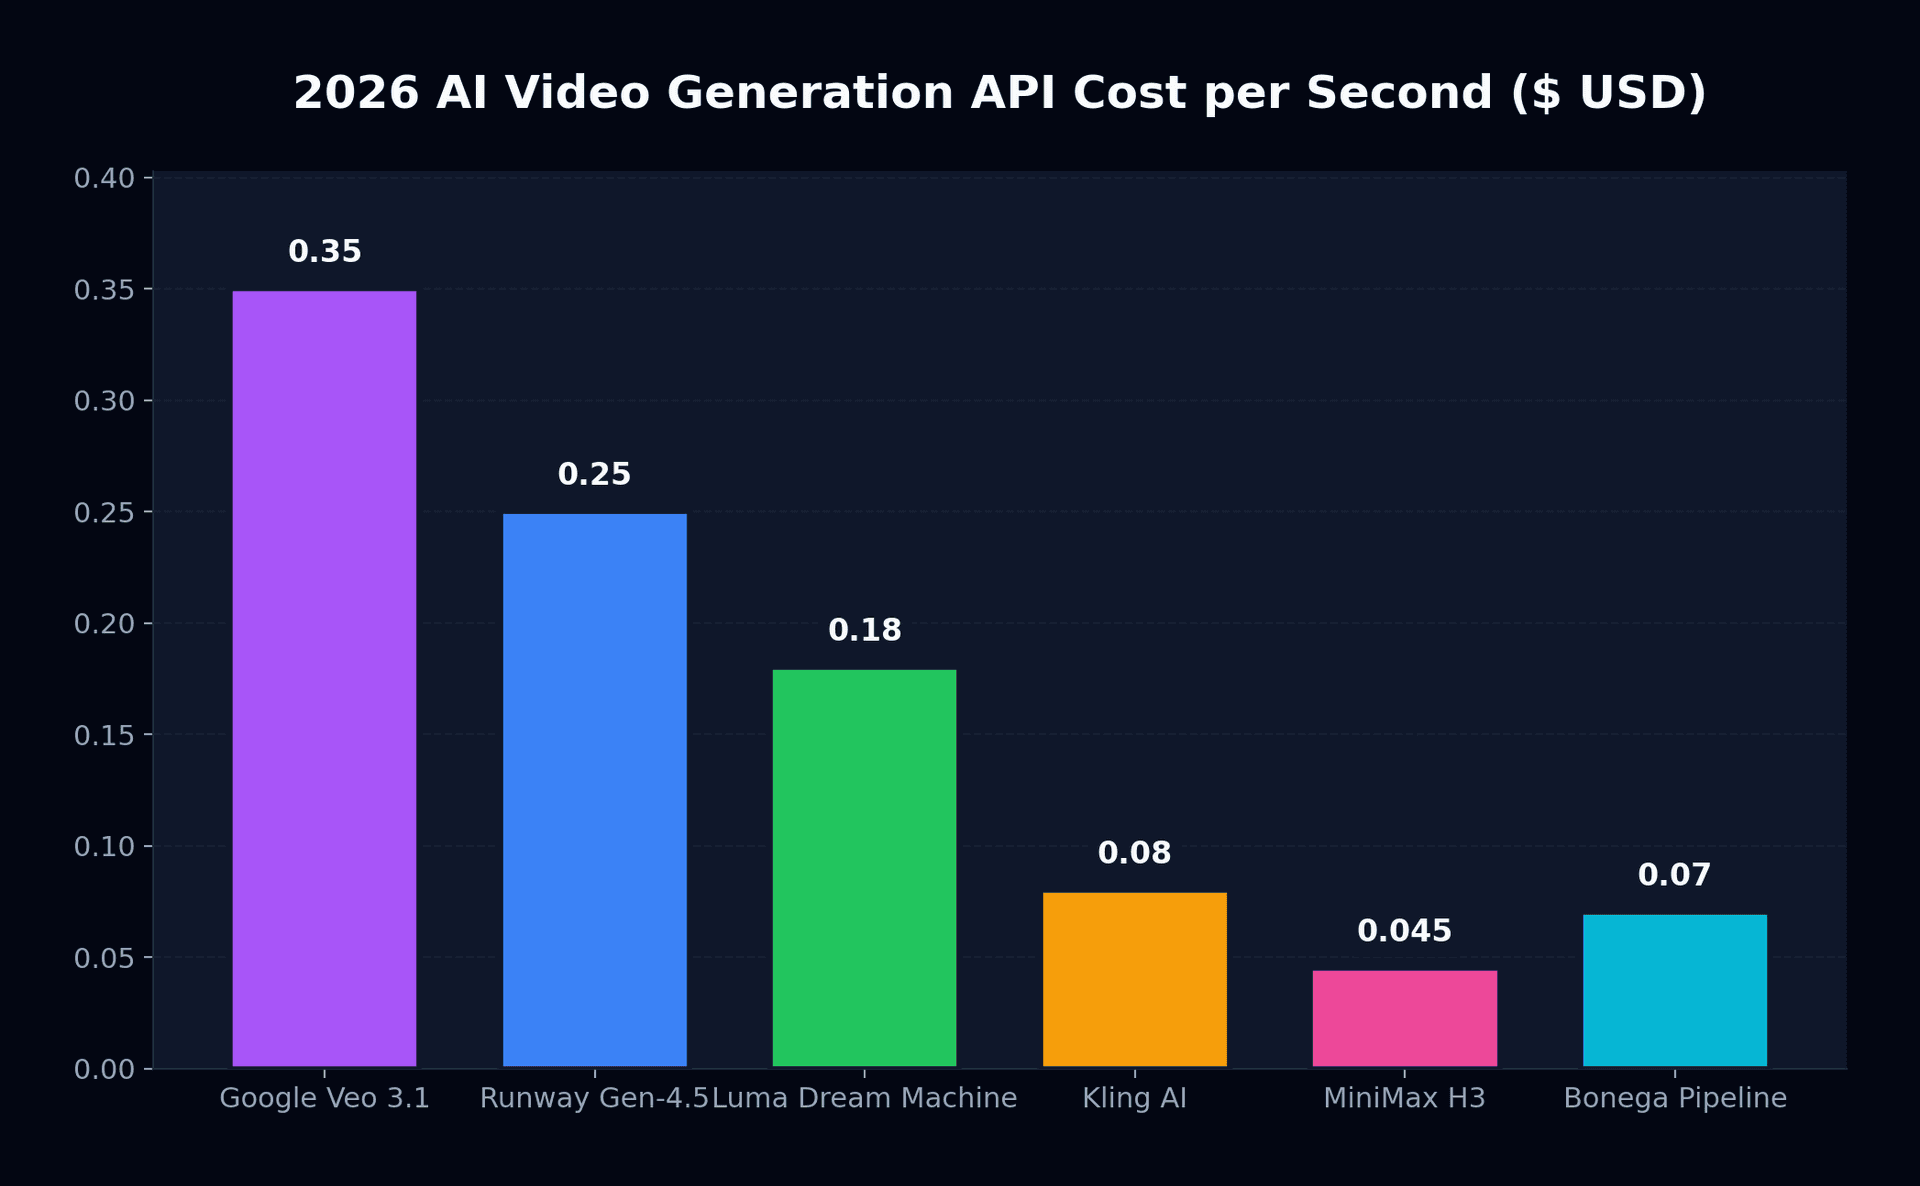
Priserna mellan dessa motorer varierar med nästan en tiopotens. En kreatör som genererar sextio sekunder råvideo dagligen med Veo 3.1 i Quality-läge möter en månatlig API-kostnad som överstiger $630. Att köra samma volym genom MiniMax H3 kostar cirka $81. Men enbart kostnaden avgör inte användbarheten. En fartfylld actionsekvens inom sport havererar på modeller som saknar träning på snabba tidsmässiga rörelser, medan en företagsintervjuscen kräver den felfria ansiktsgeometri som Kling AI och Veo bevarar.
Varför monolitisk text-till-video misslyckas i produktion
När kreatörer undersöker vilken AI-videogenerator som är bäst 2026 för sammanhängande berättande, misslyckas modeller baserade på enstaka prompter regelbundet under produktionstester. Den grundläggande begränsningen handlar om tensorallokering. När en algoritm försöker mappa naturliga språktokens direkt till en tredimensionell rums-tids-latent volym måste den hantera rumslig geometri och tidsmässig fysik samtidigt.
I praktiken orsakar detta tre förutsägbara fellägen:
- Semantisk tidsdrift: Modellen glömmer bort motivets egenskaper efter två sekunder på skärmen. Klädmönster förändras, ögonfärg ändras och smycken försvinner mellan bildrutor.
- Promptbörda och hallucinationer: Att lägga till beskrivande tokens för att styra bakgrundsarkitektur försämrar ofta förgrundsfigurens anatomi, vilket ger förvrängda händer eller onaturliga gångmönster.
- Omöjligheten att få exakt inramning: Om en regissör kräver att en skådespelare börjar i en halvbild och slutar i en trekvartsprofil i helbild kan textvillkor inte genomdriva exakta koordinatbegränsningar.
För djupare analys av modellutvecklingen, utforska vår genomgång av videogenerering med Google Veo 3.1 tillsammans med vår analys av de bästa Sora-alternativen 2026.
Den bildcentrerade flerstegsarkitekturen
Professionella studior löste semantisk drift genom att frikoppla visuell identitet från tidsmässig rörelse. I stället för att be en enskild diffusionsmodell att uppfinna både scenen och dess rörelse från ord, bygger team flerstegspipelines.
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
         └── Native 4K upscaling and synchronized Foley generation
Genom att generera en fotografisk första bildruta med hjälp av verktyg som dokumenteras i riktlinjer för video i Midjourney eller specialiserade bildgeneratorer låser kreatörer karaktärsidentitet och ljussättning innan tidsvektorer beräknas. Videomotorn utför sedan bild-till-video-diffusion och behandlar den ursprungliga bildrutan som ett oföränderligt randvillkor.
Låser ansiktsgeometri, klädsel och produktvarumärke från första bildrutan. Minskar kasseringsgraden vid generering från 70% till under 15%, vilket kraftigt minskar de totala beräkningskostnaderna för produktionen.
Lider av allvarliga karaktärsmutationer mellan tagningar. Kräver dussintals promptiterationer för att uppnå acceptabel inramning, vilket multiplicerar API-kreditförbrukningen utan att garantera repeterbarhet.
Vi dokumenterade mekaniken i detta arbetsflöde i vår detaljerade guide om arbetsflöden för bild-till-video-AI.
Orkestreringshypotesen: Varför det är en fälla att välja en enda modell
I stället för att stirra sig blind på vilken AI-videogenerator som är bäst 2026 på en enskild benchmark-topplista utvärderar företagsteam den totala pipeline-effektiviteten. Att binda upp sitt arbetsflöde till en enda plattform för videogenerering skapar operativ sårbarhet. Modellers förmågor förändras varje kvartal. När en studio prenumererar individuellt på fyra olika tjänster för $50 till $200 per användare varje månad överstiger de operativa omkostnaderna snabbt det kreativa resultatet.
Bonega löser denna fragmentering genom att fungera som ett intelligent orkestreringslager. I stället för att tvinga dig att välja mellan Veo 3.1, Runway eller MiniMax distribuerar Bonega automatiskt den optimala modellen för varje steg i din pipeline:
- Syntes av första bildrutan genererar högkvalitativa keyframes med hjälp av fotorealistiska bildmodeller, vilket låser komposition och karaktärsidentitet.
- Rörelseanimering dirigerar keyframen till den optimala bild-till-video-motorn baserat på rörelsens komplexitet och önskat bildförhållande.
- Längdförlängning sammanfogar korta klipp till sammanhängande narrativsekvenser via automatiserade algoritmer för bildrutematchning.
Du kan testa denna pipeline direkt genom att besöka vår arbetsyta för text-till-video-skapande, eller granska planerna på Bonegas prissida, med start från $9 per månad och en 3-dagars provperiod. Om ditt projekt kräver sammanhängande klipp utöver standardtaken på tio sekunder per modell, se vår omfattande guide för att förlänga AI-video.
Beslutsramverk: Vilken AI-videogenerator ska du välja?
Att avgöra vilken AI-videogenerator som är bäst 2026 för just din specifika pipeline kokar ner till fem distinkta produktionsscenarier:
- Använd Google Veo 3.1 via Google Gemini API-dokumentationen om du behöver sändningsklar 4K-upplösning med samtidig inbyggd dialog och omgivningsljud, och din budget tillåter $0.35 per sekund.
- Vänd dig till Runway Gen-4.5 om ditt projekt kräver precisa kamerarörelsebanor, regissörsrutnät och specialiserad redigeringskontroll för efterproduktion.
- Välj MiniMax Hailuo H3 när du bygger programmatiska annonsvariationer eller actionfylld video för sociala medier i maximal volym, där enhetsekonomin på $0.045 per sekund är avgörande.
- Förlita dig på Kling AI 2.0 för mänsklig ansiktsrealism, intrikata mikrouttryck och naturlig läppsynk i kärnan av din berättelse.
- Välj Bonega för att få automatiserade flerstegspipelines som kombinerar fotorealism i keyframes med dynamisk rörelse, vilket eliminerar behovet av att hantera enskilda modellabonnemang eller API-omslag.
Källor
- Prissättning för Google Cloud Vertex AI (Google Cloud)
- Dokumentation för videogenerering med Google Gemini API (Google AI)
- Riktlinjer för videogenerering i Midjourney (Midjourney)
Vanliga frågor
- Vilken AI-videogenerator är bäst 2026?
- Ingen enskild motor leder över alla kommersiella kriterier. Veo 3.1 levererar oöverträffad filmisk 4K-skärpa med inbyggda Foley-ljudeffekter, Runway Gen-4.5 leder inom rumslig kameranavigering och Hailuo H3 erbjuder ultrabillig dynamisk rörelse. För pålitlig scensekvenskontinuitet överträffar flerstegspipelines som kopplar stillbilds-keyframes till rörelsemodeller konsekvent monolitiska prompter.
- Hur mycket kostar professionell AI-videogenerering 2026?
- Kommersiella API-priser sträcker sig från fyra och en halv cent per sekund för lätta asiatiska motorer upp till trettiofem cent per sekund för Googles lägen med hög återgivning. Typiska kreatörsabonnemang varierar mellan $76 och $249 per månad. Modulära pipelines snittar på sju cent per sekund genom att rendera orörda stillbilder och animera utvalda bildrutor.
- Varför är bild-till-video bättre än text-till-video för kontinuitet?
- Direkta textprompter tvingar neurala nätverk att samtidigt skapa karaktärsidentitet, bakgrundsbelysning, komposition och tidsmässig fysik från ord. Detta skapar allvarliga karaktärsdeformationer mellan klipp. Att mata in en förrenderad referensbild förankrar identitet och geometri, vilket begränsar diffusionsnätverket enbart till att beräkna flytande rörelsevektorer.
- Kan AI-videogeneratorer producera synkroniserade ljudeffekter och dialog?
- Avancerade diffusionsarkitekturer genererar nu synkroniserat tal, omgivande ljudlandskap och mekaniskt Foley-ljud i tandem med visuella bildrutor. Denna funktion eliminerar sekundär efterproduktion av ljud för korta sociala tillgångar, även om intrikat orkestermusik eller efterbearbetning av voiceover fortfarande förlitar sig på dedikerade externa ljudredigeringsprogram.