Kỷ Nguyên Phim Câm Khép Lại: Khả Năng Tạo Âm Thanh Tự Nhiên Thay Đổi Video AI Mãi Mãi
Tạo video AI vừa bước từ kỷ nguyên phim câm sang thời kỳ phim có tiếng. Khám phá cách tổng hợp âm thanh - video tự nhiên đang định hình lại quy trình sáng tạo, với lời thoại đồng bộ, không gian âm thanh xung quanh và hiệu ứng âm thanh được tạo ra song song cùng hình ảnh.
 Henry12 min read
Tác giả AI, kiểm tra tự động, biên tập viên chịu trách nhiệm
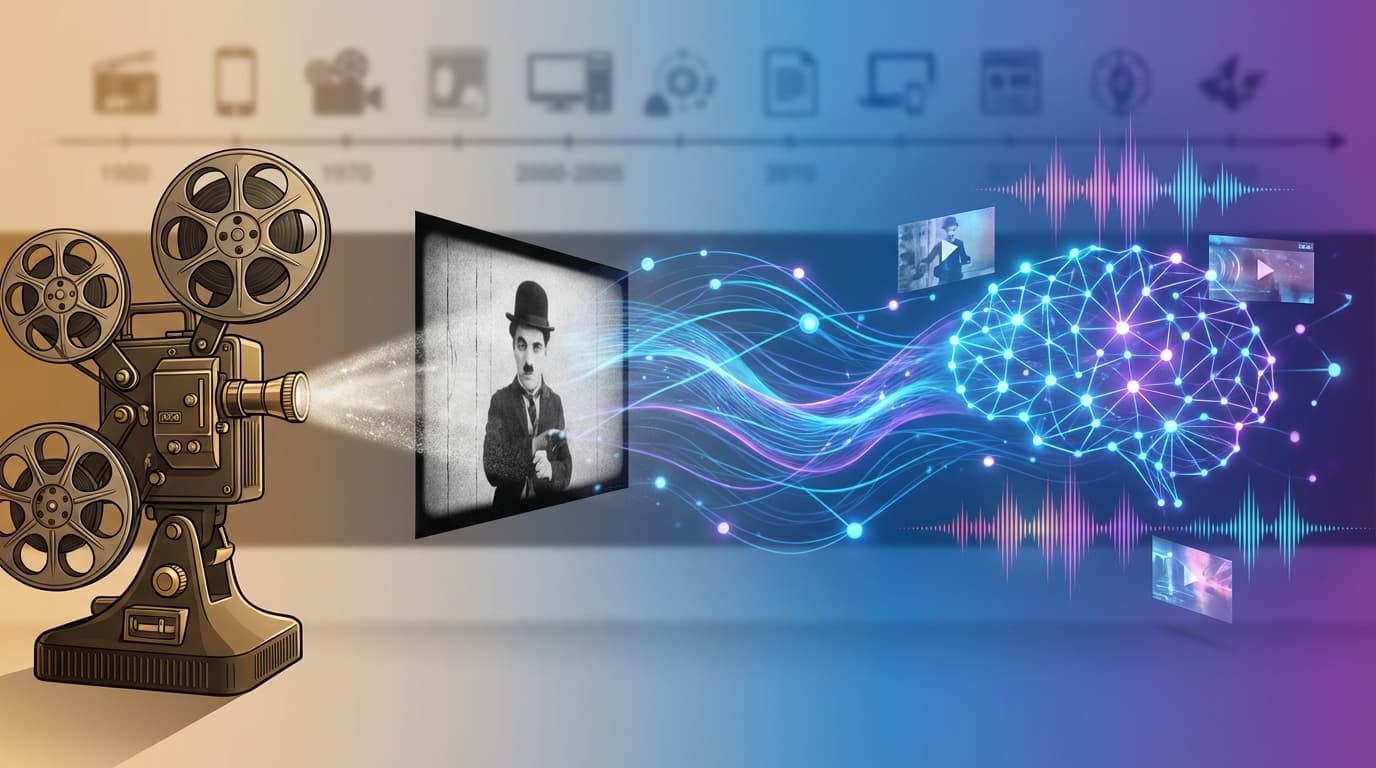
Bạn có nhớ cảm giác xem những bộ phim cũ của Charlie Chaplin không? Những cử chỉ phóng đại, tiếng đàn piano đệm theo, những tấm bảng phụ đề lời thoại? Trong vài năm qua, tạo video AI đã bị mắc kẹt trong kỷ nguyên phim câm của riêng mình. Chúng ta có thể tạo ra hình ảnh tuyệt đẹp từ văn bản, cảnh quan đô thị lúc hoàng hôn, các nhân vật khiêu vũ, những dải ngân hà bùng nổ, nhưng tất cả lại diễn ra trong sự tĩnh lặng đến rợn người. Chúng ta phải ghép âm thanh vào sau đó, hy vọng tiếng bước chân ăn khớp, mong sao cử động môi khớp lời.
Kỷ nguyên đó vừa chính thức khép lại.
Từ Cơn Ác Mộng Hậu Kỳ Đến Khả Năng Tổng Hợp Tự Nhiên
Bước nhảy vọt kỹ thuật ở đây thực sự đáng kinh ngạc. Các quy trình làm việc trước đây thường diễn ra như thế này:
- Tạo video từ câu lệnh
- Xuất các khung hình
- Mở phần mềm âm thanh
- Tìm hoặc tạo hiệu ứng âm thanh
- Đồng bộ hóa thủ công mọi thứ
- Cầu nguyện rằng kết quả trông không quá tệ
Bây giờ thì sao? Mô hình tạo ra âm thanh và video cùng nhau, trong một quy trình duy nhất. Không phải là các luồng riêng biệt được ghép nối lại, mà là dữ liệu hợp nhất chuyển động qua cùng một không gian tiềm ẩn (latent space).
# The old way: separate generation, manual sync
video = generate_video(prompt)
audio = generate_audio_separately(prompt)
result = sync_audio_video(video, audio)  # Good luck!

# The new way: unified generation
result = generate_audiovisual(prompt)  # Sound and vision, born together
Veo 3 của Google nén các biểu diễn âm thanh và video vào một không gian tiềm ẩn chung. Khi quá trình khuếch tán diễn ra, cả hai phương thức xuất hiện đồng thời: lời thoại, tiếng ồn xung quanh, hiệu ứng âm thanh, tất cả đều được căn chỉnh theo thời gian ngay từ thiết kế thay vì phải căn chỉnh sau đó.
Ý Nghĩa Thực Sự Của "Tự Nhiên" (Native)
Hãy để tôi giải thích chi tiết những gì đang diễn ra bên dưới, vì sự khác biệt này rất quan trọng.
| Cách tiếp cận | Nguồn âm thanh | Phương pháp đồng bộ | Chất lượng |
|---|---|---|---|
| Hậu kỳ (Post-hoc) | Mô hình/thư viện riêng biệt | Thủ công hoặc bằng thuật toán | Thường bị lệch |
| Hai giai đoạn (Two-stage) | Tạo sau video | Chú ý đa phương thức (Cross-modal attention) | Tốt hơn, nhưng còn lỗi giả lập |
| Tổng hợp tự nhiên (Native synthesis) | Cùng một không gian tiềm ẩn | Kế thừa từ quá trình tạo | Đồng bộ tự nhiên |
Tổng hợp tự nhiên có nghĩa là mô hình học mối quan hệ giữa các sự kiện thị giác và âm thanh trong quá trình huấn luyện. Một cánh cửa đóng sầm lại không phải là "hình ảnh cửa + âm thanh cửa". Đó là một sự kiện nghe nhìn thống nhất mà mô hình biểu diễn một cách toàn diện.
Kết quả thực tế là gì? Độ chính xác khớp khẩu hình môi (lip-sync) dưới 120 mili giây đối với Veo 3, và Veo 3.1 rút ngắn con số đó xuống còn khoảng 10 mili giây. Mức độ đó thậm chí còn tốt hơn độ trễ của phần lớn webcam hiện nay.
Những Tiềm Năng Sáng Tạo Phi Thường
Các tiềm năng cho việc sáng tạo nội dung mang lại cảm giác hoàn toàn mới mẻ. Dưới đây là những điều bỗng chốc trở nên cực kỳ đơn giản:
Không Gian Âm Thanh Xung Quanh (Ambient Soundscapes): Tạo một cảnh đường phố mưa rơi và nó sẽ đi kèm với tiếng mưa, tiếng xe cộ xa xa, tiếng bước chân vọng lại. Mô hình hiểu rằng tiếng mưa rơi trên mái tôn kim loại phát ra âm thanh khác hẳn tiếng mưa rơi trên vỉa hè.
Lời Thoại Đồng Bộ: Nhập một đoạn hội thoại, bạn sẽ có các nhân vật trò chuyện với khẩu hình môi ăn khớp. Dù chưa hoàn hảo, đôi khi vẫn còn cảm giác thung lũng kỳ lạ (uncanny valley), nhưng chúng ta đã nhảy vọt từ mức "rõ ràng là giả" sang "thỉnh thoảng rất thuyết phục".
Hiệu Ứng Âm Thanh Vật Lý: Một quả bóng nảy phát ra đúng âm thanh của một quả bóng nảy. Kính vỡ phát ra đúng âm thanh của kính vỡ. Mô hình đã học được các đặc trưng âm học của các tương tác vật lý.
Prompt: "A barista steams milk in a busy coffee shop, customers chatting,
        espresso machine hissing, jazz playing softly in the background"

Output: 8 seconds of perfectly synchronized audio-visual experience
Không cần kỹ sư âm thanh. Không cần nghệ sĩ Foley. Không cần buổi hòa âm phối khí.
Khả Năng Hiện Tại Giữa Các Mô Hình
Bối cảnh đang dịch chuyển rất nhanh, và dưới đây là tình hình hiện tại:
Google Veo 3 / Veo 3.1
- Tạo âm thanh tự nhiên có hỗ trợ lời thoại
- Độ phân giải gốc 1080p ở tốc độ 24 fps
- Không gian âm thanh xung quanh mạnh mẽ
- Được tích hợp trong hệ sinh thái Gemini
- Tạo âm thanh - video đồng bộ
- Lên đến 60 giây có đồng bộ âm thanh (tổng cộng 90 giây)
- Khả dụng cho doanh nghiệp thông qua Azure AI Foundry
- Tương quan vật lý - âm thanh mạnh mẽ
Kuaishou Kling 2.1
- Nhất quán đa phân cảnh kèm âm thanh
- Thời lượng lên đến 2 phút
- Hơn 45 triệu người sáng tạo đang sử dụng nền tảng
MiniMax Hailuo 02
- Kiến trúc Tái phân bổ tính toán nhận biết tiếng ồn (Noise-Aware Compute Redistribution)
- Tuân thủ hướng dẫn câu lệnh mạnh mẽ
- Quy trình tạo hiệu quả cao
"Vấn Đề Foley" Đang Dần Biến Mất
Một trong những điều tôi thích nhất ở sự chuyển dịch này là chứng kiến vấn đề Foley dần biến mất. Foley, nghệ thuật tạo ra các hiệu ứng âm thanh đời thường, đã là một nghề thủ công chuyên biệt trong suốt một thế kỷ. Thu âm tiếng bước chân, đập vỏ dừa giả tiếng móng ngựa, rung các tấm kim loại tạo tiếng gió rít.
Giờ đây mô hình chỉ đơn giản là... tự biết. Không phải thông qua các quy tắc hay thư viện, mà thông qua các mối quan hệ thống kê đã học được giữa các sự kiện thị giác và đặc trưng âm học của chúng.
Liệu nó có thay thế các nghệ sĩ Foley không? Đối với sản xuất phim điện ảnh cao cấp, có lẽ là chưa ngay lúc này. Nhưng đối với video YouTube, nội dung mạng xã hội, các bản dựng thử nghiệm nhanh? Chắc chắn rồi. Tiêu chuẩn chất lượng đã thay đổi một cách đáng kể.
Các Giới Hạn Kỹ Thuật Vẫn Còn Tồn Tại
Hãy thẳng thắn nhìn nhận những điểm vẫn chưa hoạt động tốt:
Các Đoạn Nhạc Phức Tạp: Tạo hình ảnh một nhân vật chơi piano với ngón tay bấm chính xác cùng âm thanh chuẩn từng nốt nhạc? Phần lớn vẫn chưa làm được. Mối tương quan hình ảnh - âm thanh cho một màn biểu diễn âm nhạc chuẩn xác là cực kỳ khó khăn.
Tính Nhất Quán Ở Định Dạng Dài: Chất lượng âm thanh có xu hướng bị lệch trong các lần tạo dài hơn. Âm thanh nền xung quanh có thể biến đổi bất thường ở mốc 15-20 giây ở một số mô hình.
Giọng Nói Lẫn Tiếng Ồn: Tạo lời thoại rõ ràng trong môi trường âm thanh phức tạp vẫn sinh ra các lỗi giả lập. Bài toán bữa tiệc cocktail (cocktail party problem) vẫn là một thách thức lớn.
Biến Thể Âm Thanh Theo Văn Hóa: Các mô hình được huấn luyện chủ yếu dựa trên nội dung phương Tây thường gặp khó khăn với các đặc trưng âm học theo vùng miền. Các dấu hiệu về độ vang, mô hình âm thanh môi trường xung quanh và các chỉ dấu âm thanh văn hóa của những môi trường phi phương Tây chưa được ghi nhận một cách hiệu quả.
Điều Này Có Ý Nghĩa Gì Đối Với Người Sáng Tạo
Nếu bạn đang làm nội dung video, quy trình làm việc của bạn sắp thay đổi một cách căn bản. Một số dự đoán:
Nội dung hoàn thành nhanh sẽ thậm chí còn nhanh hơn. Các video mạng xã hội trước đây cần kỹ sư âm thanh nay có thể được tạo từ đầu đến cuối chỉ trong vài phút. Đối với nội dung dài hơn nữa, hãy xem cách CraftStory tạo ra các video nhất quán dài 5 phút.
Tạo nguyên mẫu thử nghiệm (Prototyping) trở nên nhanh hơn đáng kể. Giới thiệu một ý tưởng bằng các đoạn video nghe nhìn hoàn chỉnh thay vì bảng phân cảnh phác thảo (storyboard) và nhạc nền tạm thời.
Khả năng tiếp cận được cải thiện. Những người sáng tạo không có kỹ năng sản xuất âm thanh vẫn có thể tạo ra nội dung với thiết kế âm thanh chất lượng chuyên nghiệp.
Giá trị kỹ năng chuyển dịch từ khâu thực thi sang khâu hình thành ý tưởng. Việc nhận biết âm thanh nào nghe hay sẽ quan trọng hơn việc biết cách làm cho nó nghe hay.
Sự Kỳ Lạ Về Mặt Triết Học
Đây là phần khiến tôi phải suy nghĩ trăn trở nhiều đêm: những mô hình này thực chất chưa từng "nghe" bất cứ thứ gì. Chúng chỉ học các quy luật thống kê giữa biểu diễn thị giác và dạng sóng âm thanh. Thế nhưng chúng lại tạo ra những âm thanh mang lại cảm giác chân thực, khớp với kỳ vọng của chúng ta về cách thế giới xung quanh sẽ phát ra âm thanh.
Liệu đó có phải là sự thấu hiểu? Hay đó là sự khớp mẫu tinh vi đến mức không thể phân biệt được với sự thấu hiểu? Tôi không có câu trả lời dứt khoát, nhưng tôi thấy câu hỏi này cực kỳ hấp dẫn.
Mô hình tạo ra âm thanh của một ly rượu vang khi vỡ vụn vì nó đã học mối tương quan từ hàng triệu ví dụ, chứ không phải vì nó hiểu cơ học thủy tinh hay vật lý âm học. Vậy mà kết quả nghe lại chuẩn xác theo một cách gần như không thể lý giải đơn thuần bằng số liệu thống kê.
Nơi Chúng Ta Đang Hướng Tới
Quỹ đạo phát triển dường như đã rất rõ ràng: thời lượng dài hơn, độ trung thực cao hơn, khả năng kiểm soát nhiều hơn. Đến giữa năm 2026, tôi kỳ vọng chúng ta sẽ thấy:
- Tạo âm thanh - video tự nhiên dài từ 5 phút trở lên
- Tạo theo thời gian thực cho các ứng dụng tương tác
- Kiểm soát âm thanh chi tiết (điều chỉnh riêng biệt âm lượng lời thoại, phong cách âm nhạc, mức độ âm thanh xung quanh)
- Chỉnh sửa đa phương thức (thay đổi hình ảnh, âm thanh sẽ tự động cập nhật)
Khoảng cách giữa việc tưởng tượng ra một điều gì đó và hiện thực hóa nó thành một nội dung nghe nhìn hoàn chỉnh đang thu hẹp lại. Đối với người sáng tạo, điều đó vừa hồi hộp vừa đáng sợ. Có lẽ là cả hai.
Hãy Tự Mình Trải Nghiệm
Cách tốt nhất để hiểu được sự chuyển dịch này là tự mình trải nghiệm. Hầu hết các mô hình đều cung cấp các gói miễn phí hoặc bản dùng thử:
- Google AI Studio: Tiếp cận các khả năng của Veo 3 thông qua Gemini
- Sora trong ChatGPT: Khả dụng cho người đăng ký gói Plus và Pro
- Kling: Truy cập web trên nền tảng của họ
- Runway Gen-4: Có sẵn API và giao diện web
Để xem phân tích so sánh chi tiết về các công cụ này, hãy xem bài phân tích so sánh Sora 2 vs Runway vs Veo 3 của chúng tôi.
Hãy bắt đầu đơn giản. Tạo một đoạn clip ngắn 4 giây về thứ gì đó có âm thanh rõ ràng: một quả bóng nảy, mưa rơi trên cửa sổ, ai đó đang vỗ tay. Hãy để ý xem âm thanh khớp với hình ảnh ra sao mà không cần bất kỳ sự can thiệp nào từ bạn.
Sau đó hãy thử một điều gì đó phức tạp hơn. Một khu chợ đông đúc. Một cơn dông bão đang kéo đến. Một cuộc trò chuyện giữa hai người.
Bạn sẽ cảm nhận được khoảnh khắc mọi thứ bừng sáng, khi nhận ra rằng chúng ta không còn chỉ đang tạo ra video nữa. Chúng ta đang tạo ra những trải nghiệm.
Kỷ nguyên phim câm đã kết thúc. Thời đại phim có tiếng đã chính thức gõ cửa.