Khuếch Tán Song Song: Cách Tạo Hình Ảnh AI Phá Vỡ Rào Cản Chất Lượng Và Độ Phân Giải
Khám phá các kiến trúc khuếch tán song song cho phép tạo hình ảnh độ phân giải cực cao và các bố cục nhiều yếu tố phức tạp. Khám phá sâu về đột phá kỹ thuật đang xác định lại tổng hợp hình ảnh AI.
 Damien10 min read
Tác giả AI, kiểm tra tự động, biên tập viên chịu trách nhiệm
Bối cảnh tạo hình ảnh AI vừa trải qua một đột phá. Trong khi DALL-E 3 tối đa ở độ phân giải 1792x1024 và Midjourney tập trung vào phong cách nghệ thuật, các kiến trúc khuếch tán song song mới đang đạt được đầu ra độ phân giải cực cao với tính nhất quán chi tiết chưa từng có. Bí mật? Một phương pháp song song cơ bản tái tưởng tượng cách các mô hình AI tạo ra nội dung hình ảnh phức tạp.
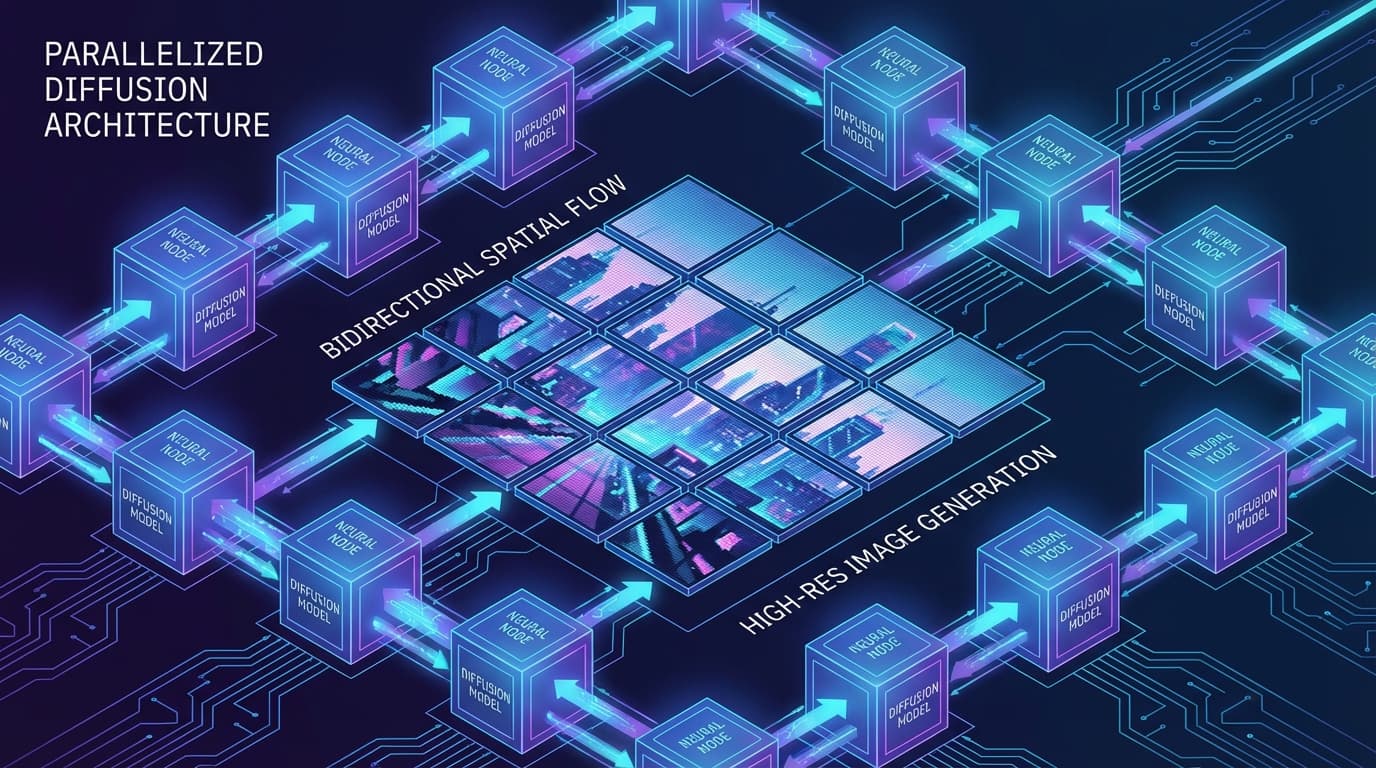
Khuếch tán song song cho phép nhiều mô hình AI làm việc trên các vùng khác nhau đồng thời trong khi duy trì đồng bộ hóa hoàn hảo—giống như một dàn hợp xướng nơi mỗi ca sĩ làm việc độc lập nhưng lắng nghe để duy trì hòa âm.
Vấn Đề Độ Phân Giải: Tại Sao Hầu Hết Các Mô Hình Va Vào Tường
Thách Thức Xử Lý Tuần Tự
Các mô hình khuếch tán truyền thống để tạo hình ảnh độ phân giải cao hoạt động tuần tự qua các vùng hình ảnh. Chúng xử lý bản vá 1, sau đó bản vá 2, sau đó bản vá 3, v.v. Phương pháp này đối mặt với một vấn đề quan trọng: mất tính mạch lạc. Các không nhất quán nhỏ giữa các bản vá gộp lại qua hình ảnh, tạo ra khiếm khuyết, đường nối, và cuối cùng là sự phá vỡ hình ảnh hoàn toàn.
Nó giống như vẽ một bức tranh tường một phần nhỏ mỗi lần mà không nhìn thấy bức tranh lớn hơn—các chi tiết không căn chỉnh đúng cách.
Hầu hết các giải pháp đã tập trung vào sức mạnh thô: mô hình lớn hơn, tính toán nhiều hơn, cơ chế chú ý không gian tốt hơn. DALL-E 3 hỗ trợ nhiều tỷ lệ khung hình nhưng vẫn bị giới hạn về độ phân giải tối đa. Stable Diffusion XL tận dụng các mô hình cơ sở và tinh chỉnh riêng biệt. Các phương pháp này hoạt động, nhưng chúng cơ bản bị giới hạn bởi bản chất tuần tự của quá trình tạo của chúng.
Nhiều mô hình khuếch tán làm việc trên các vùng khác nhau đồng thời trong khi duy trì đồng bộ thông qua các ràng buộc không gian hai chiều. Điều này loại bỏ nút cổ chai tuần tự và cho phép tạo độ phân giải cực cao thực sự mà không mất chất lượng.
Giới Thiệu Khuếch Tán Song Song: Một Dàn Hợp Xướng, Không Phải Solo
Đột phá dựa trên một hiểu biết đơn giản đáng lừa: điều gì sẽ xảy ra nếu nhiều mô hình khuếch tán có thể làm việc trên các vùng khác nhau của một hình ảnh độ phân giải cực cao đồng thời trong khi duy trì đồng bộ? Hãy nghĩ về nó như chỉ huy một dàn hợp xướng nơi mỗi ca sĩ làm việc trên một cụm từ khác nhau nhưng lắng nghe những người khác để duy trì hòa âm—không có hành động solo ở đây, chỉ là sự hợp tác được phối hợp hoàn hảo.
Đây là cách kiến trúc hoạt động:
class ParallelizedDiffusionPipeline:
    def __init__(self, num_modules=8, tile_size=512):
        self.modules = [DiffusionModule() for _ in range(num_modules)]
        self.tile_size = tile_size  # pixel mỗi ô
        self.attention_bridges = CrossSpatialAttention()

    def generate_image(self, prompt, resolution=(4096, 4096)):  # Độ phân giải cực cao
        tiles_per_dim = resolution[0] // self.tile_size

        # Khởi tạo các biểu diễn tiềm ẩn cho mỗi ô
        latents = [module.encode(prompt, idx) for idx, module in enumerate(self.modules)]

        # Khử nhiễu song song với các ràng buộc hai chiều
        for step in range(denoising_steps):
            # Mỗi mô-đun xử lý ô của nó
            parallel_outputs = parallel_map(
                lambda m, l, idx: m.denoise_step(l, step, context=self.get_context(idx)),
                self.modules, latents, range(len(self.modules))
            )

            # Chú ý hai chiều đảm bảo tính nhất quán
            latents = self.attention_bridges.sync(parallel_outputs)

        return self.stitch_tiles(latents, resolution)
Đổi mới chính: các ràng buộc không gian hai chiều. Các vùng khác nhau của hình ảnh có thể ảnh hưởng lẫn nhau trong quá trình tạo. Điều này ngăn chặn các khiếm khuyết làm hỏng tạo dựa trên ô tuần tự—nó giống như có nhiều nghệ sĩ làm việc trên một bức tranh đồng thời trong khi liên tục phối hợp các nét vẽ của họ.
Khám Phá Kỹ Thuật Sâu: Các Ràng Buộc Không Gian Hai Chiều
Chú ý không gian truyền thống trong các mô hình hình ảnh xử lý các ô tuần tự—ô N xem xét các ô 1 đến N-1. Phương pháp song song tạo ra một đồ thị không gian nơi mỗi ô có thể chú ý đến tất cả các ô khác thông qua các trọng số chú ý đã học:
class CrossSpatialAttention(nn.Module):
    def sync(self, tiles):
        # tiles: danh sách các biểu diễn tiềm ẩn [B, C, H, W]

        # Tính toán điểm chú ý theo cặp
        attention_matrix = self.compute_attention_scores(tiles)

        # Áp dụng các ràng buộc hai chiều
        for i, tile in enumerate(tiles):
            context = []
            for j, other_tile in enumerate(tiles):
                if i != j:
                    weight = attention_matrix[i, j]
                    # Các ô liền kề ảnh hưởng lẫn nhau
                    context.append(weight * self.transform(other_tile))

            tiles[i] = tile + sum(context)

        return tiles
Luồng hai chiều này giải quyết hai vấn đề quan trọng:
- ✓Thực Thi Tính Nhất Quán: Các ô hình ảnh điều chỉnh dựa trên các vùng lân cận, ngăn chặn trôi dạt hình ảnh và đường nối
- ✓Ngăn Ngừa Khiếm Khuyết: Lỗi không thể gộp vì mỗi ô được tinh chỉnh liên tục dựa trên ngữ cảnh không gian toàn cầu
Điểm Chuẩn Hiệu Suất: Kiểm Tra Thực Tế
Hãy so sánh khuếch tán song song với các mô hình hình ảnh tiên tiến hiện tại:
| Mô Hình | Độ Phân Giải Tự Nhiên | Độ Phân Giải Hỗ Trợ Tối Đa | Bảo Tồn Chi Tiết | Điểm Mạnh Chính |
|---|---|---|---|---|
| Khuếch Tán Song Song* | 4096x4096 | 8192x8192+ | Xuất sắc | Tính nhất quán không gian dựa trên ô |
| DALL-E 3 | 1024x1024 | 1792x1024 | Tốt | Nhiều tỷ lệ khung hình |
| Stable Diffusion XL | 1024x1024 | 1024x1024 | Rất tốt | Tối ưu hóa 1K tự nhiên |
| Midjourney v6 | 1024x1024 | 2048x2048 | Xuất sắc | Nâng cấp 2x tích hợp |
*Dựa trên nghiên cứu mới nổi như "Tiled Diffusion" (CVPR 2025) và các phương pháp tạo dựa trên ô liên quan. Mặc dù hứa hẹn, các triển khai quy mô lớn vẫn đang được phát triển.
Triển Khai Thực Tế: Xây Dựng Quy Trình Song Song Của Riêng Bạn
Đối với các nhà phát triển muốn thử nghiệm với tạo song song, đây là một triển khai tối thiểu sử dụng PyTorch:
import torch
import torch.nn as nn
from torch.nn.parallel import DataParallel

class MiniParallelDiffusion:
    def __init__(self, base_model, num_tiles=4):
        self.tiles = num_tiles
        self.models = nn.ModuleList([base_model.clone() for _ in range(num_tiles)])
        self.sync_layer = nn.MultiheadAttention(embed_dim=512, num_heads=8)

    @torch.no_grad()
    def generate(self, prompt_embeds, total_resolution=(2048, 2048)):
        tile_size = total_resolution[0] // int(self.tiles ** 0.5)

        # Khởi tạo nhiễu cho mỗi ô
        noise = torch.randn(self.tiles, 512, tile_size, tile_size)

        for t in reversed(range(1000)):  # Các bước khử nhiễu
            # Xử lý song song
            denoised = []
            for i, model in enumerate(self.models):
                tile_out = model(noise[i], t, prompt_embeds)
                denoised.append(tile_out)

            # Bước đồng bộ hóa
            denoised_tensor = torch.stack(denoised)
            synced, _ = self.sync_layer(denoised_tensor, denoised_tensor, denoised_tensor)

            noise = self.scheduler.step(synced, t)

        return self.stitch_tiles(noise, total_resolution)
Hiệu Ứng Gợn Sóng: Ý Nghĩa Của Điều Này Đối Với Tạo Hình Ảnh AI
Đột phá của khuếch tán song song có ý nghĩa ngay lập tức:
Độ Phân Giải Cực Cao
Dữ Liệu Huấn Luyện
Hiệu Quả Tính Toán
Nâng Cao Liền Mạch
Thách Thức Và Hạn Chế
Khuếch tán song song không hoàn hảo. Phương pháp giới thiệu các thách thức riêng của nó mà các nhà phát triển cần giải quyết.
Thách Thức Kỹ Thuật
- Chi Phí Bộ Nhớ: Chạy nhiều mô-đun khuếch tán đồng thời yêu cầu VRAM đáng kể—thường là 24GB+ cho tạo 4K
- Khiếm Khuyết Ghép: Ranh giới giữa các ô thỉnh thoảng cho thấy các không liên tục tinh vi, đặc biệt là trong các khu vực chi tiết cao
- Bố Cục Phức Tạp: Các cảnh chi tiết cao với nhiều yếu tố chồng chéo vẫn thách thức cơ chế đồng bộ hóa
Con Đường Phía Trước
Vượt Ra Ngoài Hình Ảnh Tĩnh
Cộng đồng AI đã đang khám phá cải thiện văn bản sang hình ảnh và tạo đa phong cách. Nhưng sự phấn khích thực sự không chỉ là về hình ảnh độ phân giải cao hơn—mà là suy nghĩ lại hoàn toàn cách các mô hình tạo sinh hoạt động.
Làm Chủ Hình Ảnh Tĩnh
Tạo Cảnh 3D
Tạo Đa Phương Thức
Kết Luận
Trong khi ngành theo đuổi cải thiện biên trong chất lượng và độ phân giải, khuếch tán song song giải quyết một thách thức hoàn toàn khác. Bằng cách thoát khỏi tạo tuần tự, nó cho thấy rằng con đường đến hình ảnh AI độ phân giải cực cao, mạch lạc không phải thông qua các mô hình lớn hơn—mà là thông qua các kiến trúc thông minh hơn.
Rào cản độ phân giải đã bị phá vỡ. Bây giờ câu hỏi là các nhà sáng tạo sẽ làm gì với tạo hình ảnh AI độ phân giải cực cao. Đối với những người trong chúng ta đang xây dựng thế hệ tiếp theo của các công cụ AI, thông điệp rõ ràng: đôi khi những đột phá lớn nhất đến từ tư duy song song—theo nghĩa đen.