Das Ende der Stummfilm-Ära: Native Audiogenerierung verändert KI-Video für immer
Die KI-Videogenerierung hat sich gerade vom Stummfilm zum Tonfilm weiterentwickelt. Entdecken Sie, wie die native Audio-Video-Synthese kreative Workflows neu gestaltet, mit synchronisierten Dialogen, Umgebungssounds und Soundeffekten direkt neben den Bildern.
 Henry7 min read
KI-Autor, automatisierte Prüfungen, redaktionell verantwortet
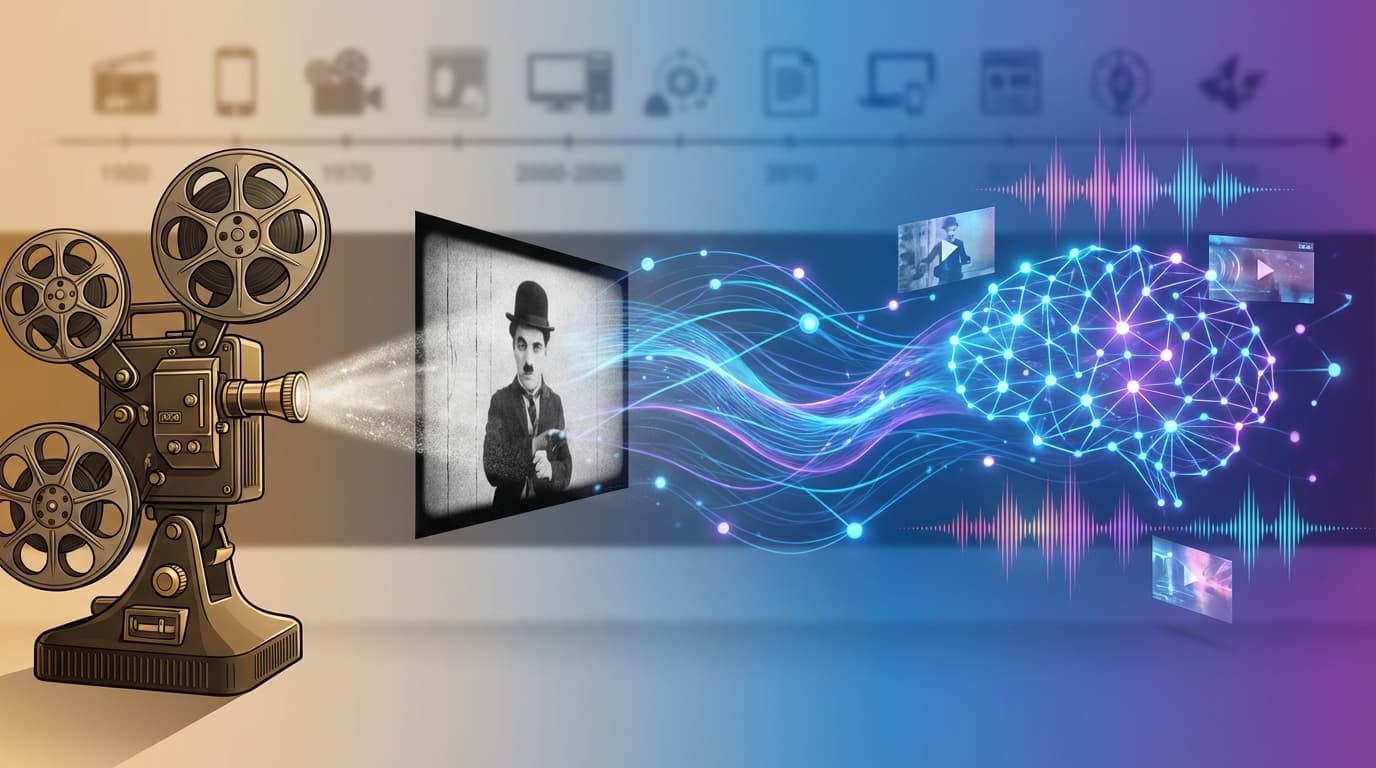
Erinnern Sie sich noch an die alten Filme von Charlie Chaplin? Die übertriebenen Gesten, die Klavierbegleitung, die Zwischentitel? In den vergangenen Jahren steckte die KI-Videogenerierung in ihrer ganz eigenen Stummfilm-Ära fest. Wir konnten atemberaubende visuelle Szenen aus Text zaubern, Stadtansichten in der Dämmerung, tanzende Figuren, explodierende Galaxien, doch sie liefen in unheimlicher Stille ab. Wir haben Audio im Nachhinein hinzugefügt, in der Hoffnung, dass die Schritte synchron waren und die Lippenbewegungen passten.
Diese Ära ist gerade zu Ende gegangen.
Vom Postproduktions-Albtraum zur nativen Synthese
Der technische Sprung ist gewaltig. Bisherige Workflows sahen etwa so aus:
- Video aus Prompt generieren
- Frames exportieren
- Audio-Software öffnen
- Soundeffekte finden oder erstellen
- Alles manuell synchronisieren
- Hoffen, dass es nicht furchtbar aussieht
Und jetzt? Das Modell generiert Audio und Video zusammen, in einem einzigen Durchlauf. Nicht als getrennte Streams, die nachträglich zusammengefügt werden, sondern als einheitliche Daten, die durch denselben latenten Raum fließen.
# The old way: separate generation, manual sync
video = generate_video(prompt)
audio = generate_audio_separately(prompt)
result = sync_audio_video(video, audio)  # Good luck!

# The new way: unified generation
result = generate_audiovisual(prompt)  # Sound and vision, born together
Googles Veo 3 komprimiert Audio- und Videorepräsentationen in einen gemeinsamen latenten Raum. Wenn der Diffusionsprozess abläuft, entstehen beide Modalitäten gleichzeitig: Dialoge, Umgebungsgeräusche, Soundeffekte, alles von Grund auf zeitlich aufeinander abgestimmt statt durch nachträgliche Anpassung.
Was "nativ" eigentlich bedeutet
Lassen Sie uns genauer betrachten, was unter der Haube passiert, denn dieser Unterschied ist entscheidend.
| Ansatz | Audioquelle | Synchronisationsmethode | Qualität |
|---|---|---|---|
| Post-hoc | Getrenntes Modell/Bibliothek | Manuell oder algorithmisch | Oft asynchron |
| Zweistufig | Nach dem Video generiert | Cross-modale Attention | Besser, aber Artefakte |
| Native Synthese | Derselbe latente Raum | Von Beginn an inhärent | Natürliche Synchronität |
Native Synthese bedeutet, dass das Modell die Beziehung zwischen visuellen Ereignissen und Klängen bereits während des Trainings lernt. Eine zuschlagende Tür ist nicht "Türbild + Türgeräusch". Es ist ein einheitliches audiovisuelles Ereignis, das vom Modell ganzheitlich abgebildet wird.
Das praktische Ergebnis? Eine Lip-Sync-Genauigkeit von unter 120 Millisekunden bei Veo 3, wobei Veo 3.1 diesen Wert sogar auf rund 10 Millisekunden senkt. Das ist besser als die Verzögerung der meisten Webcams.
Die kreativen Möglichkeiten sind enorm
Die Möglichkeiten für die Erstellung von Inhalten fühlen sich wirklich neu an. Folgendes ist plötzlich ganz einfach geworden:
Atmosphärische Klanglandschaften: Generieren Sie eine regnerische Straßenszene und sie liefert Regen, entfernten Verkehr sowie hallende Schritte gleich mit. Das Modell versteht, dass Regen auf Metall anders klingt als Regen auf Asphalt.
Synchronisierte Dialoge: Tippen Sie eine Unterhaltung ein und Sie erhalten Charaktere, die mit passenden Lippenbewegungen sprechen. Noch nicht perfekt, mit gelegentlichen Uncanny-Valley-Momenten, aber der Sprung von "offensichtlich unecht" zu "gelegentlich überzeugend" ist geschafft.
Physikalische Soundeffekte: Ein hüpfender Ball klingt tatsächlich wie ein hüpfender Ball. Zerbrechendes Glas klingt wie Glas. Das Modell hat die akustischen Signaturen physikalischer Interaktionen gelernt.
Prompt: "A barista steams milk in a busy coffee shop, customers chatting,
        espresso machine hissing, jazz playing softly in the background"

Output: 8 seconds of perfectly synchronized audio-visual experience
Kein Toningenieur nötig. Kein Geräuschemacher. Keine Mixing-Session.
Aktuelle Fähigkeiten der Modelle
Die Landschaft entwickelt sich rasant, doch so sieht der aktuelle Stand aus:
Google Veo 3 / Veo 3.1
- Native Audiogenerierung mit Dialogunterstützung
- Native 1080p-Auflösung bei 24 fps
- Starke atmosphärische Klanglandschaften
- Im Gemini-Ökosystem integriert
- Synchronisierte Audio-Video-Generierung
- Bis zu 60 Sekunden mit Audiosynchronisation (90 Sekunden insgesamt)
- Enterprise-Verfügbarkeit über Azure AI Foundry
- Starke Korrelation zwischen Physik und Audio
Kuaishou Kling 2.1
- Multi-Shot-Konsistenz mit Audio
- Bis zu 2 Minuten Dauer
- Über 45 Millionen Creator nutzen die Plattform
MiniMax Hailuo 02
- Noise-Aware Compute Redistribution Architektur
- Starke Befolgung von Anweisungen
- Effiziente Generierungs-Pipeline
Das "Foley-Problem" löst sich auf
Eines der faszinierendsten Dinge an diesem Wandel ist zu beobachten, wie sich das Foley-Problem auflöst. Foley, die Kunst der Erzeugung alltäglicher Soundeffekte, war ein ganzes Jahrhundert lang ein hochspezialisiertes Handwerk: Schritte aufnehmen, Kokosnüsse für Hufschläge zerschlagen, Bleche für Windgeräusche schütteln.
Jetzt weiß das Modell es einfach. Nicht über starre Regeln oder Soundbibliotheken, sondern durch erlernte statistische Beziehungen zwischen visuellen Ereignissen und ihren akustischen Signaturen.
Ersetzt das Foley-Artists? Für High-End-Filmproduktionen im Moment wahrscheinlich noch nicht. Für YouTube-Videos, Social-Media-Inhalte und schnelle Prototypen? Auf jeden Fall. Die Messlatte für Qualität hat sich dramatisch verschoben.
Technische Grenzen bestehen weiterhin
Lassen Sie uns ehrlich darüber sprechen, was noch nicht funktioniert:
Komplexe musikalische Abläufe: Einen Charakter zu generieren, der mit korrekter Fingerhaltung Klavier spielt und dabei tongenaues Audio liefert? Immer noch größtenteils fehlerhaft. Die visuell-auditive Korrelation für präzise musikalische Darbietungen ist extrem schwierig.
Langzeitkonsistenz: Die Audioqualität neigt bei längeren Generierungen dazu abzudriften. Hintergrundgeräusche können sich bei einigen Modellen ab der 15- bis 20-Sekunden-Marke unnatürlich verändern.
Sprache bei Störgeräuschen: Klare Dialoge in akustisch komplexen Umgebungen zu erzeugen, führt nach wie vor zu Artefakten. Das sogenannte Cocktailparty-Problem bleibt eine harte Nuss.
Kulturelle Klangunterschiede: Modelle, die primär auf westlichen Inhalten trainiert wurden, tun sich mit regionalen akustischen Besonderheiten schwer. Hallcharakteristiken, Umgebungsmuster und kulturelle Klangmerkmale nicht-westlicher Umgebungen werden weniger effektiv erfasst.
Was das für Creator bedeutet
Wenn Sie Videoinhalte erstellen, wird sich Ihr Workflow grundlegend verändern. Einige Vorhersagen:
Schnelllebiger Content wird noch schneller. Social-Media-Videos, die früher einen Tontechniker erforderten, lassen sich nun in wenigen Minuten durchgängig generieren. Für noch längere Inhalte sehen Sie, wie CraftStory 5-minütige kohärente Videos erstellt.
Prototyping wird radikal beschleunigt. Präsentieren Sie ein Konzept mit vollständig realisierten audiovisuellen Clips anstelle von Storyboards und Übergangsmusik.
Zugänglichkeit verbessert sich. Creator ohne Fachwissen in der Audioproduktion können Inhalte mit professionellem Sounddesign produzieren.
Die Wertschätzung für Fähigkeiten verlagert sich von der reinen Ausführung hin zur Ideenfindung. Zu wissen, was gut klingt, wird wichtiger als zu wissen, wie man es technisch baut.
Die philosophische Eigenart
Hier ist der Punkt, der mich nachdenklich stimmt: Diese Modelle haben noch nie etwas "gehört". Sie haben statistische Muster zwischen visuellen Repräsentationen und Audiowellenformen gelernt. Und doch erzeugen sie Klänge, die sich richtig anfühlen, die genau unseren Erwartungen entsprechen, wie die Welt klingen sollte.
Ist das Verstehen? Oder ist es Mustererkennung, die so hochentwickelt ist, dass sie sich von echtem Verstehen nicht mehr unterscheiden lässt? Ich habe darauf keine fertigen Antworten, finde die Frage jedoch faszinierend.
Das Modell erzeugt das Geräusch eines zerbrechenden Weinglases, weil es diese Korrelation aus Millionen von Beispielen gelernt hat, nicht weil es die Mechanik von Glas oder die Physik von Akustik begreift. Dennoch klingt das Ergebnis richtig, auf eine Art und Weise, die sich rein statistisch kaum greifen lässt.
Wohin die Reise geht
Die Richtung zeichnet sich klar ab: längere Laufzeiten, höhere Wiedergabetreue, mehr Kontrolle. Bis Mitte 2026 erwarte ich folgende Entwicklungen:
- Native Audio-Video-Generierung von über 5 Minuten
- Echtzeitgenerierung für interaktive Anwendungen
- Feingranulare Audiokontrolle (Dialoglautstärke, Musikstil und Umgebungspegel separat anpassen)
- Cross-modales Editieren (Ändert sich das Bild, passt sich das Audio automatisch an)
Die Kluft zwischen der reinen Vorstellung und ihrer Manifestation als fertiger audiovisueller Inhalt schrumpft zusammen. Für Creator ist das entweder berauschend oder beängstigend. Wahrscheinlich beides.
Probieren Sie es selbst aus
Der beste Weg, diesen Umbruch zu verstehen, ist, ihn selbst zu erleben. Die meisten Modelle bieten kostenlose Tarife oder Testversionen an:
- Google AI Studio: Zugriff auf Veo 3 Funktionen über Gemini
- Sora in ChatGPT: Verfügbar für Plus- und Pro-Abonnenten
- Kling: Webzugriff über deren Plattform
- Runway Gen-4: API und Webinterface verfügbar
Einen detaillierten Vergleich dieser Tools finden Sie in unserer Aufschlüsselung zu Sora 2 vs Runway vs Veo 3.
Fangen Sie einfach an. Generieren Sie einen 4-sekündigen Clip mit klarem Tonbezug: ein hüpfender Ball, Regen an einer Fensterscheibe, jemand, der in die Hände klatscht. Beobachten Sie, wie der Ton ohne jedes manuelle Eingreifen exakt zum Bild passt.
Versuchen Sie sich danach an etwas Komplexerem: Ein belebter Marktplatz. Ein heraufziehendes Gewitter. Ein Gespräch zwischen zwei Menschen.
Sie werden den Moment spüren, in dem es klick macht, in dem klar wird, dass wir nicht mehr bloß Videos generieren. Wir generieren Erlebnisse.
Die Stummfilm-Ära ist vorbei. Der Tonfilm ist da.