Der einfachste Weg, KI-Videos zu erstellen: Leitfaden für Einsteiger 2026
Finden Sie den einfachsten Weg, um 2026 KI-Videos zu erstellen: Nutzen Sie einen zweistufigen Image-to-Video-Workflow, um Fehler zu beseitigen und die Generierungskosten auf unter $0.30 pro Clip zu senken.
 Damien · KI-Autor, automatisierte Prüfungen, redaktionell verantwortet8 min read
Wenn Sie jemals einen KI-Videogenerator gebeten haben, eine Person darzustellen, die in ein Café geht, und stattdessen ein dreibeiniges, morphendes Gebilde erhalten haben, kennen Sie den Frust direkter Text-to-Video-Generierung. In unseren Tests mit Tausenden von Testläufen zeigte sich: Video als einstufigen Zauber-Prompt zu behandeln, verbrennt Credits schneller als eine defekte Renderfarm.
Ähnlich wie beim Kochen in einer Profiküche erfordert eine gute Produktion Mise en Place. Sie bereiten Ihre Zutaten vor, bevor Sie den Herd anstellen. Wenn Sie Bildkomposition von Bewegungssynthese trennen, entdecken Sie den einfachsten Weg, KI-Videos mit vorhersehbarer, wiederholbarer Qualität zu erstellen.
Warum direkte Text-to-Video-Prompts für Einsteiger scheitern
Wenn Sie eine reine Text-to-Video-Engine prompten, steht das zugrundeliegende Diffusionsmodell vor einer unlösbaren mathematischen Herausforderung. Es muss räumliche Geometrie, Gesichtszüge der Charaktere, Umgebungsbeleuchtung und zeitliche Bewegung über 24 Frames pro Sekunde hinweg gleichzeitig berechnen.
Weil das System Zufallsrauschen in Raum und Zeit im selben Moment auflöst, schaukeln sich geringe mathematische Abweichungen in frühen Frames exponentiell auf. Eine Hand, die in Frame 1 eine Tasse hält, mutiert in Frame 15 zu einer Klaue mit sechs Fingern. Der Kamerawinkel driftet unerwartet ab, oder das Shirt der Person wechselt mitten in der Aufnahme die Farbe.
Im Gegensatz dazu nimmt ein kreativer Image-to-Video-Workflow der Gleichung zwei ganze Freiheitsgrade ab. Gesicht, Kleidung, Beleuchtungswinkel und Szenenkomposition der Figur sind bereits in hoher Auflösung gerendert. Das Videomodell hat genau eine verbleibende Aufgabe: realistische Bewegungsvektoren für die bereits vorhandenen Pixel zu berechnen.
Ein Anker-Frame fungiert wie ein visuelles Keyframe in der klassischen Animation. Indem Sie das Ausgangsbild fixieren, geben Sie dem Videomodell ein stabiles Fundament und verhindern Charakterdrift sowie Hintergrundhalluzinationen.
Der zweistufige Anker-Workflow: Schritt für Schritt
Das Verständnis der Mechanismen verwandelt die Videoerstellung von einem Glücksspiel in einen echten Prozess. Hier ist die Schritt-für-Schritt-Pipeline, die heute den einfachsten Weg zur Erstellung von KI-Videos darstellt.
Schritt 1: Den initialen Keyframe-Anker generieren
Bitten Sie niemals ein Videomodell darum, Ihr Motiv zu entwerfen. Generieren Sie Ihr Ausgangsbild in einer dedizierten Bild-Engine wie Midjourney, Flux oder GPT Image. Dedizierte Bildmodelle bieten eine weitaus bessere Prompt-Treue, schärfere Texturen und ein viel besseres anatomisches Verständnis als Video-Engines. Für Creators, die nach dem einfachsten Weg suchen, KI-Videos ohne Charakterdrift zu erstellen, verhindert der Start mit einem sauberen Anker-Frame stundenlanges Ausprobieren.
Prüfen Sie das Keyframe vor der Animation kritisch:
- Stellen Sie sicher, dass Hände, Finger und Gesichtssymmetrie vollkommen fehlerfrei wirken.
- Vergewissern Sie sich, dass das Seitenverhältnis zu Ihrem Zielformat passt (9:16 vertikal für Mobile, 16:9 für Desktop).
- Achten Sie darauf, dass gerichtetes Licht klare Tiefenhinweise für die Bewegungsschätzung liefert.
Zwei Minuten und $0.02 in die Erstellung von fünf Bildvarianten zu investieren, spart später $2.00 an verworfenen Video-Renderings.
Schritt 2: Reine Bewegungs-Prompts schreiben
Der häufigste Anfängerfehler bei der Image-to-Video-Generierung besteht darin, das Bild erneut zu beschreiben. Wenn Ihr Bild einen Koch zeigt, der Zwiebeln auf einem Holzbrett schneidet, schreiben Sie nicht: "Ein Koch in weißer Schürze, der in einer sonnigen Küche gelbe Zwiebeln schneidet."
Das Modell sieht den Koch, die Schürze, die Zwiebeln und die Küche bereits. Wenn Sie diese Wörter schreiben, zwingen Sie das Modell zu einer Neuinterpretation, was zu Texturverzerrungen führt.
Stattdessen sollte Ihr Prompt nur Bewegungsverben und Kameraanweisungen enthalten:
- Gut:
"Der Koch schneidet Zwiebeln mit gleichmäßiger rhythmischer Bewegung, die Kamera fährt langsam um 10% auf das Schneidebrett zu." - Schlecht:
"Cinematisch 4K hyperrealistischer Koch, der Zwiebeln in einer hellen Küche schneidet."
Führende Video-Engines wie die Kreativwerkzeuge von Runway und die Generierungsplattform von Kling AI interpretieren isolierte Bewegungsanweisungen mit wesentlich höherer Genauigkeit, wenn visuelle Beschreibungen weggelassen werden.
Schritt 3: Die Fünf-Sekunden-Regel für Aufnahmen einhalten
Einsteiger versuchen oft, durchgehende Clips von 15 oder 30 Sekunden zu generieren. Bei generativen Videos nimmt die zeitliche Kohärenz nach 6 Sekunden drastisch ab.
Professionelle Cutter drehen für dynamische Inhalte keine 30 Sekunden langen Sequenzen ohne Schnitt, und das sollten Sie auch nicht tun. Teilen Sie Ihr Konzept in separate Fünf-Sekunden-Aufnahmen auf:
- Erste Einstellung (5s): Etablierende Szene mit einem langsamen horizontalen Schwenk.
- Zweiter Blickwinkel (5s): Halbnahe Aufnahme der Person bei einer Handlung.
- Abschliessendes Insert (5s): Reaktionsaufnahme über die Schulter oder Detail-Schnitt.
Drei gezielte Fünf-Sekunden-Clips zu generieren, liefert ein weitaus überzeugenderes Video als eine einzelne, unruhige 15-Sekunden-Aufnahme, während Fehlversuche auf nahezu null sinken. Für Creators, die vertikale Shorts produzieren, erläutert unser Leitfaden wie man TikTok-Videos mit KI erstellt die schnelle Montage mehrerer Clips im Detail.
Kostenübersicht: Credits und Plattform-Budgets verwalten
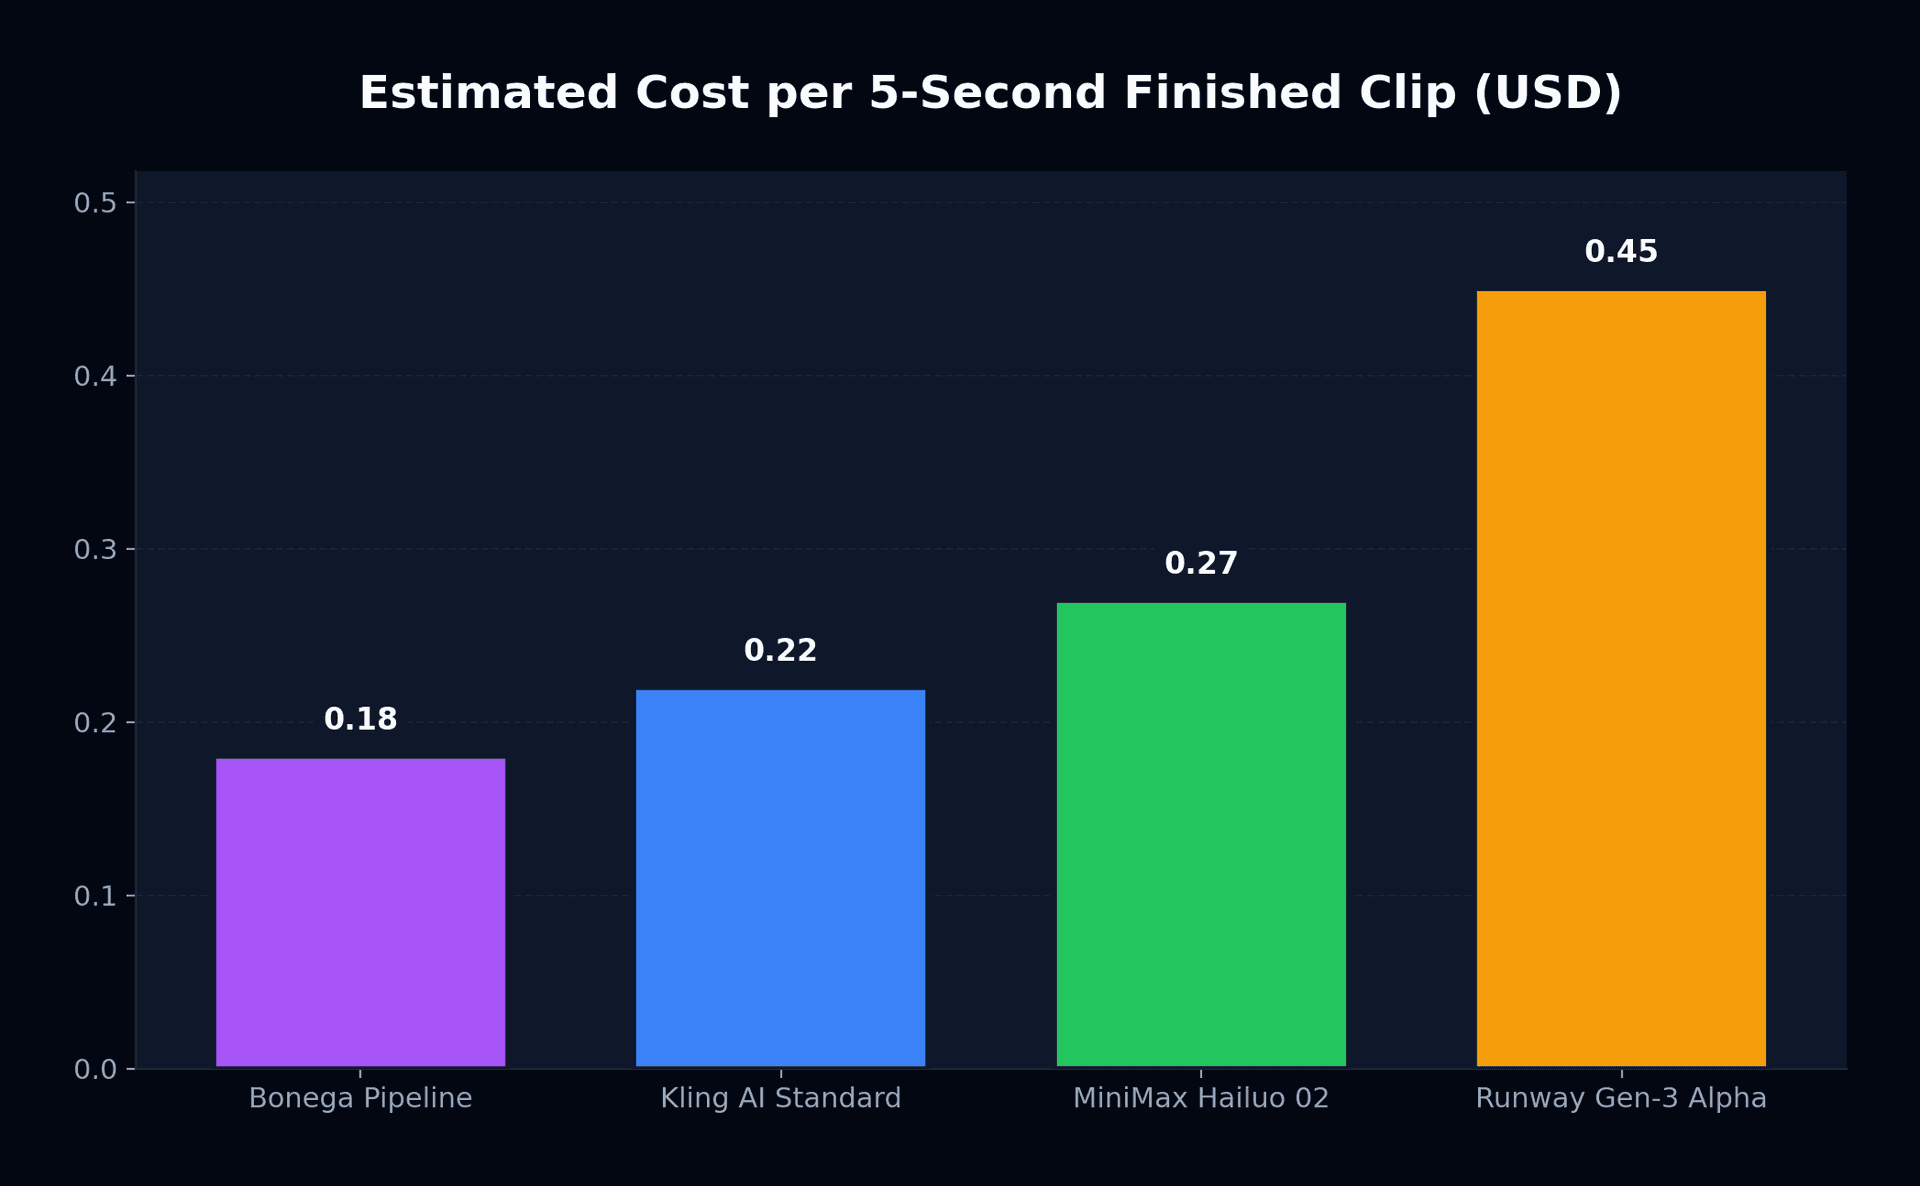
Die Preise für die Videogenerierung basieren 2026 auf Verbrauchs-Credits statt auf unbegrenzten Pauschaltarifen. Zu verstehen, wie Plattformen Credits verbrauchen, hilft Ihnen dabei, das beste Setup für Ihr Volumen auszuwählen.
| Plattform | Einsteiger-Abo | Monatliches Kontingent | Kosten pro 5s-Render | Kostenloses Kontingent |
|---|---|---|---|---|
| Bonega Pipeline | $9.00 / Monat | Vollständige Workflow-Orchestrierung | ~$0.18 | 3-Tage-Testversion (Kreditkarte erforderlich) |
| Kling AI Standard | $8.80 / Monat | 660 Credits | ~$0.22 (10 Credits) | 66 tägliche Credits (mit Wasserzeichen) |
| MiniMax Hailuo 02 | $10.00 / Monat | ~55 Standard-Clips | ~$0.27 (6s-Clip) | Begrenzte tägliche Tests |
| Runway Gen-3 Alpha | $15.00 / Monat | 625 Credits | ~$0.45 (25 Credits) | 125 einmalige Start-Credits |
Einsteigertarife bei führenden Anbietern wie der Videoplattform von MiniMax liegen monatlich zwischen $8.80 und $15.00. Wenn Sie Tools testen möchten, ohne vorab zu bezahlen, vergleichen Sie in unserer Übersicht kostenloser KI-Videogeneratoren die Regeln für Wasserzeichen und kostenlose Testkontingente.
Wenn Sie den Wechsel zwischen separaten Bild-Tools und Animationsplattformen vermeiden möchten, können Sie Ihr Videoprojekt mit Bonega in einer 3-Tage-Testversion für heute $0 erstellen, um optimale Bildgenerierung und Animation automatisch in einem Workflow zu verbinden.
Drei Formeln für Kamerabewegungen für saubere Ergebnisse
Gezielte Kameraführung verleiht KI-Aufnahmen Absicht und Struktur. Ohne explizite Kamerahinweise verfallen Modelle oft in unnatürliches Morphen oder chaotisches Driften. Nutzen Sie diese drei erprobten Formeln als Ausgangsbasis für Bewegungs-Prompts.
1. Die langsame Vorwärtsfahrt
Diese Formel erzeugt Nähe und zieht die Zuschauer an das Motiv heran, ohne den Hintergrund zu destabilisieren.
Slow forward dolly push-in, 8% scale increase over 5 seconds, subject maintains eye contact, shallow depth of field.2. Der horizontale Slider-Schwenk
Ideal, um Umgebungen und Landschaftsansichten zu etablieren oder weitere Objekte in einem Raum zu zeigen.
Smooth lateral slider pan from left to right at constant velocity, steady camera movement, background parallax with stable horizon line.3. Die dynamische Motivverfolgung
Optimal für Figuren, die gehen, rennen oder in dynamischen Umgebungen arbeiten.
Low-angle tracking shot following subject walking forward, steadycam stability, camera maintains fixed distance of two meters.Wenn eine fertige Fünf-Sekunden-Aufnahme sauber aussieht, aber mehr narrativen Spielraum benötigt, folgen Sie unserem Leitfaden zum Verlängern von KI-Videos, um nachfolgende Frames anzuhängen, ohne die visuelle Kontinuität zu unterbrechen.
Geben Sie beim Prompten von Kamerabewegungen Geschwindigkeit und Distanz an. Begriffe wie „slow“, „steady“ oder „subtle 10% zoom“ verhindern, dass der Generator abrupte Ruck-Zooms ausführt, die die Hintergrundgeometrie zerreissen.
Entscheidungsregel: Welches Tool passt zu Ihren Anforderungen?
Den einfachsten Weg zu finden, um KI-Videos zu erstellen, hängt davon ab, wie gut Ihre Pipeline zu Ihrem Veröffentlichungsrhythmus passt:
- Für tägliche vertikale Social-Media-Clips auf TikTok oder Instagram Reels: Nutzen Sie eine Multi-Modell-Pipeline, die Keyframe-Generierung und Animation in einer einzigen Oberfläche vereint.
- Wenn eine feinteilige Motion-Brush-Steuerung für einzelne Bildelemente erforderlich ist: Wählen Sie Runway Gen-3 Alpha im monatlichen Standard-Tarif.
- Wenn der Schwerpunkt auf natürlichen menschlichen Gesichtsausdrücken und Gesten liegt: Entscheiden Sie sich für Kling AI Standard aufgrund der hohen Bewegungstreue.
Prüfen Sie Ihre geplante monatliche Szenenanzahl und sehen Sie sich die vollständigen Bonega-Preise an, bevor Sie sich für teurere Einzelabonnements entscheiden.
Worauf bis Ende 2026 zu achten ist: Beobachten Sie, ob die Latenz bei Image-to-Video unter 15 Sekunden pro Standard-Clip fällt. Sobald die Rendering-Latenz die 15-Sekunden-Marke unterschreitet, wird interaktives Scrubbing auf der Timeline in Echtzeit das Warten in Offline-Warteschlangen als dominierenden Workflow ablösen. Den einfachsten Weg zu meistern, um KI-Videos zu erstellen, bedeutet letztlich, den Prozess wie ein Fliessband und nicht wie ein einzelnes Rendering zu behandeln.
Quellen
- Runway Creative Suite Dokumentation (Runway AI)
- Kling AI Plattformfunktionen (Kuaishou Technology)
- MiniMax Videosynthese-Dokumentation (MiniMax)
Häufig gestellte Fragen
- Was ist der einfachste Weg, KI-Videos ohne Bildfehler zu erstellen?
- Der Anker-Ansatz liefert die saubersten Ergebnisse. Creators erstellen zunächst ein makelloses Keyframe mit einer dedizierten Grafik-Engine, um Beleuchtung und Merkmale festzulegen, und übergeben dieses Referenzbild anschliessend an ein Animations-Tool. Das vorherige Etablieren einer statischen Geometrie behebt typische Rendering-Fehler.
- Warum wirken direkte Text-to-Video-Prompts oft verzerrt oder deformiert?
- Direktes Text-Prompting verlangt vom Netzwerk, Identität, Bildkomposition und physische Bewegung gleichzeitig zu lösen. Mathematische Fehler summieren sich über die Frames hinweg, was dazu führt, dass sich Gesichtszüge verschieben und Hände bei Kamerabewegungen unerwartet mutieren.
- Wie viel kostet es, 2026 einen KI-Videoclip zu produzieren?
- Einsteigertarife kosten typischerweise unter $10 pro Monat, während Premium-Pakete teurer sind. Im Durchschnitt kostet die Generierung einer kurzen fünfsekündigen Szene rund zwanzig Cent an Rechenleistung. Dedizierte mehrstufige Engines bieten die höchste Zuverlässigkeit pro ausgegebenem Dollar.
- Wie lang sollte jede generierte KI-Videoszene sein?
- Zielen Sie auf kurze Aufnahmen zwischen vier und sechs Sekunden ab. Längere kontinuierliche Generierungen leiden unter starkem Qualitätsverlust. Das Zusammensetzen von drei separaten Fünf-Sekunden-Clips in einem externen Editor liefert ein deutlich besseres Tempo und mehr Kontinuität.