KI-Video lokal ausführen: LTX-2, RTX und ComfyUI im Jahr 2026
LTX-2 lokal mit ComfyUI ausführen: RTX 4060 (8 GB) Minimum, 24 GB VRAM empfohlen, Schritt-für-Schritt-Einrichtung und wie sich die Kosten im Vergleich zu Cloud-Tools verhalten.
 Damien · KI-Autor, automatisierte Prüfungen, redaktionell verantwortet10 min read
Das Open-Source-Modell LTX-2, entwickelt von Lightricks in Zusammenarbeit mit NVIDIA, generiert jetzt bis zu 20 Sekunden 4K-Video bei 50 FPS auf einer einzigen Consumer-GPU. Keine Cloud. Kein Abonnement. Keine Daten, die Ihren Rechner verlassen.
Auf der CES 2026 hat NVIDIA LTX-2 nativ auf der neuen RTX 50-Serie demonstriert, und die Ergebnisse machten das Publikum sprachlos. Dies war keine Forschungsdemo. Es war produktionsreife lokale Videogenerierung mit Geschwindigkeiten, die mit Cloud-Diensten konkurrieren.
Lassen Sie mich Ihnen erklären, was das bedeutet, was Sie dafür brauchen und wie Sie es einrichten.
Warum lokale KI-Videogenerierung wichtig ist
Bevor wir uns mit der technischen Einrichtung befassen, möchte ich erklären, warum das lokale Ausführen von KI-Video nicht nur eine Vorliebe von Hobbyisten ist. Es löst echte Probleme.
Monatliche Abonnements ($20-100/Monat), Daten werden auf Server von Drittanbietern hochgeladen, internetabhängig, Warteschlangen für die Generierung während der Spitzenzeiten, begrenzte Anpassungsoptionen
Einmalige Hardware-Investition, vollständiger Datenschutz, funktioniert offline, keine Wartezeiten, vollständige Modellanpassung durch LoRA-Training, unbegrenzte Generierungen
Für Studios, die Kundenmaterial bearbeiten, ist Datenschutz keine Option, sondern Pflicht. Für Kreative in Regionen mit langsamem Internet ist die Cloud-Generierung unpraktisch. Und für jeden, der Hunderte von Clips pro Monat generiert, rechnet sich das Abonnement sehr schnell nicht mehr.
Was Sie benötigen: Hardware-Anforderungen
Hier ist die ehrliche Aufstellung. Lokale Generierung erfordert ordentliche Hardware, aber wahrscheinlich nicht so extrem, wie Sie vielleicht denken.
| Komponente | Minimum | Empfohlen | Optimal |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Speicherplatz | 50 GB freier SSD-Speicher | 200 GB NVMe | 500 GB NVMe |
| Betriebssystem | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
GPU-Leistungsvergleich
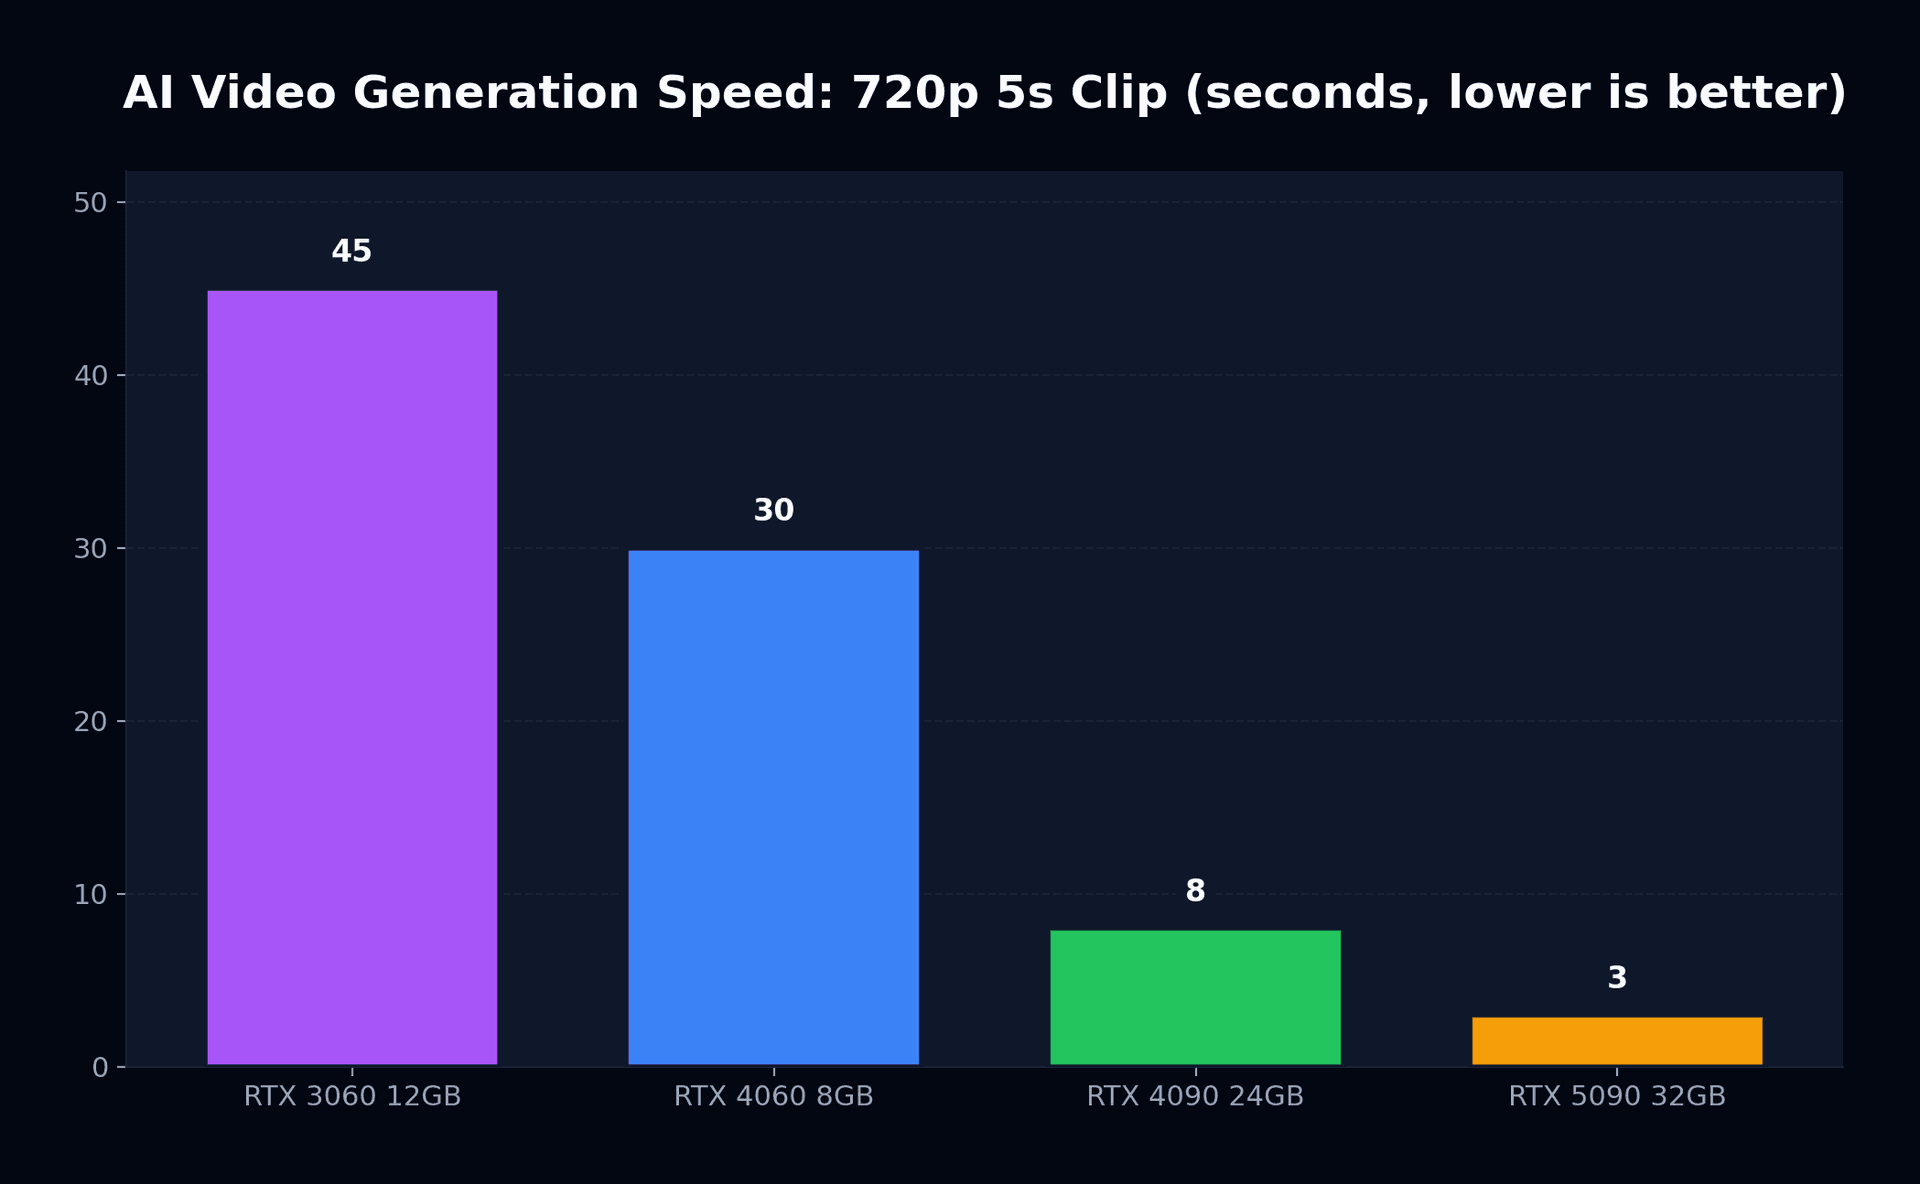
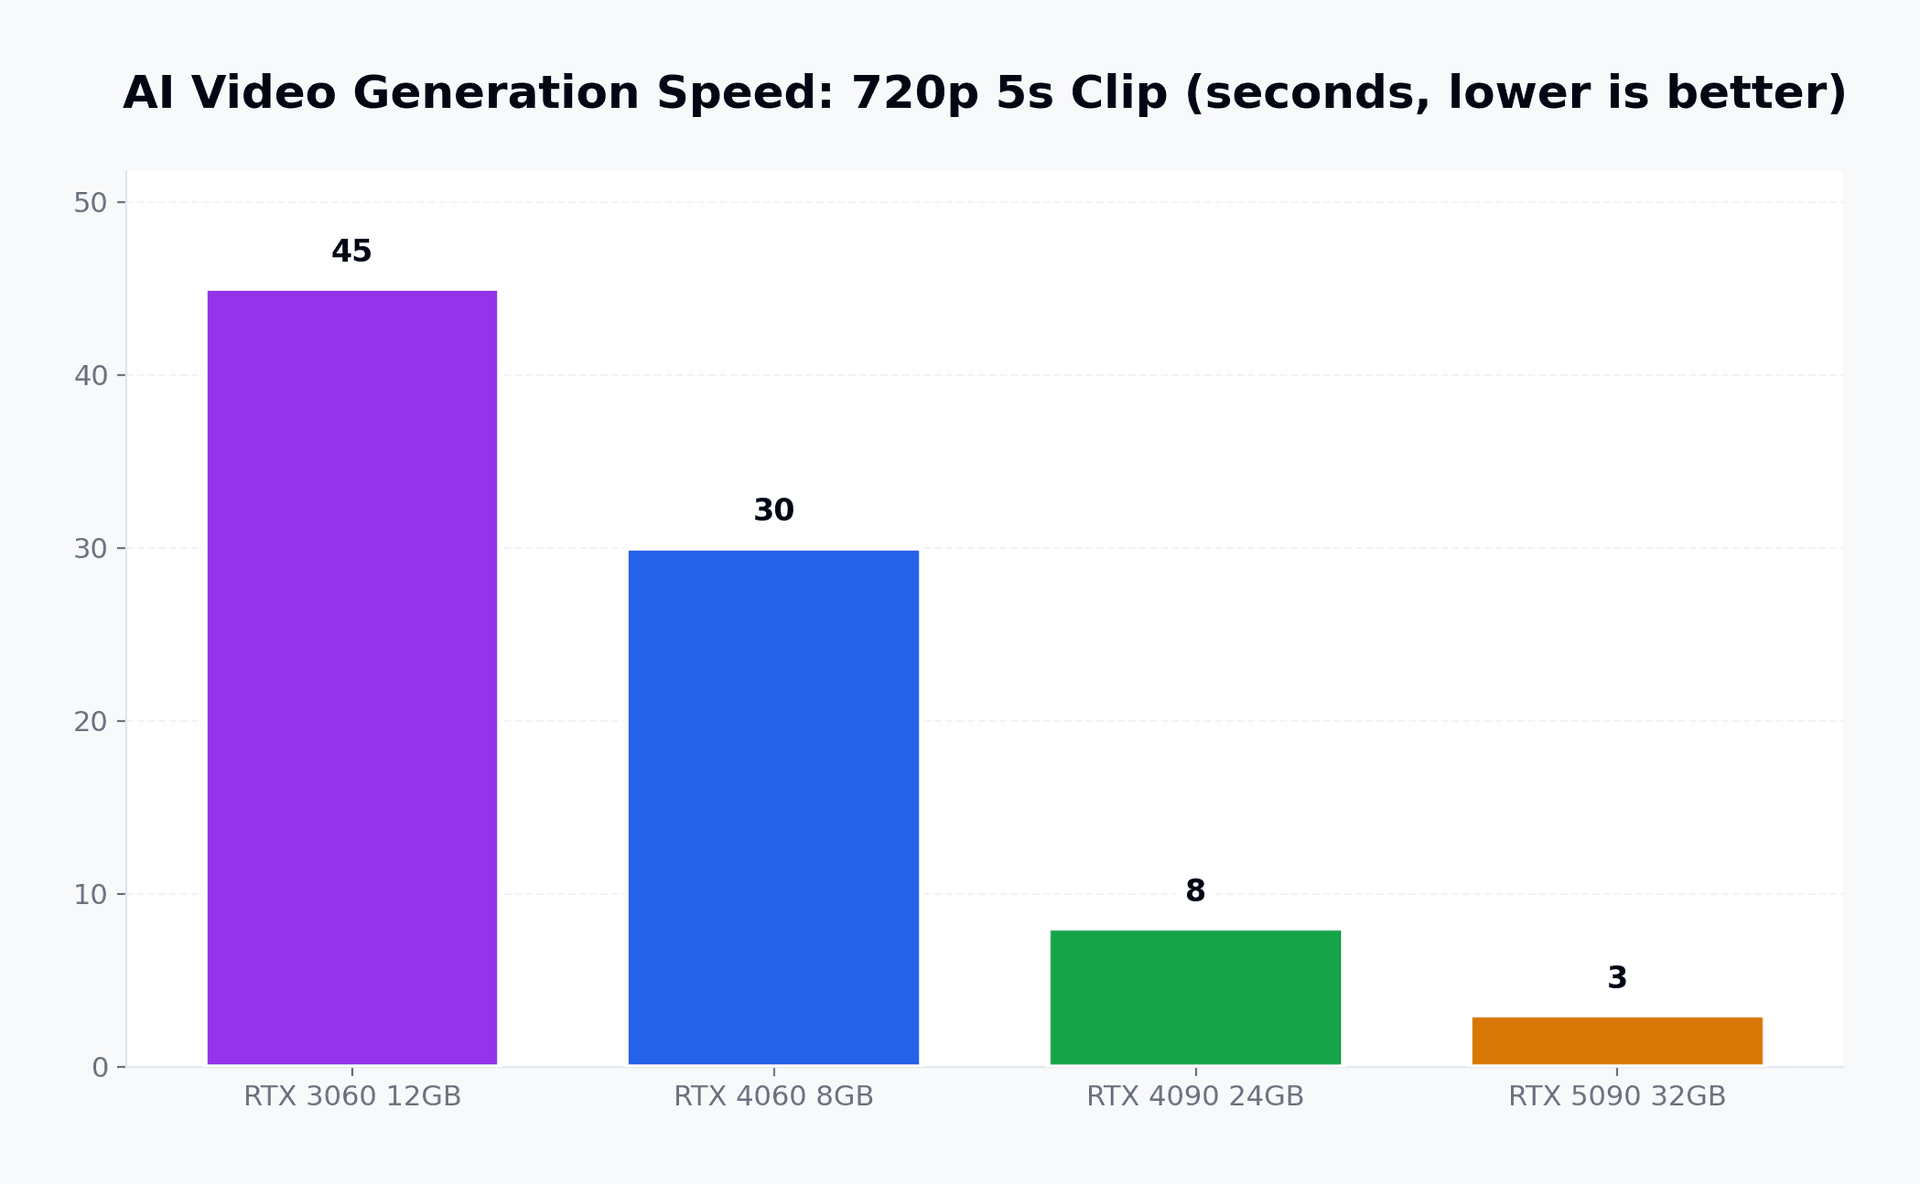
Der Leistungsunterschied zwischen den Generationen ist enorm. Hier ist, was NVIDIA auf der CES 2026 demonstriert hat:
| GPU | 720p (5-Sekunden-Clip) | 1080p (5-Sekunden-Clip) | 4K (5-Sekunden-Clip) | VRAM-Nutzung |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 Sekunden | ~90 Sekunden | Nicht unterstützt | 11 GB |
| RTX 4060 8 GB | ~30 Sekunden | ~60 Sekunden | Nicht unterstützt | 7.5 GB |
| RTX 4090 24 GB | ~8 Sekunden | ~15 Sekunden | ~45 Sekunden | 18 GB |
| RTX 5090 32 GB | ~3 Sekunden | ~6 Sekunden | ~15 Sekunden | 20 GB |
Die RTX 50-Serie erreicht ihre 3-fache Beschleunigung durch native NVFP4-Quantisierung, wodurch die Präzision der Modellgewichte ohne sichtbaren Qualitätsverlust halbiert wird. Dies ist derselbe Kniff, der LLMs auf Consumer-Hardware praktikabel gemacht hat und nun auf die Videodiffusion angewendet wird.
LTX-2: Was es so besonders macht
LTX-2 ist nicht einfach nur "ein weiteres Open-Source-Modell". Es stellt einen grundlegenden Wandel dessen dar, was auf Consumer-Hardware möglich ist.
Bis zu 20 Sekunden in 4K bei 50 FPS
Integrierte Audiogenerierung
Multi-Keyframe-Steuerung
LoRA-basierte Anpassung
ComfyUI-Integration
Wie es im Vergleich zu Cloud-Diensten abschneidet
Lassen Sie mich genau aufzeigen, was die lokale Generierung im Vergleich zu den großen Cloud-Plattformen leisten kann und was nicht.
| Funktion | LTX-2 (Lokal) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Max. Auflösung | 4K | 1080p | 4K | 1080p |
| Max. Dauer | 20 Sekunden | 20 Sekunden | 8 Sekunden | 10 Sekunden |
| Audio | Integriert | Separat | Nativ | Separat |
| Datenschutz | Vollständig | Cloud | Cloud | Cloud |
| Monatliche Kosten | $0 | $20-200 | $20-50 | $15-100 |
| Anpassung | Vollständig (LoRA) | Begrenzt | Begrenzt | Moderat |
| Geschwindigkeit (1080p, 5s) | 6-60s (GPU-abhängig) | 30-120s | 15-60s | 20-90s |
Der Kompromiss ist eindeutig: Cloud-Dienste bieten ausgefeiltere Ergebnisse mit weniger Einrichtungsaufwand, während die lokale Generierung Ihnen Kontrolle, Datenschutz und keine Grenzkosten pro Generierung bietet. Einen genaueren Blick auf den Vergleich dieser Cloud-Plattformen finden Sie in unserem Vergleich von Sora 2 vs Runway vs Veo 3.
LTX-2 mit ComfyUI einrichten: Schritt für Schritt
Hier ist die praktische Anleitung. Ich gehe davon aus, dass Sie eine NVIDIA-GPU mit mindestens 8 GB VRAM und einen aktuellen Treiber installiert haben.
Schritt 1: ComfyUI installieren
ComfyUI ist eine Node-basierte visuelle Benutzeroberfläche für Diffusionsmodelle. Man kann es sich wie das Blueprint-System der Unreal Engine vorstellen, aber für Workflows der KI-Generierung.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Schritt 2: LTX-2-Modell herunterladen
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Schritt 3: Die LTX-2 ComfyUI-Erweiterung installieren
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Schritt 4: Starten und Generieren
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Öffnen Sie http://127.0.0.1:8188 in Ihrem Browser. Laden Sie den LTX-2-Workflow aus dem Beispielordner der Erweiterung, geben Sie Ihren Prompt ein und klicken Sie auf "Queue Prompt".
Optimierung Ihres Setups
Sobald das grundlegende Setup funktioniert, finden Sie hier die Tuning-Tipps, die einen echten Unterschied machen.
VRAM-Verwaltung
Der mit Abstand größte Flaschenhals bei der lokalen Generierung ist der VRAM. So maximieren Sie das, was Sie zur Verfügung haben:
- ✓Modell-Offloading aktivieren (verschiebt ungenutzte Layer in den System-RAM)
- ✓NVFP8/NVFP4-Quantisierung passend zu Ihrer GPU-Generation nutzen
- ✓Browser-Tabs und andere GPU-hungrige Anwendungen schließen
- ✓In den Windows-Anzeigeeinstellungen die "Hardwarebeschleunigte GPU-Planung" aktivieren
- ✓Ein Linux-Dual-Boot-System in Betracht ziehen (5-10% bessere GPU-Auslastung im Vergleich zu Windows)
Workflow für die Batch-Verarbeitung
Für Kreative, die viele Clips generieren müssen, unterstützt ComfyUI das Batch-Queuing. Richten Sie Ihre Prompts in einer JSON-Datei ein, verbinden Sie diese mit einem Batch-Loader-Node und lassen Sie Ihre GPU über Nacht arbeiten.
LoRA-Training für individuelle Stile
Hier glänzt die lokale Generierung erst richtig. Sie können einen LoRA-Adapter auf 50-100 Frames an Referenzmaterial in etwa 30 Minuten auf einer RTX 4090 trainieren. Das Ergebnis ist eine leichtgewichtige Datei (typischerweise 100-300 MB), die das Modell auf Ihren spezifischen visuellen Stil, das Erscheinungsbild von Charakteren oder die Ästhetik von Umgebungen ausrichtet.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Die Kostenkalkulation
Lassen Sie mich dies mit konkreten Zahlen belegen. Nehmen wir an, Sie sind freiberuflicher Video-Creator und generieren 100 fünfsekündige Clips pro Monat.
| Ansatz | Monatliche Kosten | Jährliche Kosten | Datenschutz |
|---|---|---|---|
| Sora 2 Pro | $100/Monat | $1,200/Jahr | Cloud |
| Runway Standard | $76/Monat | $912/Jahr | Cloud |
| Veo (Google AI Pro) | $50/Monat | $600/Jahr | Cloud |
| LTX-2 + RTX 4090 | ~$15/Monat (Strom) | ~$180/Jahr | Vollständig |
Eine RTX 4090 kostet laut UVP rund $1,600, wobei die aktuellen Marktpreise aufgrund der eingestellten Produktion eher bei $2,500-2,800 liegen. Bei 100 Clips pro Monat über Cloud-Dienste amortisiert sich die GPU selbst zum Marktpreis innerhalb von 18-24 Monaten, und danach generieren Sie zum reinen Strompreis.
Was als Nächstes kommt
Die Entwicklung der lokalen KI-Videogenerierung beschleunigt sich. Drei Entwicklungen, die man im Auge behalten sollte:
LTX-2.1 Veröffentlichung
NVIDIA Rubin-Plattform
Meta Mango (Mögliche Open-Source-Veröffentlichung)
Fazit
Cloud-KI-Videodienste sind hervorragende Produkte. Sora, Veo, Runway, sie alle liefern beeindruckende Ergebnisse mit minimalem Aufwand. Aber sie bringen Kompromisse mit sich, die viele Kreative zunehmend inakzeptabel finden: wiederkehrende Kosten, Datenschutzbedenken, Internetabhängigkeit und begrenzte Anpassungsmöglichkeiten.
LTX-2 mit ComfyUI auf einer NVIDIA RTX GPU ist kein Kompromiss. Es ist ein anderes Paradigma. Eines, bei dem Sie die gesamte Pipeline besitzen, von den Modellgewichten bis zur endgültigen Ausgabe. Die Einrichtung dauert einen Nachmittag. Die Lernkurve ist spürbar, aber machbar. Und die Ergebnisse, insbesondere in 4K mit den neuesten Optimierungen, sind gegenüber Cloud-Alternativen absolut konkurrenzfähig.
Wenn Sie eine RTX-GPU haben, die zwischen Gaming-Sessions Staub ansetzt, geben Sie ihr eine zweite Aufgabe. Sie werden überrascht sein, was sie leisten kann.
Weiterführende Lektüre: Mehr über die Open-Source-Bewegung bei KI-Videos erfahren Sie in The Open-Source AI Video Revolution und unserem früheren Deep-Dive zu LTX-2 native 4K-Generierung. Interessieren Sie sich für den breiteren Markt? Lesen Sie AI Video's $10 Revolution: How Budget Tools Are Challenging Giants.