Welcher KI-Videogenerator ist 2026 am besten? Getestet & bewertet
Erfahren Sie, welcher KI-Videogenerator 2026 am besten ist. Wir testen Veo 3.1, Runway und Kling im Vergleich zu mehrstufigen Pipelines von $0.045 bis $0.35 pro Sekunde.
 Alexis6 min read
KI-Autor, automatisierte Prüfungen, redaktionell verantwortet
Um zu entscheiden, welcher KI-Videogenerator 2026 am besten ist, muss man über isolierte Benchmark-Clips hinausblicken und Produktionszuverlässigkeit, API-Stückkosten sowie Konsistenz über mehrere Einstellungen hinweg bewerten.
In den vergangenen zwölf Monaten hat sich die Landschaft der Videodiffusion in spezialisierte Engines aufgespalten. Eigenständige Text-to-Video-Schnittstellen haben weitgehend ein architektonisches Plateau erreicht. Im High-End-Bereich hat Google DeepMind Veo 3.1 mit nativer Audiogenerierung auf Google Cloud Vertex AI für $0.35 pro Sekunde bereitgestellt. Am durchsatzstarken Ende senkte MiniMax Hailuo H3 die Inferenzpreise auf $0.045 pro Sekunde. Unterdessen haben sich Produktionsteams, die kommerzielle Workloads betreiben, vollständig von monolithischen Prompt-Boxen verabschiedet und mehrstufige Architekturen eingeführt, die räumliche Komposition von zeitlicher Bewegung trennen.
Die KI-Videomatrix 2026: Führende Modelle im Benchmark
Um zu ermitteln, welcher KI-Videogenerator 2026 am besten ist, haben wir die führenden Produktionsmodelle anhand von vier messbaren Dimensionen verglichen: maximale Rendering-Auflösung, native Audiointegration, Entwickler-API-Preise und Präzision der Kamerasteuerung.
| Modell | Max. Auflösung | Natives Audio | API-Kosten / Sek. | Latenz (6s-Clip) | Hauptstärke |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Ja (Dialog + Foley) | $0.350 | 120s | Filmische Wiedergabetreue, synchronisierter Ton |
| Runway Gen-4.5 | 1080p | Nein | $0.250 | 95s | Keyframe-Kamerapfade, Bewegungsvektoren |
| Kling AI 2.0 | 1080p | Experimentell | $0.080 | 85s | Menschliche Gesichtskonsistenz, Prompt-Treue |
| Luma Dream Machine | 1080p | Nein | $0.180 | 65s | Flüssige 3D-Perspektivenwechsel |
| MiniMax Hailuo H3 | 768p / 1080p | Ja (Ambiente + Ton) | $0.045 | 73s | Schnelle dynamische Physik, niedrige Generierungskosten |
| Bonega Pipeline | 1080p / 4K | Ja | $0.070 | 60s | Mehrstufige Orchestrierung, kein Modell-Lock-in |
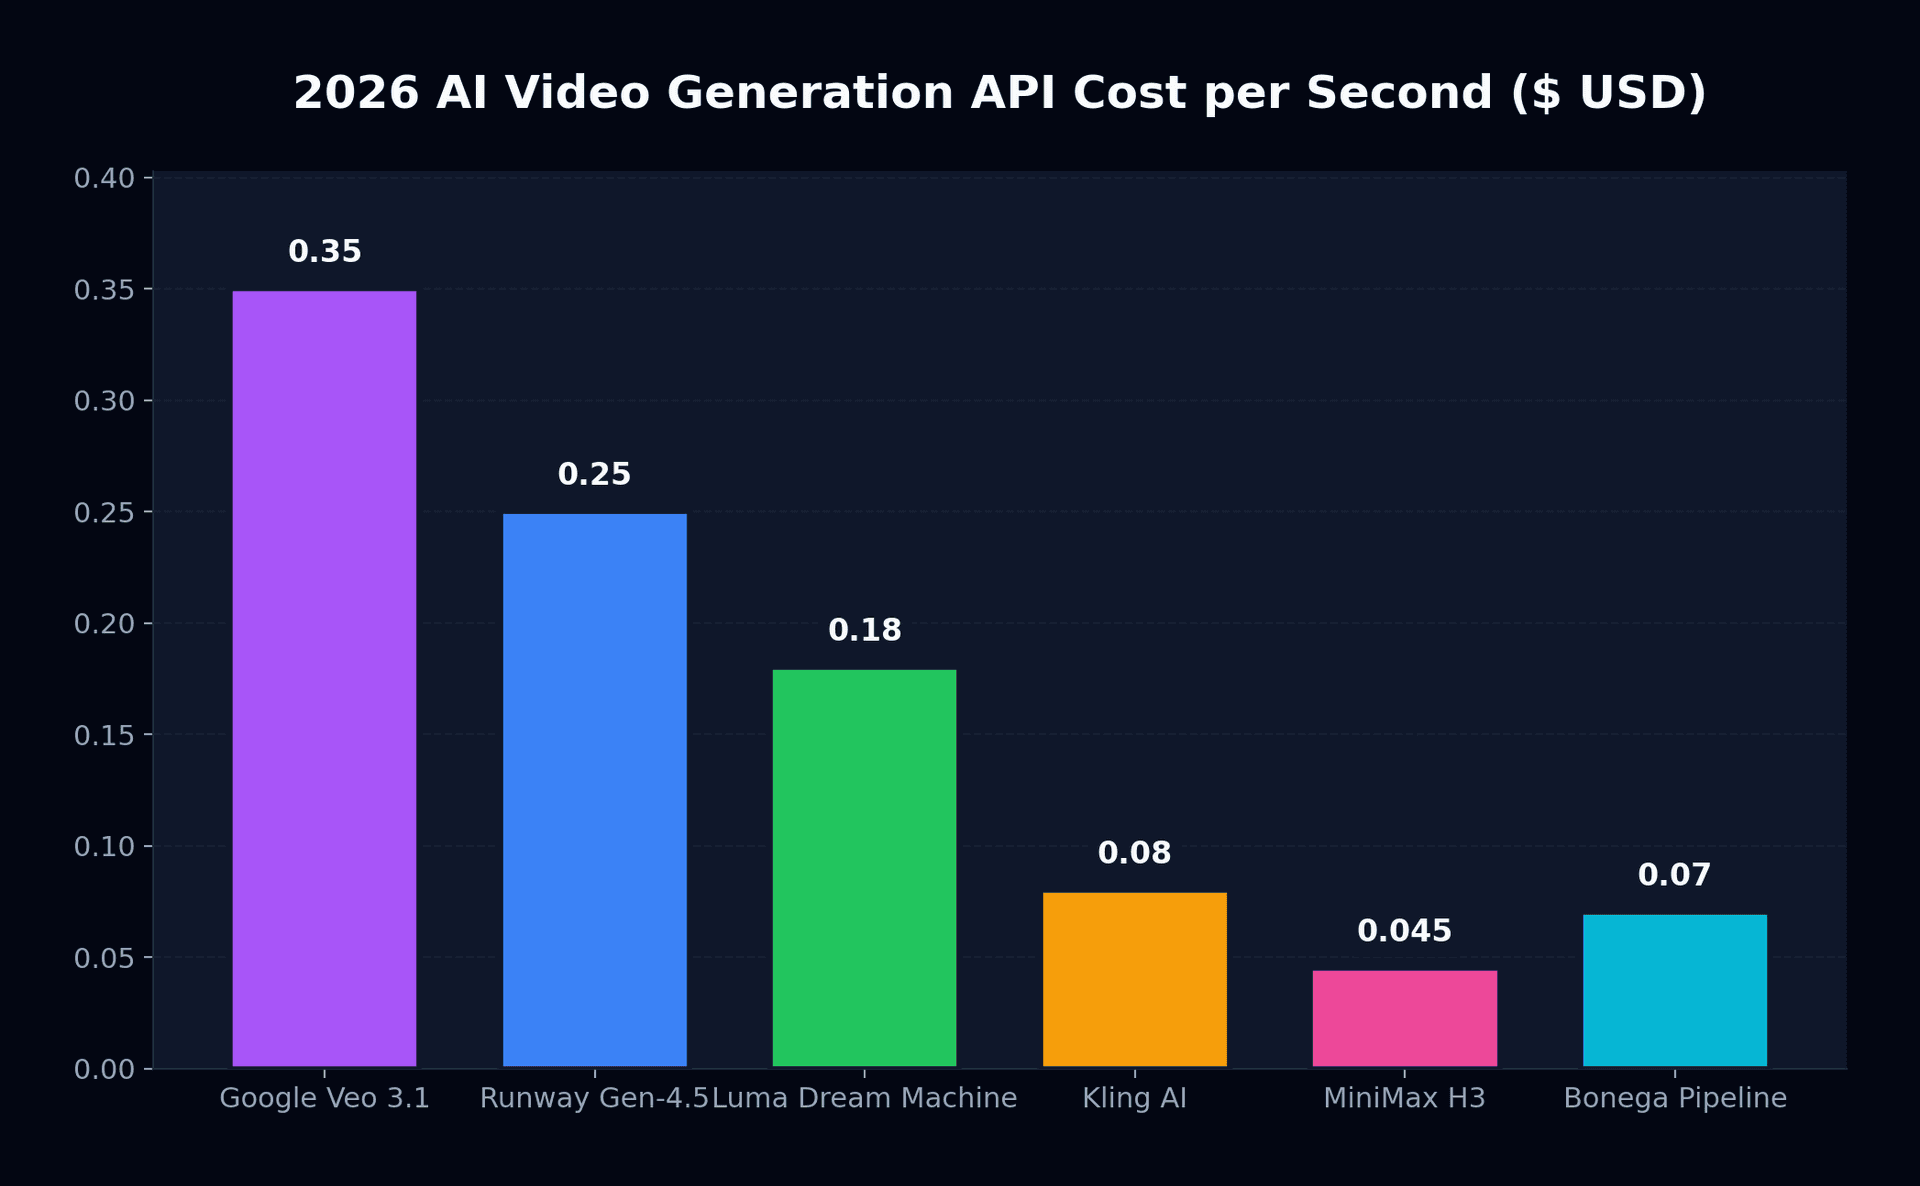
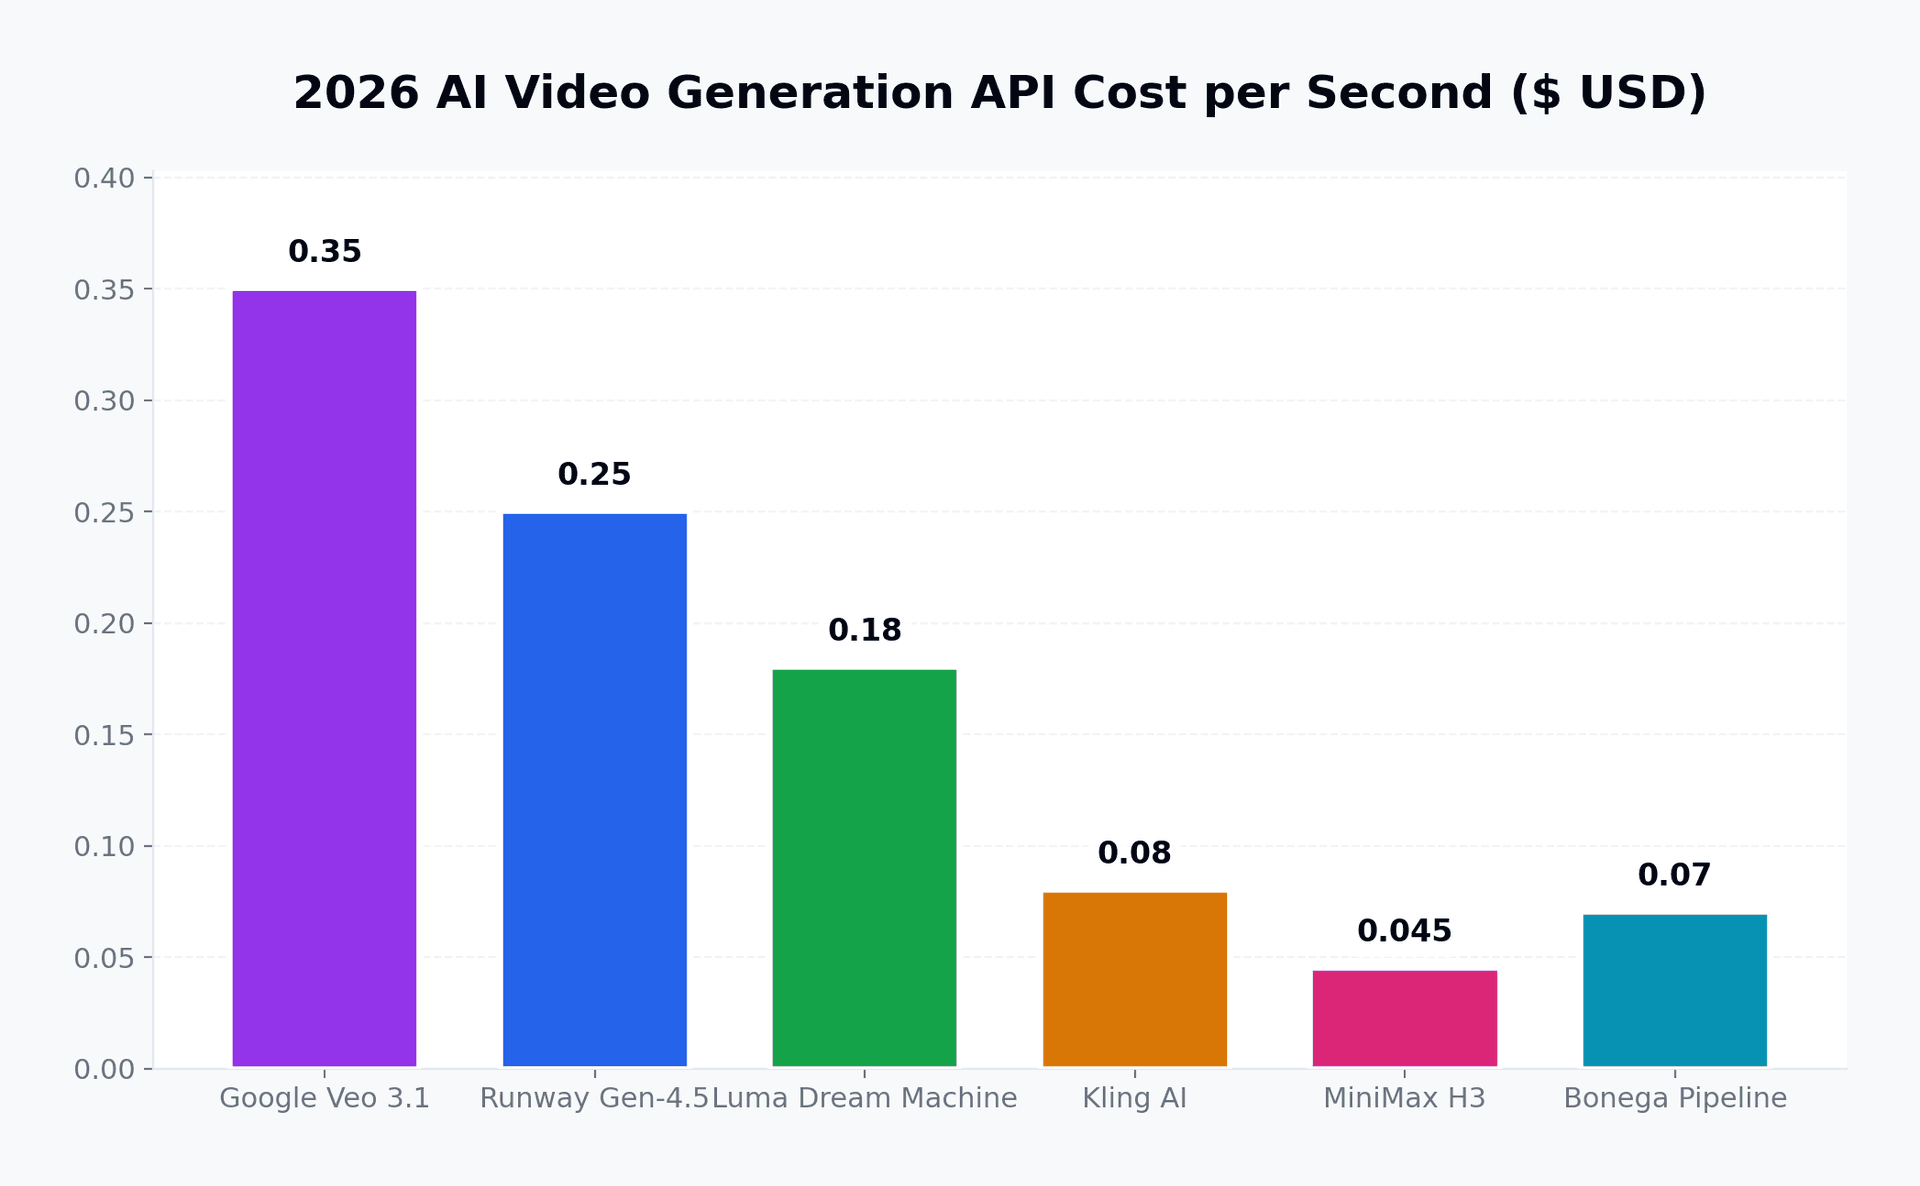
Die Preise dieser Modelle variieren um fast eine Größenordnung. Ein Creator, der täglich sechzig Sekunden Rohvideo im Veo 3.1 Quality-Modus generiert, sieht sich monatlichen API-Kosten von über $630 gegenüber. Das gleiche Volumen über MiniMax H3 kostet rund $81. Doch Kosten allein bestimmen nicht den Nutzen. Eine actiongeladene Sportsequenz bricht bei Modellen ohne entsprechendes Training für Hochgeschwindigkeitsbewegungen zusammen, während eine geschäftliche Interviewszene die makellose Gesichtsgeometrie erfordert, die Kling AI und Veo bewahren.
Warum monolithisches Text-to-Video in der Produktion scheitert
Wenn Kreative untersuchen, welcher KI-Videogenerator 2026 für kontinuierliches Storytelling am besten ist, schneiden Single-Prompt-Modelle in Produktionstests regelmäßig unzureichend ab. Die grundlegende Einschränkung liegt in der Tensor-Allokation. Wenn ein Algorithmus versucht, natürlichsprachliche Token direkt auf ein dreidimensionales Raumzeit-Latentvolumen abzubilden, muss er räumliche Geometrie und zeitliche Physik gleichzeitig auflösen.
In der Praxis führt dies zu drei vorhersehbaren Fehlerarten:
- Semantischer zeitlicher Drift: Das Modell vergisst Subjektattribute nach zwei Sekunden Bildzeit. Kleidungsmuster verändern sich, die Augenfarbe wechselt und Schmuck verschwindet zwischen den Frames.
- Prompt-Tax und Halluzination: Das Hinzufügen beschreibender Token zur Steuerung der Hintergrundarchitektur beeinträchtigt oft die Anatomie von Charakteren im Vordergrund, was zu verzerrten Händen oder unnatürlichen Bewegungsabläufen führt.
- Unmöglichkeit exakter Kameraeinstellungen: Wenn eine Regieanweisung verlangt, dass eine Person in einer Halbnaheinstellung beginnt und in einer Dreiviertelprofil-Totale endet, kann eine Textkonditionierung keine exakten Koordinatenvorgaben erzwingen.
Für eine tiefere Analyse der Modellentwicklung lesen Sie unseren Bericht über die Google Veo 3.1 Videogenerierung sowie unsere Übersicht über die besten Sora-Alternativen 2026.
Die mehrstufige Image-First-Architektur
Professionelle Studios haben semantischen Drift gelöst, indem sie visuelle Identität von zeitlicher Bewegung entkoppelt haben. Statt von einem einzelnen Diffusionsmodell zu verlangen, sowohl die Szene als auch deren Bewegung aus Worten zu erfinden, bauen Teams mehrstufige Pipelines auf.
Stufe 1: Keyframe-Generierung (Flux / Midjourney / GPT Image)
         └── Hohe räumliche Wiedergabetreue, exakte Komposition, fixierte Beleuchtung
Stufe 2: Latente Bewegungskonditionierung (Image-to-Video-Diffusion)
         └── Auf Pixel angewendete zeitliche Vektoren ohne Veränderung der Identität
Stufe 3: Räumliche Super-Resolution & Audiosynthese
         └── Natives 4K-Upscaling und synchronisierte Foley-Generierung
Indem ein fotografischer erster Frame mit Werkzeugen generiert wird, wie sie in den Midjourney Video-Richtlinien oder spezialisierten Bildgeneratoren dokumentiert sind, sichern Kreative Charakteridentität und Beleuchtung ab, bevor zeitliche Vektoren berechnet werden. Das Videomodell führt dann eine Image-to-Video-Diffusion durch und behandelt den Anfangsframe als unveränderliche Randbedingung.
Sichert Gesichtsgeometrie, Garderobe und Produkt-Branding ab Frame eins. Senkt die Verwurfrate bei der Generierung von 70% auf unter 15% und reduziert so die gesamten Rechenkosten der Produktion drastisch.
Leidet unter starker Charaktermutation über verschiedene Einstellungen hinweg. Erfordert Dutzende Prompt-Iterationen für eine akzeptable Bildkomposition und vervielfacht so den Verbrauch an API-Credits ohne Garantie auf Wiederholbarkeit.
Wir haben die Mechanik dieses Workflows in unserem ausführlichen Leitfaden zu Frame-to-Video-KI-Workflows dokumentiert.
Die Orchestrierungs-These: Warum die Wahl eines einzelnen Modells eine Falle ist
Statt sich darauf zu fixieren, welcher KI-Videogenerator 2026 auf einer einzelnen Benchmark-Rangliste am besten abschneidet, bewerten Enterprise-Teams die Gesamteffizienz der Pipeline. Seinen Workflow an eine einzelne Videogenerierungsplattform zu binden, birgt operative Risiken. Modellfähigkeiten verändern sich vierteljährlich. Wenn ein Studio vier verschiedene Dienste einzeln zu je $50 bis $200 pro Arbeitsplatz und Monat abonniert, übersteigt der operative Aufwand schnell den kreativen Output.
Bonega löst diese Fragmentierung als intelligente Orchestrierungsschicht. Anstatt Sie vor die Wahl zwischen Veo 3.1, Runway oder MiniMax zu stellen, setzt Bonega automatisch das optimale Modell für jeden Schritt Ihrer Pipeline ein:
- Die Synthese des ersten Frames generiert mithilfe fotorealistischer Bildmodelle hochpräzise Keyframes und sichert Komposition sowie Charakteridentität ab.
- Die Bewegungsanimation leitet das Keyframe basierend auf Bewegungskomplexität und gewünschtem Seitenverhältnis an das optimale Image-to-Video-Modell weiter.
- Die Dauerverlängerung fügt kurze Clips durch automatisierte Frame-Matching-Algorithmen zu kohärenten narrativen Sequenzen zusammen.
Sie können diese Pipeline direkt in unserem Workspace für Text-to-Video-Erstellung testen oder Pläne auf der Bonega-Preisseite einsehen, die bei $9 monatlich mit einer 3-tägigen Testphase beginnen. Wenn Ihr Projekt fortlaufende Clips über die standardmäßigen Zehn-Sekunden-Limits hinaus erfordert, beachten Sie unseren umfassenden Leitfaden zum Verlängern von KI-Videos.
Entscheidungsrahmen: Welchen KI-Videogenerator sollten Sie wählen?
Die Entscheidung, welcher KI-Videogenerator 2026 für Ihre spezifische Pipeline am besten ist, hängt von fünf unterschiedlichen Produktionsszenarien ab:
- Setzen Sie Google Veo 3.1 über die Google Gemini API-Dokumentation ein, wenn Sie fernsehtaugliche 4K-Auflösung mit gleichzeitigem nativem Dialog und Umgebungston benötigen und Ihr Budget $0.35 pro Sekunde erlaubt.
- Greifen Sie zu Runway Gen-4.5, wenn Ihr Projekt präzise Kamerapfade, Regieraster und spezialisierte redaktionelle Kontrolle in der Postproduktion erfordert.
- Wählen Sie MiniMax Hailuo H3 für die Erstellung programmatischer Anzeigenvarianten oder hochdynamischer Social-Media-Videos bei maximalem Volumen, bei denen Stückkosten von $0.045 pro Sekunde entscheidend sind.
- Verlassen Sie sich auf Kling AI 2.0 für menschlichen Gesichtsrealismus, komplexe Mikromimik und natürliche Lippensynchronisation im Zentrum Ihrer Erzählung.
- Entscheiden Sie sich für Bonega, um automatisierte mehrstufige Pipelines zu nutzen, die Keyframe-Fotorealismus mit dynamischer Bewegung verbinden und die Verwaltung einzelner Modellabonnements oder API-Wrapper überflüssig machen.
Quellen
- Google Cloud Vertex AI Preise (Google Cloud)
- Google Gemini API Dokumentation zur Videogenerierung (Google AI)
- Midjourney Video-Generierungsrichtlinien (Midjourney)
Häufig gestellte Fragen
- Welcher KI-Videogenerator ist 2026 am besten?
- Kein einzelnes Modell führt über alle kommerziellen Kriterien hinweg. Veo 3.1 liefert unerreichte filmische 4K-Klarheit mit integrierten Foley-Sounds, Runway Gen-4.5 führt bei der räumlichen Kameranavigation und Hailuo H3 bietet extrem günstige, dynamische Bewegungen. Für verlässliche Szenenkontinuität übertreffen mehrstufige Pipelines, die statische Keyframes mit Bewegungsmodellen verknüpfen, monolithische Prompts durchgehend.
- Wie viel kostet professionelle KI-Videogenerierung im Jahr 2026?
- Kommerzielle API-Preise reichen von viereinhalb Cent pro Sekunde bei leichtgewichtigen asiatischen Modellen bis zu fünfunddreißig Cent pro Sekunde für hochauflösende Google-Modi. Typische Creator-Abonnements liegen zwischen $76 und $249 pro Monat. Modulare Pipelines kosten durchschnittlich sieben Cent pro Sekunde, indem sie makellose Standbilder rendern und ausgewählte Frames animieren.
- Warum ist Image-to-Video für die Konsistenz besser als Text-to-Video?
- Direktes Text-Prompting zwingt neuronale Netze dazu, Charakteridentität, Hintergrundbeleuchtung, Bildkomposition und zeitliche Physik gleichzeitig aus Worten zu erzeugen. Dies führt zu starken Charakterverzerrungen zwischen Schnitten. Die Eingabe eines vorgerenderten Referenzbildes verankert Identität und Geometrie, sodass sich das Diffusionsnetzwerk rein auf die Berechnung flüssiger Bewegungsvektoren beschränken kann.
- Können KI-Videogeneratoren synchronisierte Soundeffekte und Dialoge erzeugen?
- Fortschrittliche Diffusionsarchitekturen erzeugen heute synchronisierte Sprache, Umgebungssoundscapes und mechanisches Foley-Audio parallel zu den visuellen Frames. Diese Fähigkeit macht eine sekundäre Audio-Postproduktion für kurze Social-Assets überflüssig, wenngleich komplexe orchestrale Untermalung oder Voiceover-Mastering weiterhin auf dedizierte externe Audio-Workstations angewiesen sind.