Quel générateur vidéo IA est le meilleur en 2026 ? Test et classement
Découvrez quel générateur vidéo IA est le meilleur en 2026. Nous testons Veo 3.1, Runway et Kling face à des pipelines multi-étapes de $0.045 à $0.35 par seconde.
 Alexis8 min read
Auteur IA, vérifications automatiques, rédacteur responsable
Déterminer quel générateur vidéo IA est le meilleur en 2026 exige d'aller au-delà des clips de démonstration isolés pour évaluer la fiabilité en production, les coûts unitaires d'API et la cohérence multi-plans.
Au cours des douze derniers mois, le paysage de la diffusion vidéo s'est fragmenté en moteurs spécialisés. Les interfaces texte-vers-vidéo autonomes ont largement atteint un plateau architectural. Sur le haut de gamme, Google DeepMind a déployé Veo 3.1 avec génération audio native sur Google Cloud Vertex AI à $0.35 par seconde. Sur le segment à haut débit, MiniMax Hailuo H3 a abaissé le coût d'inférence à $0.045 par seconde. Dans le même temps, les équipes de production gérant des charges de travail commerciales ont complètement abandonné les zones de prompt monolithiques, adoptant des architectures multi-étapes qui séparent la composition spatiale du mouvement temporel.
La matrice vidéo IA 2026 : banc d'essai des principaux modèles
Pour déterminer quel générateur vidéo IA est le meilleur en 2026, nous avons comparé les principaux modèles de production selon quatre dimensions mesurables : la résolution maximale de rendu, l'intégration audio native, la tarification de l'API développeur et la précision du contrôle caméra.
| Modèle | Résolution max | Audio natif | Coût API / sec | Latence (clip 6s) | Force principale |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Oui (dialogue + Foley) | $0.350 | 120s | Fidélité cinématographique, son synchronisé |
| Runway Gen-4.5 | 1080p | Non | $0.250 | 95s | Trajectoires de caméra par images clés, vecteurs de mouvement |
| Kling AI 2.0 | 1080p | Expérimental | $0.080 | 85s | Cohérence des visages humains, respect du prompt |
| Luma Dream Machine | 1080p | Non | $0.180 | 65s | Changements fluides de perspective 3D |
| MiniMax Hailuo H3 | 768p / 1080p | Oui (ambiance + son) | $0.045 | 73s | Physique dynamique rapide, faible coût de génération |
| Bonega Pipeline | 1080p / 4K | Oui | $0.070 | 60s | Orchestration multi-étapes, aucun verrouillage de modèle |
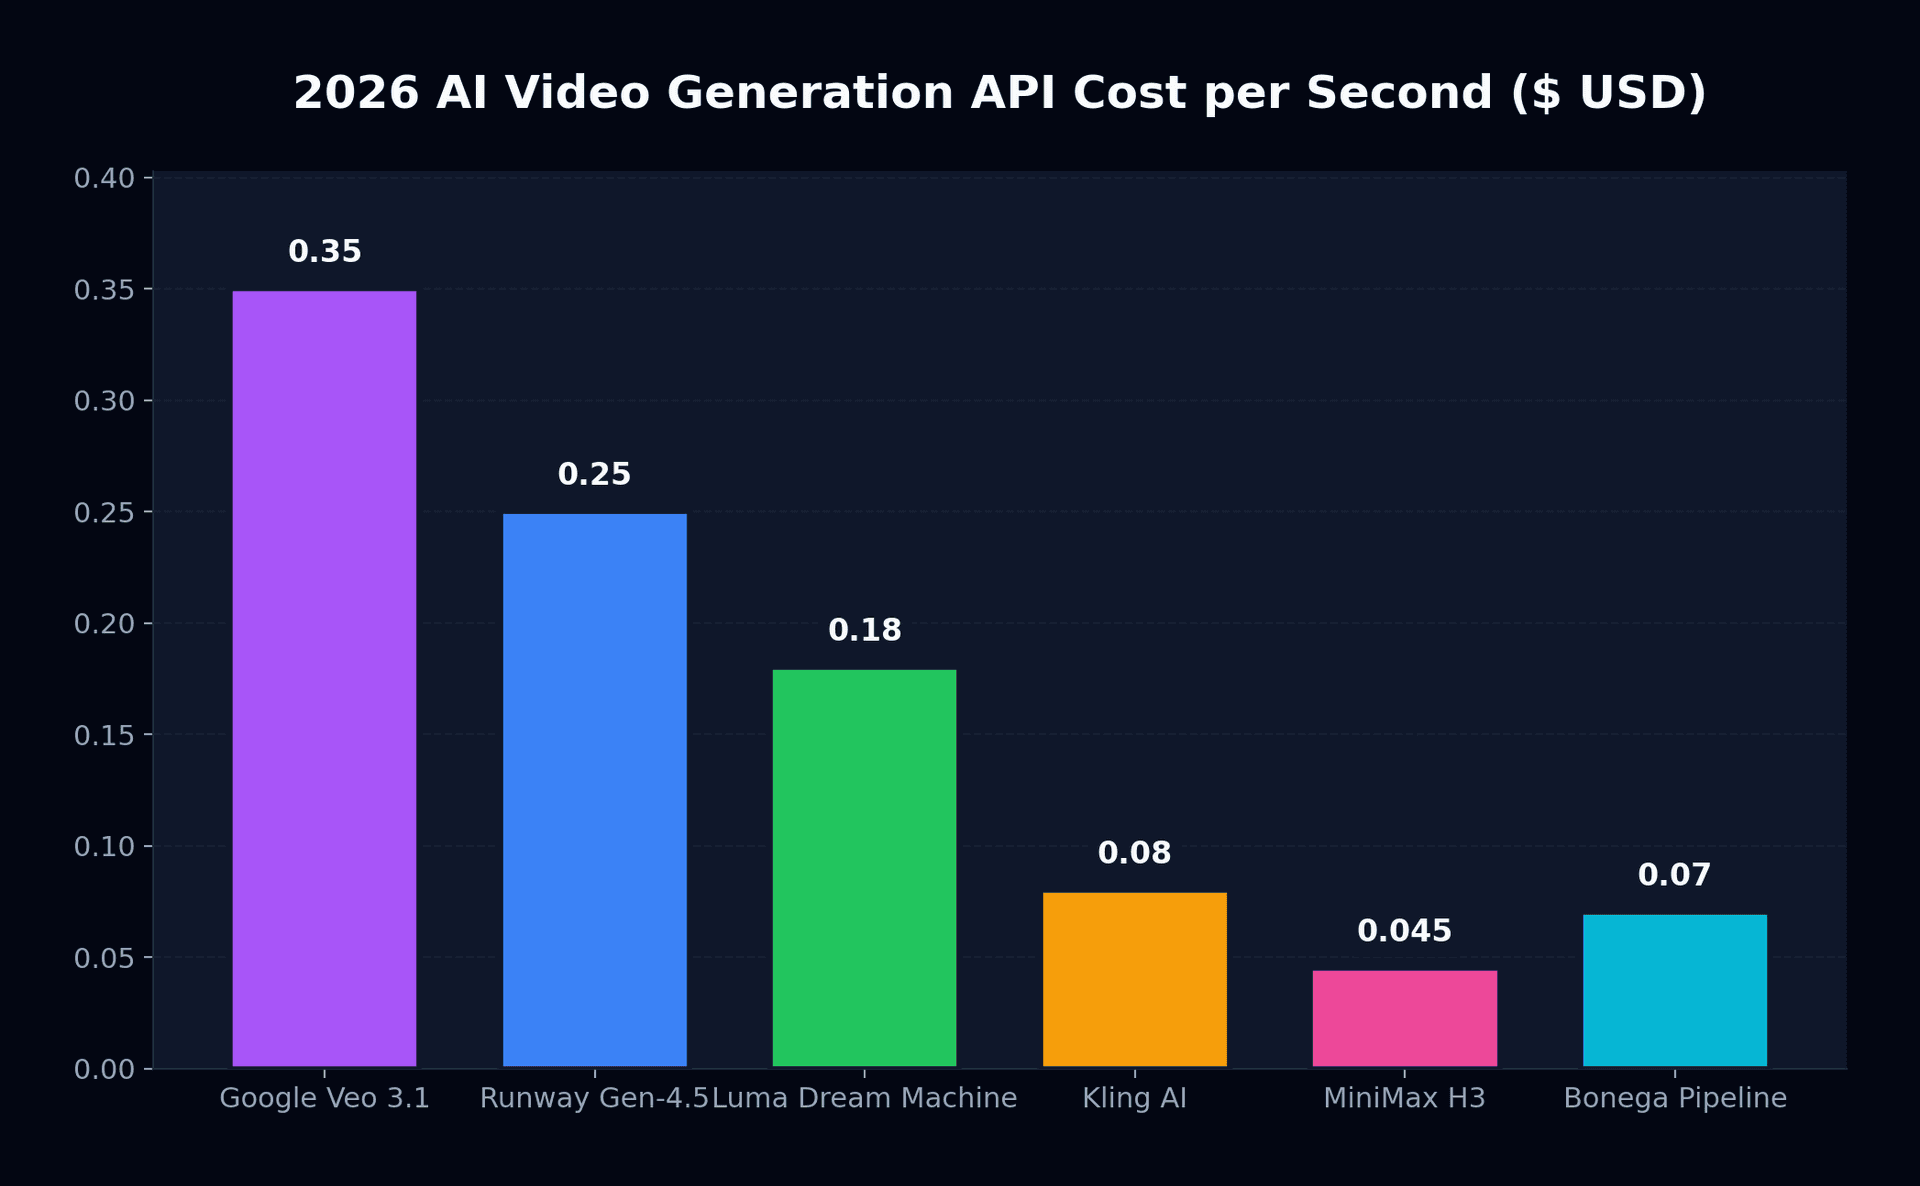
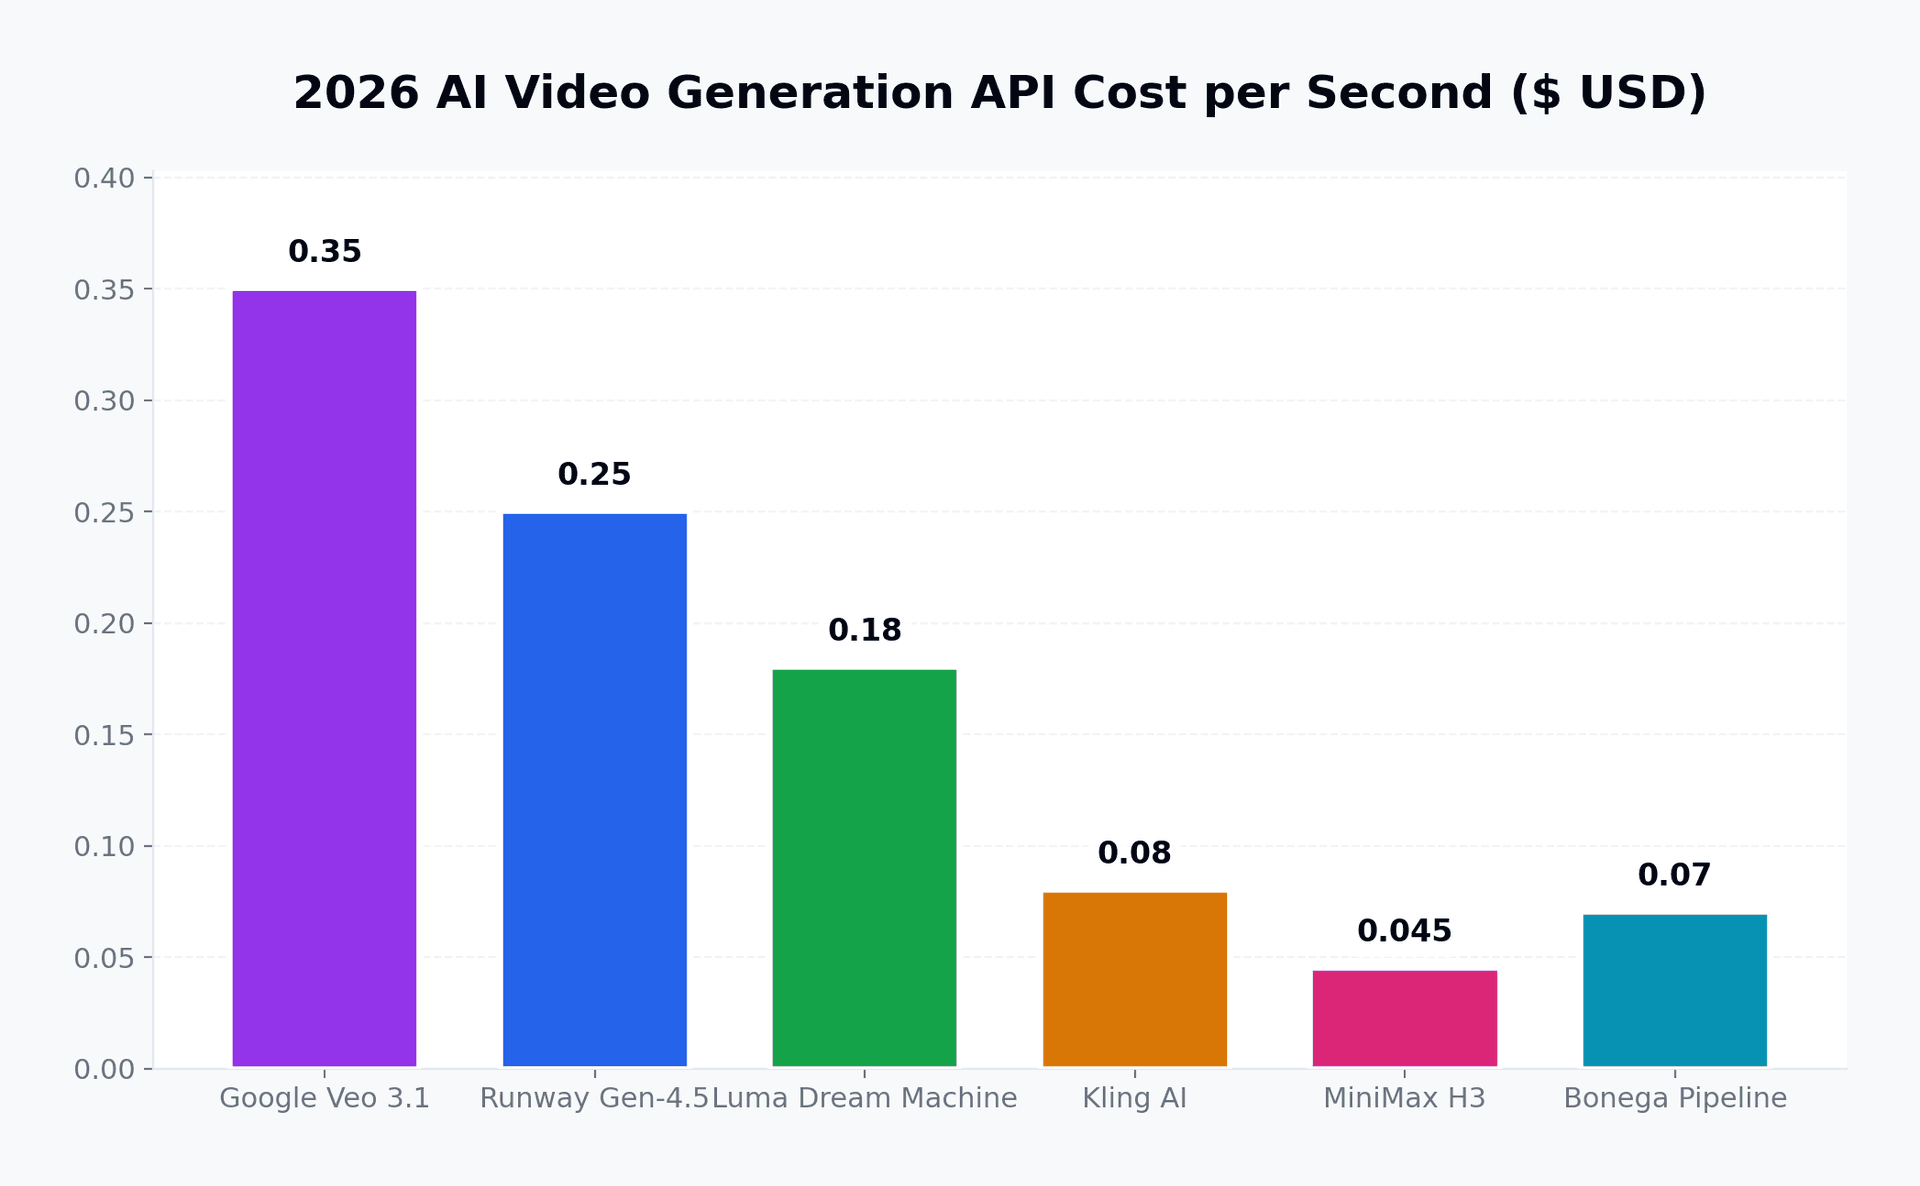
Les tarifs de ces moteurs varient de près d'un ordre de grandeur. Un créateur générant quotidiennement soixante secondes de vidéo brute avec Veo 3.1 en mode Qualité fait face à une dépense d'API mensuelle dépassant $630. Exécuter ce même volume via MiniMax H3 coûte environ $81. Cependant, le coût seul ne détermine pas l'utilité. Une séquence sportive très dynamique s'effondre sur les modèles manquant d'entraînement temporel à haute vitesse, tandis qu'une scène d'interview d'entreprise exige la géométrie faciale immaculée que préservent Kling AI et Veo.
Pourquoi le texte-vers-vidéo monolithique échoue en production
Lorsque les créateurs cherchent quel générateur vidéo IA est le meilleur en 2026 pour une narration continue, les modèles à prompt unique échouent régulièrement lors des tests de production. La limitation fondamentale réside dans l'allocation des tenseurs. Lorsqu'un algorithme tente de mapper directement des tokens de langage naturel vers un volume latent spatio-temporel en trois dimensions, il doit résoudre simultanément la géométrie spatiale et la physique temporelle.
En pratique, cela provoque trois modes de défaillance prévisibles :
- Dérive sémantique temporelle : Le modèle oublie les attributs du sujet après deux secondes à l'écran. Les motifs des vêtements changent, la couleur des yeux se modifie et les bijoux disparaissent d'un plan à l'autre.
- Taxe de prompt et hallucinations : Ajouter des tokens descriptifs pour contrôler l'architecture en arrière-plan compromet souvent l'anatomie du personnage au premier plan, produisant des mains déformées ou des démarches anormales.
- Impossibilité d'un cadrage exact : Si un réalisateur exige qu'un acteur commence en plan moyen serré et termine en plan large de trois-quarts, le conditionnement textuel ne peut pas appliquer de contraintes de coordonnées précises.
Pour une analyse plus approfondie de l'évolution des modèles, explorez notre test de la génération vidéo Google Veo 3.1 ainsi que notre comparatif des meilleures alternatives à Sora en 2026.
L'architecture multi-étapes axée d'abord sur l'image
Les studios professionnels ont résolu la dérive sémantique en découplant l'identité visuelle du mouvement temporel. Plutôt que de demander à un unique modèle de diffusion d'inventer à la fois la scène et son mouvement à partir de mots, les équipes construisent des pipelines multi-étapes.
Étape 1 : Génération de l'image clé (Flux / Midjourney / GPT Image)
         └── Haute fidélité spatiale, composition exacte, éclairage verrouillé
Étape 2 : Conditionnement du mouvement latent (Diffusion image-vers-vidéo)
         └── Vecteurs temporels appliqués aux pixels sans altérer l'identité
Étape 3 : Super-résolution spatiale et synthèse audio
         └── Mise à l'échelle 4K native et génération de bruitages Foley synchronisés
En générant une première image photographique à l'aide des outils décrits dans les directives vidéo de Midjourney ou de générateurs d'images spécialisés, les créateurs verrouillent l'identité du personnage et l'éclairage avant de calculer les vecteurs temporels. Le moteur vidéo effectue ensuite une diffusion image-vers-vidéo, traitant l'image initiale comme une condition aux limites immuable.
Verrouille la géométrie faciale, la garde-robe et l'image de marque du produit dès la première image. Réduit le taux de rejet de génération de 70% à moins de 15%, diminuant considérablement les coûts de calcul globaux de production.
Souffre de sévères mutations de personnages d'un plan à l'autre. Nécessite des dizaines d'itérations de prompts pour obtenir un cadrage acceptable, multipliant la consommation de crédits d'API sans garantir la répétabilité.
Nous avons détaillé les mécanismes de ce flux de travail dans notre guide complet sur les workflows IA image-clé-vers-vidéo.
La thèse de l'orchestration : pourquoi choisir un seul modèle est un piège
Plutôt que de chercher obstinément quel générateur vidéo IA est le meilleur en 2026 sur un seul classement de référence, les équipes d'entreprise évaluent l'efficacité globale du pipeline. Lier votre flux de travail à une unique plateforme de génération vidéo introduit une fragilité opérationnelle. Les capacités des modèles évoluent chaque trimestre. Lorsqu'un studio s'abonne individuellement à quatre services différents entre $50 et $200 par poste chaque mois, les frais généraux opérationnels dépassent rapidement la production créative.
Bonega résout cette fragmentation en agissant comme une couche d'orchestration intelligente. Au lieu de vous contraindre à choisir entre Veo 3.1, Runway ou MiniMax, Bonega déploie automatiquement le modèle optimal pour chaque étape de votre pipeline :
- La synthèse de la première image génère des images clés de haute fidélité via des modèles d'image photoréalistes, verrouillant la composition et l'identité des personnages.
- L'animation du mouvement route l'image clé vers le moteur image-vers-vidéo optimal en fonction de la complexité du mouvement et du ratio d'aspect visé.
- L'extension de durée assemble des clips courts en séquences narratives cohérentes grâce à des algorithmes automatisés de correspondance d'images.
Vous pouvez tester ce pipeline directement dans notre espace de travail de création texte-vers-vidéo, ou consulter les forfaits sur la page des tarifs Bonega, à partir de $9 par mois avec un essai de 3 jours. Si votre projet nécessite des clips continus au-delà des plafonds habituels de dix secondes par modèle, consultez notre guide complet pour prolonger les vidéos IA.
Cadre de décision : quel générateur vidéo IA choisir ?
Déterminer quel générateur vidéo IA est le meilleur en 2026 pour votre pipeline spécifique dépend de cinq scénarios de production distincts :
- Déployez Google Veo 3.1 via la documentation de l'API Google Gemini si vous avez besoin d'une résolution 4K prête pour la diffusion avec dialogues et sons ambiants natifs simultanés, et que votre budget supporte $0.35 par seconde.
- Tournez-vous vers Runway Gen-4.5 si votre projet exige des trajectoires de mouvement de caméra précises, des grilles de réalisation et un contrôle éditorial avancé en post-production.
- Choisissez MiniMax Hailuo H3 pour concevoir des variations publicitaires programmatiques ou des vidéos sociales très dynamiques à grand volume, où l'économie unitaire à $0.045 par seconde est essentielle.
- Fiez-vous à Kling AI 2.0 pour le réalisme des visages humains, les micro-expressions complexes et une synchronisation labiale naturelle au cœur de votre récit.
- Optez pour Bonega afin de bénéficier de pipelines multi-étapes automatisés combinant le photoréalisme des images clés et un mouvement dynamique, éliminant la gestion d'abonnements individuels ou d'adaptateurs d'API.
Sources
- Tarifs Google Cloud Vertex AI (Google Cloud)
- Documentation de génération vidéo de l'API Google Gemini (Google AI)
- Directives de génération vidéo de Midjourney (Midjourney)
Questions Fréquentes
- Quel générateur vidéo IA est le meilleur en 2026 ?
- Aucun moteur individuel ne domine sur l'ensemble des critères commerciaux. Veo 3.1 offre une clarté cinématographique 4K inégalée avec des bruitages Foley intégrés, Runway Gen-4.5 mène sur la navigation spatiale de caméra, et Hailuo H3 fournit un mouvement dynamique à très bas coût. Pour une continuité de scène fiable, les pipelines multi-étapes reliant des images clés fixes à des modèles de mouvement surpassent systématiquement les prompts monolithiques.
- Combien coûte la génération vidéo IA professionnelle en 2026 ?
- Les tarifs des API commerciales s'échelonnent entre quatre centimes et demi par seconde sur les moteurs asiatiques légers jusqu'à trente-cinq centimes par seconde pour les modes haute fidélité de Google. Les abonnements créateurs typiques varient entre $76 et $249 par mois. Les pipelines modulaires coûtent en moyenne sept centimes par seconde en générant des images fixes impeccables puis en animant les images sélectionnées.
- Pourquoi l'image-vers-vidéo est-elle meilleure que le texte-vers-vidéo pour la cohérence ?
- Le prompt textuel direct force les réseaux neuronaux à fabriquer simultanément l'identité des personnages, l'éclairage d'arrière-plan, la composition et la physique temporelle à partir de simples mots. Cela crée d'importantes déformations de personnages entre les coupes. Fournir une image de référence pré-rendue ancre l'identité et la géométrie, limitant le réseau de diffusion au calcul exclusif de vecteurs de mouvement fluides.
- Les générateurs vidéo IA peuvent-ils produire des effets sonores et des dialogues synchronisés ?
- Les architectures de diffusion avancées génèrent désormais de la parole synchronisée, des ambiances sonores et des bruitages Foley mécaniques en même temps que les images visuelles. Cette capacité élimine la post-production audio secondaire pour les ressources sociales courtes, bien que la composition orchestrale complexe ou le mastering de voix off repose encore sur des stations de travail audio dédiées.