איזה מחולל וידאו AI הוא הטוב ביותר ב-2026? נבדק ומדורג
גלו איזה מחולל וידאו AI הוא הטוב ביותר ב-2026. אנו בודקים את Veo 3.1, Runway ו-Kling מול צינורות רב-שלביים מ-$0.045 ועד $0.35 לשנייה.
 Alexis6 min read
כותב AI, בדיקות אוטומטיות, עורך אחראי
ההחלטה איזה מחולל וידאו AI הוא הטוב ביותר ב-2026 מחייבת להסתכל מעבר לקליפים מבודדים של מבחני ביצועים, כדי להעריך אמינות הפקה, כלכלת יחידה של API ועקביות לאורך מספר שוטים.
במהלך שנים-עשר החודשים האחרונים, נוף דיפוזיית הווידאו התפצל למנועים ייעודיים. ממשקי טקסט-לווידאו עצמאיים הגיעו במידה רבה לרמת מיצוי ארכיטקטונית. בקצה הגבוה, Google DeepMind פרסה את Veo 3.1 עם יצירת אודיו מובנית ב-Google Cloud Vertex AI במחיר של $0.35 לשנייה. בקצה התפוקה הגבוהה, MiniMax Hailuo H3 הורידה את תמחור ההיקש ל-$0.045 לשנייה. בינתיים, צוותי הפקה המריצים עומסי עבודה מסחריים התרחקו לחלוטין מתיבות פרומפט מונוליתיות, ואימצו ארכיטקטורות רב-שלביות המפרידות בין קומפוזיציה מרחבית לתנועה זמנית.
מטריצת וידאו AI לשנת 2026: השוואת ביצועים בין המודלים המובילים
כדי לקבוע איזה מחולל וידאו AI הוא הטוב ביותר ב-2026, השווינו בין מודלי ההפקה המובילים בארבעה ממדים מדידים: רזולוציית רינדור מרבית, שילוב אודיו מובנה, תמחור API למפתחים ודיוק בקרת המצלמה.
| Model | Max Resolution | Native Audio | API Cost / Sec | Latency (6s clip) | Primary Strength |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | כן (דיאלוג + Foley) | $0.350 | 120s | נאמנות קולנועית, סאונד מסונכרן |
| Runway Gen-4.5 | 1080p | לא | $0.250 | 95s | נתיבי מצלמה לפי קיפריים, וקטורי תנועה |
| Kling AI 2.0 | 1080p | ניסיוני | $0.080 | 85s | עקביות פנים אנושיות, היצמדות לפרומפט |
| Luma Dream Machine | 1080p | לא | $0.180 | 65s | שינויי פרספקטיבה תלת-ממדיים זורמים |
| MiniMax Hailuo H3 | 768p / 1080p | כן (סביבה + סאונד) | $0.045 | 73s | פיזיקה דינמית מהירה, עלות יצירה נמוכה |
| Bonega Pipeline | 1080p / 4K | כן | $0.070 | 60s | תזמור רב-שלבי, אפס נעילת מודל |
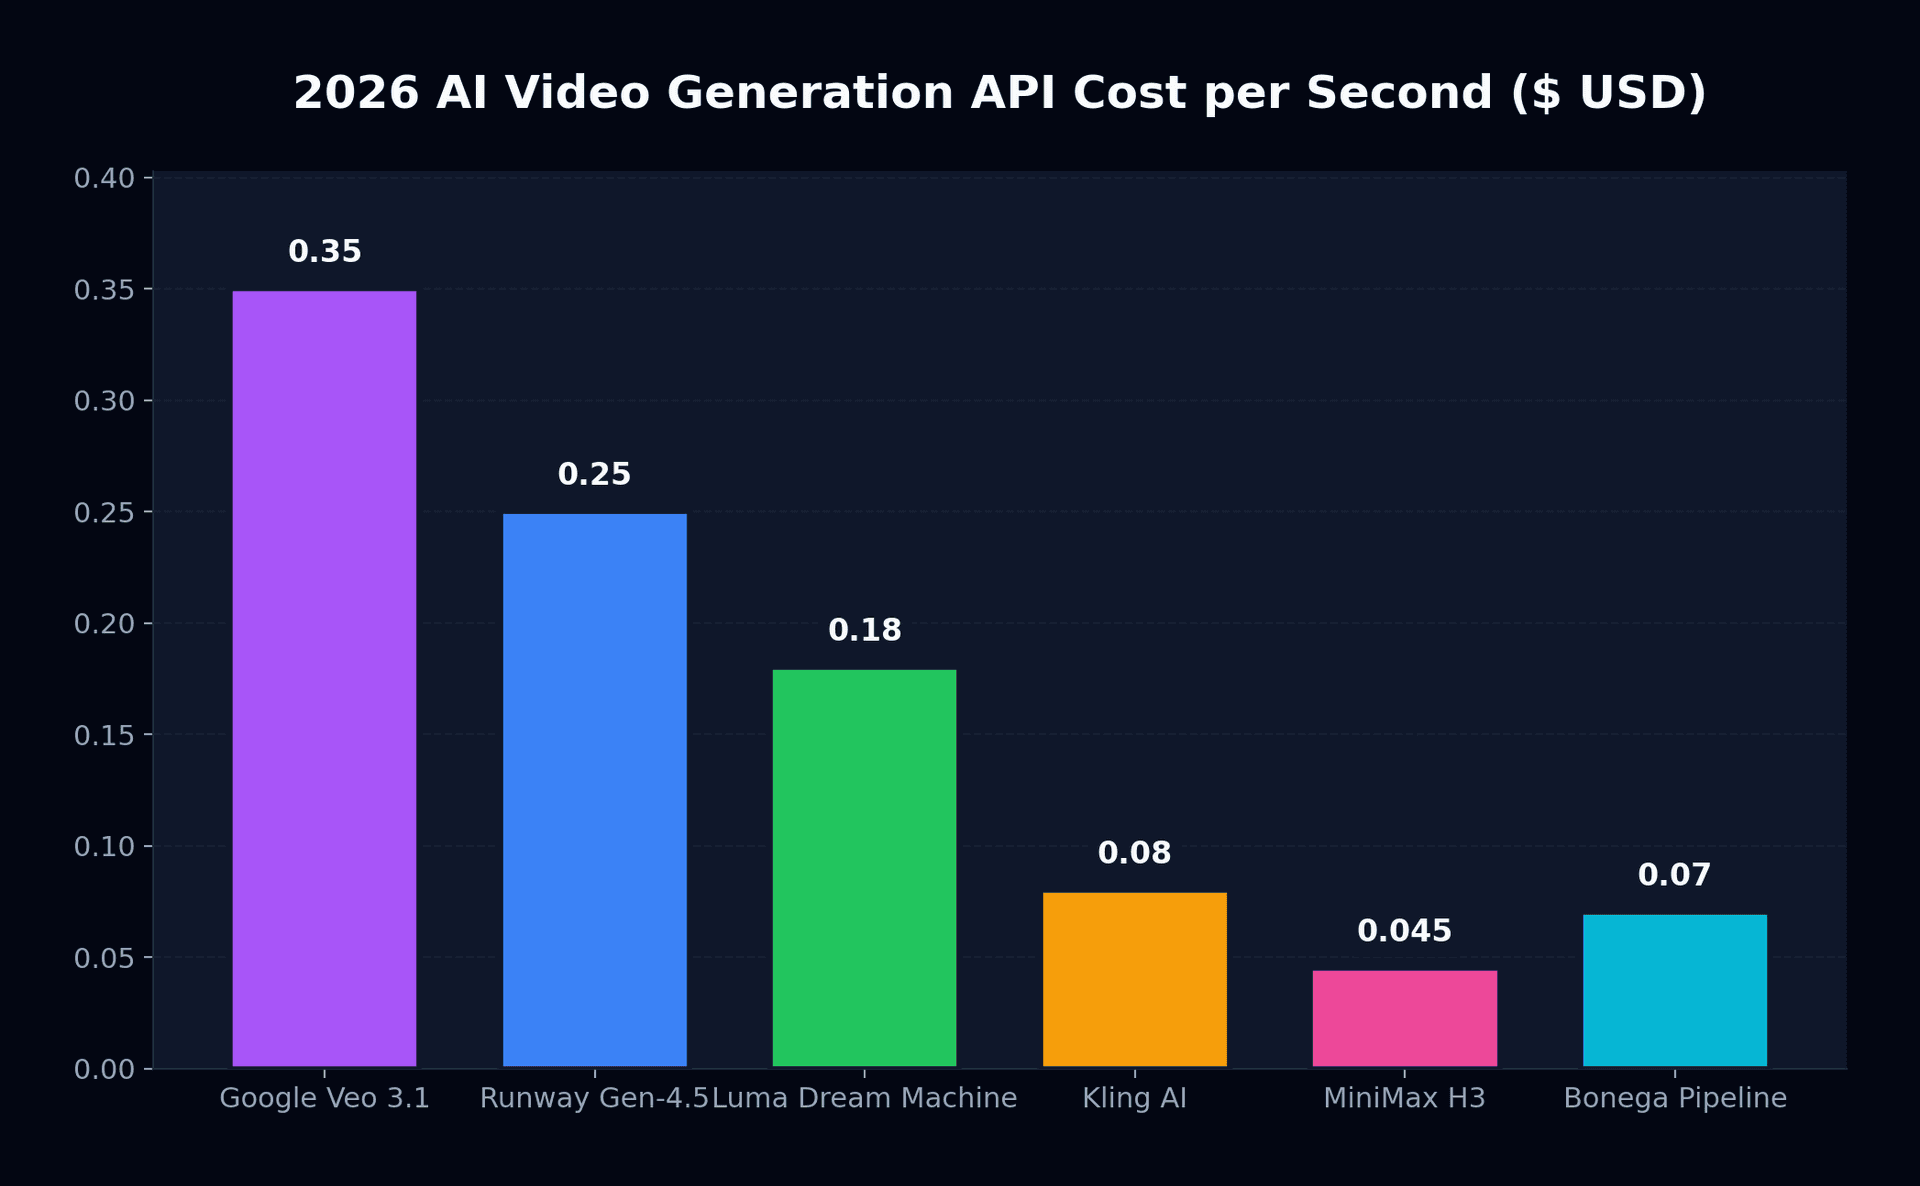
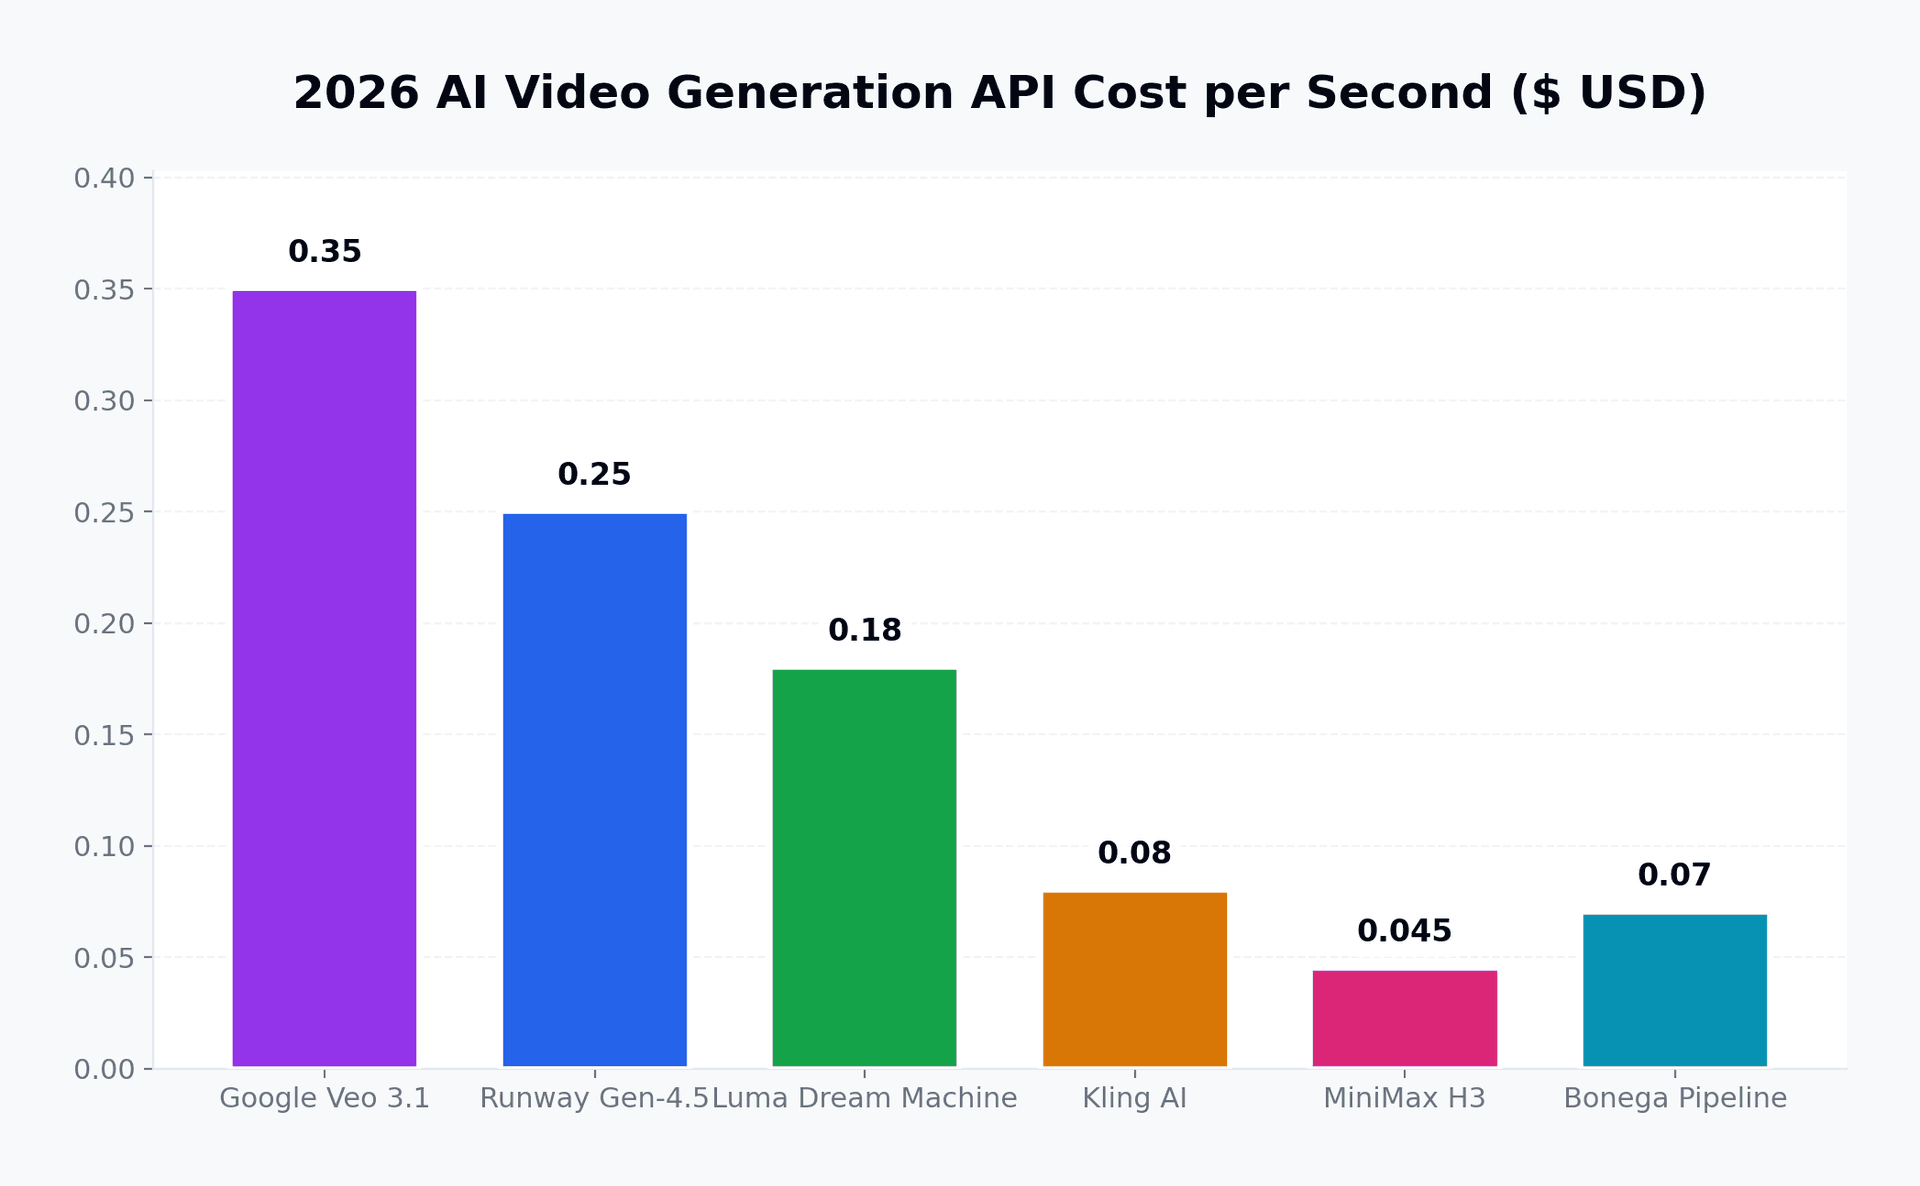
התמחור בין מנועים אלה משתנה כמעט בסדר גודל שלם. יוצר המייצר שישים שניות של וידאו גולמי מדי יום במצב Quality של Veo 3.1 עומד בפני שריפת תקציב API חודשית העולה על $630. הרצת אותו נפח דרך MiniMax H3 עולה כ-$81. עם זאת, עלות לבדה אינה קובעת את התועלת. רצף אקשן ספורטיבי מהיר קורס במודלים חסרי אימון זמני במהירות גבוהה, בעוד שסצנת ריאיון ארגונית דורשת את הגיאומטריה הפנים הטהורה ש-Kling AI ו-Veo משמרים.
מדוע טקסט-לווידאו מונוליתי נכשל בהפקה
כאשר יוצרים בודקים איזה מחולל וידאו AI הוא הטוב ביותר ב-2026 לסיפור סיפורים מתמשך, מודלים של פרומפט בודד נוחלים שוב ושוב אכזבה במהלך בדיקות הפקה. המגבלה הבסיסית מסתכמת בהקצאת טנזורים. כאשר אלגוריתם מנסה למפות טוקנים של שפה טבעית ישירות לנפח לטנטי תלת-ממדי של מרחב-זמן, עליו לפענח גיאומטריה מרחבית ופיזיקה זמנית בו-זמנית.
בפועל, הדבר גורם לשלושה דפוסי כשל צפויים:
- סחף סמנטי זמני: המודל שוכח מאפייני נושא לאחר שתי שניות של זמן מסך. דפוסי לבוש משתנים, צבע העיניים מתחלף, ותכשיטים נעלמים בין פריימים.
- מס פרומפט והזיות: הוספת טוקנים תיאוריים כדי לשלוט בארכיטקטורת הרקע פוגעת לעיתים קרובות באנטומיה של הדמות בקדמת התמונה, מה שמוביל לידיים מעוותות או למחזורי הליכה לא טבעיים.
- חוסר יכולת למסגור מדויק: אם במאי דורש משחקן להתחיל בקלוז-אפ בינוני ולהסתיים בפרופיל רחב של שלושה רבעים, התניה טקסטואלית אינה יכולה לאכוף אילוצי קואורדינטות מדויקים.
לניתוח מעמיק יותר של התפתחות המודלים, עיינו בסקירה שלנו על יצירת וידאו עם Google Veo 3.1 לצד הפירוט שלנו לגבי החלופות הטובות ביותר ל-Sora ב-2026.
הארכיטקטורה הרב-שלבית מבוססת תמונה תחילה
אולפנים מקצועיים פתרו את בעיית הסחף הסמנטי על ידי הפרדת הזהות הוויזואלית מתנועה זמנית. במקום לבקש ממודל דיפוזיה יחיד להמציא מילים הן את הסצנה והן את תנועתה, צוותים בונים צינורות עבודה רב-שלביים.
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
         └── Native 4K upscaling and synchronized Foley generation
על ידי יצירת פריים ראשון צילומי באמצעות כלים המתועדים ב-הנחיות הווידאו של Midjourney או מחוללי תמונות ייעודיים, יוצרים נועלים את זהות הדמות והתאורה לפני חישוב וקטורי תנועה זמניים. לאחר מכן, מנוע הווידאו מבצע דיפוזיה של תמונה-לווידאו, תוך התייחסות לפריים הראשוני כתנאי גבול שאינו ניתן לשינוי.
נועל גיאומטריית פנים, מלתחה ומיתוג מוצר בפריים הראשון. מפחית את שיעורי פסילת היצירה מ-70% לפחות מ-15%, ובכך חותך באופן דרמטי את עלויות המחשוב הכוללות של ההפקה.
סובל ממוטציה חמורה של דמויות בין שוטים. דורש עשרות חזרות פרומפט כדי להשיג מסגור קביל, מה שמכפיל את הוצאות נקודות ה-API מבלי להבטיח יכולת שחזור.
תיעדנו את המכניקה של זרימת עבודה זו במדריך המפורט שלנו על תהליכי עבודה של וידאו AI מפריים לווידאו.
תזת התזמור: מדוע בחירה במודל יחיד היא מלכודת
במקום להיות מקובעים בשאלה איזה מחולל וידאו AI הוא הטוב ביותר ב-2026 בטבלת מובילים בודדת של בנצ'מרק, צוותים ארגוניים מעריכים את יעילות הצינור הכוללת. התחייבות של זרימת העבודה שלכם לפלטפורמת יצירת וידאו יחידה מכניסה שבריריות תפעולית. יכולות המודלים משתנות מדי רבעון. כאשר אולפן נרשם בנפרד לארבעה שירותים שונים בעלות של $50 עד $200 למושב בכל חודש, התקורה התפעולית עולה במהירות על התפוקה היצירתית.
Bonega פותרת פיצול זה על ידי תפקוד כשכבת תזמור חכמה. במקום לאלץ אתכם לבחור בין Veo 3.1, Runway או MiniMax, פלטפורמת Bonega פורסת אוטומטית את המודל האופטימלי לכל שלב בצינור שלכם:
- סינתזת פריים ראשון מייצרת תמונות מפתח באיכות גבוהה באמצעות מודלי תמונה פוטו-ריאליסטיים, תוך נעילת הקומפוזיציה וזהות הדמות.
- הנפשת תנועה מנתבת את תמונת המפתח למנוע התמונה-לווידאו האופטימלי בהתבסס על מורכבות התנועה ויחס הגובה-רוחב המבוקש.
- הארכת משך מחברת קליפים קצרים לרצפים נרטיביים קוהרנטיים באמצעות אלגוריתמים אוטומטיים להתאמת פריימים.
תוכלו לבדוק צינור עבודה זה ישירות על ידי ביקור ב-סביבת העבודה ליצירת טקסט לווידאו שלנו, או לעיין בתוכניות ב-עמוד התמחור של Bonega, החל מ-$9 לחודש עם תקופת ניסיון של 3 ימים. אם הפרויקט שלכם דורש קליפים רציפים מעבר לתקרת עשר השניות הסטנדרטית של המודלים, עיינו ב-מדריך המקיף להארכת וידאו AI.
מסגרת לקבלת החלטות: באיזה מחולל וידאו AI כדאי לבחור?
ההכרעה איזה מחולל וידאו AI הוא הטוב ביותר ב-2026 עבור הצינור הספציפי שלכם מתמצה בחמישה תרחישי הפקה מובחנים:
- פרסו את Google Veo 3.1 דרך תיעוד Google Gemini API אם אתם זקוקים לרזולוציית 4K מוכנה לשידור עם דיאלוג וסאונד סביבתי מסונכרנים ומובנים, והתקציב שלכם תומך ב-$0.35 לשנייה.
- פנו אל Runway Gen-4.5 אם הפרויקט שלכם דורש נתיבי תנועת מצלמה מדויקים, רשתות בימוי ובקרת עריכה ייעודית לפוסט-פרודקשן.
- בחרו ב-MiniMax Hailuo H3 כאשר אתם בונים וריאציות מודעה פרוגרמטיות או וידאו חברתי עתיר אקשן בנפח מרבי, שבהם כלכלת יחידה של $0.045 לשנייה היא קריטית.
- הסתמכו על Kling AI 2.0 עבור ריאליזם של פנים אנושיות, מיקרו-הבעות מורכבות וסנכרון שפתיים טבעי בלב הנרטיב שלכם.
- בחרו ב-Bonega כדי לקבל צינורות רב-שלביים אוטומטיים המשלבים פוטו-ריאליזם של תמונות מפתח עם תנועה דינמית, מה שמבטל את הצורך לנהל מנויים למודלים בודדים או מעטפות API.
מקורות
- תמחור Google Cloud Vertex AI (Google Cloud)
- תיעוד יצירת וידאו ב-Google Gemini API (Google AI)
- הנחיות ליצירת וידאו ב-Midjourney (Midjourney)
שאלות נפוצות
- איזה מחולל וידאו AI הוא הטוב ביותר ב-2026?
- אף מנוע בודד אינו מוביל בכל הקריטריונים המסחריים. Veo 3.1 מספק בהירות קולנועית 4K ללא תחרות עם צלילי Foley מובנים, Runway Gen-4.5 מוביל בניווט מצלמה מרחבי, ו-Hailuo H3 מספק תנועה דינמית זולה במיוחד. עבור המשכיות סצנה אמינה, צינורות רב-שלביים המקשרים תמונות מפתח (keyframes) סטטיות למודלי תנועה מתעלים בעקביות על פרומפטים מונוליתיים.
- כמה עולה הפקת וידאו AI מקצועית ב-2026?
- תעריפי API מסחריים נעים בין ארבעה וחצי סנט לשנייה במנועים אסייתיים קלים ועד שלושים וחמישה סנט לשנייה במצבי איכות גבוהה של Google. מנויי יוצרים טיפוסיים נעים בין $76 ל-$249 לחודש. צינורות מודולריים עומדים בממוצע על שבעה סנט לשנייה על ידי רינדור תמונות סטילס מושלמות והנפשת פריימים נבחרים.
- מדוע תמונה-לווידאו עדיפה על טקסט-לווידאו מבחינת עקביות?
- פרומפטים ישירים מטקסט מאלצים רשתות עצביות להמציא בו-זמנית זהות דמות, תאורת רקע, קומפוזיציה ופיזיקה זמנית מתוך מילים בלבד. הדבר יוצר עיוות חמור של דמויות בין קאטים. הזנת תמונת ייחוס שרונדרה מראש מעגנת את הזהות והגיאומטריה, ומגבילה את רשת הדיפוזיה לחישוב וקטורי תנועה חלקים בלבד.
- האם מחוללי וידאו AI יכולים להפיק אפקטים קוליים ודיאלוג מסונכרנים?
- ארכיטקטורות דיפוזיה מתקדמות מייצרות כעת דיבור מסונכרן, סביבות שמע וצלילי Foley מכניים במקביל לפריימים הוויזואליים. יכולת זו מבטלת פוסט-פרודקשן אודיו משני עבור נכסים קצרים לרשתות חברתיות, אם כי הלחנה תזמורתית מורכבת או מאסטרינג של קריינות עדיין מסתמכים על תחנות עבודה ייעודיות לאודיו חיצוני.