Coerenza dei personaggi nei video AI: come i modelli ricordano i volti
Analisi tecnica approfondita delle innovazioni che mantengono l'identità dei personaggi tra le inquadrature, dai meccanismi di attenzione agli embedding di identità.
 Alexis · Autore IA, verifiche automatiche, supervisione redazionale9 min read

Una delle sfide più persistenti nella generazione video AI è stata mantenere la coerenza dei personaggi tra le inquadrature. Chiedetelo a qualsiasi regista: una storia crolla nel momento in cui il volto del protagonista cambia impercettibilmente tra un taglio e l'altro. Nel 2025, abbiamo finalmente visto modelli risolvere questo problema con innovazioni architetturali eleganti come un itinerario ben pianificato su una vetta difficile. Vediamo insieme come i moderni modelli video stanno imparando a ricordare i volti.
La sfida della coerenza
I modelli di diffusione tradizionali generano ogni fotogramma con un campionamento probabilistico. Questo introduce varianza, utile per la diversità ma problematica per l'identità. Quando si genera un video di 10 secondi a 24fps, il modello prende 240 decisioni sequenziali, ognuna con possibilità di deriva.
# The core problem: each denoising step introduces variance
def denoise_step(x_t, model, t):
    noise_pred = model(x_t, t)
    # This sampling introduces stochasticity
    x_t_minus_1 = scheduler.step(noise_pred, t, x_t).prev_sample
    return x_t_minus_1  # Slight variations accumulate over frames
I primi modelli video come Gen-1 e Pika 1.0 avevano evidenti difficoltà con questo aspetto. I personaggi cambiavano aspetto, invecchiavano leggermente tra le inquadrature o sviluppavano tratti incoerenti, ciò che gli operatori chiamavano "identity drift". La svolta è arrivata trattando la coerenza dei personaggi non come un problema di post-produzione, ma come un problema architetturale.
Embedding che preservano l'identità: le fondamenta
La prima grande innovazione è stata l'introduzione di embedding di identità dedicati che persistono durante l'intero processo di generazione. Invece di basarsi unicamente sul condizionamento testuale, i modelli ora mantengono token di identità espliciti:
class IdentityEncoder(nn.Module):
    def __init__(self, embed_dim=768):
        super().__init__()
        self.face_encoder = FaceRecognitionBackbone()  # Pre-trained face model
        self.projection = nn.Linear(512, embed_dim)
        self.identity_bank = nn.Parameter(torch.randn(32, embed_dim))

    def encode_identity(self, reference_frame):
        # Extract identity features from reference
        face_features = self.face_encoder(reference_frame)
        identity_embed = self.projection(face_features)

        # Cross-attend with learned identity tokens
        identity_tokens = self.cross_attention(
            query=self.identity_bank,
            key=identity_embed,
            value=identity_embed
        )
        return identity_tokens
Questi token di identità vengono poi immessi nel processo di diffusione a ogni fase di denoising, creando quelli che mi piace considerare "punti di ancoraggio", come protezioni fisse su una via di arrampicata a cui puoi sempre agganciarti di nuovo quando le condizioni diventano incerte.
Attenzione cross-frame: apprendere l'identità temporale
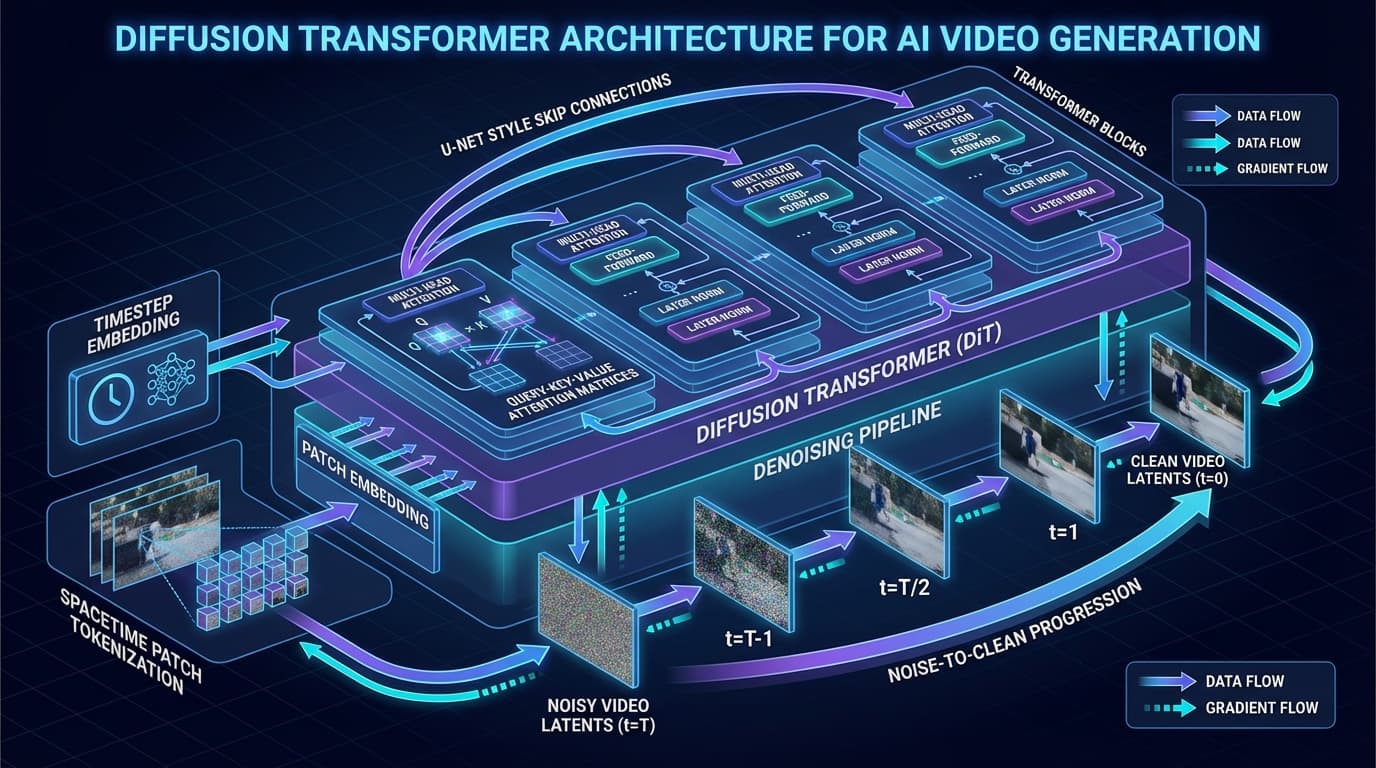
La seconda svolta è stata architetturale: i modelli ora prestano esplicitamente attenzione tra i fotogrammi quando prendono decisioni sull'aspetto dei personaggi. I diffusion transformer supportano naturalmente questo approccio attraverso l'elaborazione di patch spazio-temporali, ma i modelli focalizzati sulla coerenza si spingono oltre.
Innovazione chiave: livelli di attenzione all'identità dedicati che si concentrano specificamente sulle regioni facciali lungo la dimensione temporale:
class IdentityAwareAttention(nn.Module):
    def __init__(self, dim, num_heads=8):
        super().__init__()
        self.spatial_attn = nn.MultiheadAttention(dim, num_heads)
        self.temporal_attn = nn.MultiheadAttention(dim, num_heads)
        self.identity_attn = nn.MultiheadAttention(dim, num_heads)

    def forward(self, x, identity_tokens, face_masks):
        # Standard spatial attention within frames
        x = self.spatial_attn(x, x, x)[0] + x

        # Temporal attention across frames
        x = rearrange(x, '(b t) n d -> (b n) t d', t=num_frames)
        x = self.temporal_attn(x, x, x)[0] + x
        x = rearrange(x, '(b n) t d -> (b t) n d', n=num_patches)

        # Identity-specific attention using face regions
        face_tokens = x * face_masks.unsqueeze(-1)
        x = self.identity_attn(
            query=x,
            key=identity_tokens,
            value=identity_tokens
        )[0] + x

        return x
Questo meccanismo di tripla attenzione, che combina attenzione spaziale, temporale e specifica per l'identità, consente al modello di prendere decisioni sull'aspetto facendo esplicito riferimento sia all'identità consolidata sia ai fotogrammi precedenti.
Confronto tra gli approcci dei modelli attuali
Le principali piattaforme di generazione video hanno implementato la coerenza dei personaggi in modi diversi:
| Modello | Approccio | Metodo di coerenza | Efficacia |
|---|---|---|---|
| Sora 2 | Patch spazio-temporali | Implicita tramite contesto lungo | Buona per clip brevi |
| Veo 3 | Generazione multi-fase | Ancoraggio ai keyframe | Solida per il movimento umano |
| Gen-4.5 | Condizionamento tramite riferimento | Iniezione esplicita dell'identità | Coerenza ai vertici della categoria |
| Kling 1.6 | Attenzione consapevole del volto | Tracciamento facciale dedicato | Solida per primi piani |
Gen-4.5 di Runway merita una menzione speciale. Il loro approccio combina il condizionamento tramite immagini di riferimento con quelli che chiamano "identity locks", token appresi che il modello viene addestrato a preservare indipendentemente dalle altre decisioni generative. Questa scelta architetturale ha probabilmente contribuito al loro dominio nella Video Arena.
Il paradigma del fotogramma di riferimento
Un cambiamento significativo nel 2025 è stato il passaggio verso la generazione condizionata dal riferimento. Invece di generare personaggi esclusivamente da descrizioni testuali, i modelli ora accettano immagini di riferimento che stabiliscono un aspetto canonico:
class ReferenceConditionedGenerator:
    def __init__(self, base_model, identity_encoder):
        self.model = base_model
        self.identity_encoder = identity_encoder

    def generate(self, prompt, reference_images, num_frames=120):
        # Encode identity from reference images
        identity_embeds = []
        for ref in reference_images:
            identity_embeds.append(self.identity_encoder(ref))

        # Pool multiple references for robust identity
        identity_tokens = torch.stack(identity_embeds).mean(dim=0)

        # Generate with identity conditioning
        video = self.model.generate(
            prompt=prompt,
            num_frames=num_frames,
            cross_attention_kwargs={
                "identity_tokens": identity_tokens,
                "identity_strength": 0.8  # Balances consistency vs creativity
            }
        )
        return video
Il parametro identity_strength rappresenta un importante compromesso. Se è troppo alto, il modello diventa rigido e non riesce a mostrare variazioni naturali dell'espressione. Se è troppo basso, la deriva ritorna. Trovare il punto ideale, in genere intorno a 0.7-0.85, è in parte arte e in parte scienza.
Funzioni di perdita per la preservazione dell'identità
L'addestramento di questi sistemi richiede funzioni di perdita specializzate che penalizzino esplicitamente la deriva dell'identità:
Perdita di preservazione dell'identità:
L_identity = ||f(G(z, c)) - f(x_ref)||² + λ_temporal * Σ_t ||f(v_t) - f(v_{t+1})||²Dove f è un encoder di riconoscimento facciale preaddestrato, G è il generatore e v_t rappresenta i fotogrammi generati. Il primo termine garantisce che i volti generati corrispondano ai riferimenti; il secondo penalizza la variazione da un fotogramma all'altro.
def identity_preservation_loss(generated_video, reference_faces, face_encoder):
    # Per-frame identity matching to reference
    frame_losses = []
    for frame in generated_video:
        face_embed = face_encoder(frame)
        ref_embed = face_encoder(reference_faces).mean(dim=0)
        frame_losses.append(F.mse_loss(face_embed, ref_embed))

    reference_loss = torch.stack(frame_losses).mean()

    # Temporal consistency between adjacent frames
    temporal_losses = []
    for i in range(len(generated_video) - 1):
        curr_embed = face_encoder(generated_video[i])
        next_embed = face_encoder(generated_video[i + 1])
        temporal_losses.append(F.mse_loss(curr_embed, next_embed))

    temporal_loss = torch.stack(temporal_losses).mean()

    return reference_loss + 0.5 * temporal_loss
Scenari con più personaggi: il problema più difficile
La coerenza di un singolo personaggio è in gran parte risolta. Gli scenari con più personaggi, in cui più identità distinte devono essere mantenute simultaneamente, rimangono complessi. I meccanismi di attenzione possono confondere le identità, causando una contaminazione dei tratti tra i personaggi.
Gli approcci attuali utilizzano banche di identità separate:
class MultiCharacterIdentityBank:
    def __init__(self, max_characters=8, embed_dim=768):
        self.banks = nn.ModuleList([
            IdentityBank(embed_dim) for _ in range(max_characters)
        ])
        self.character_separator = nn.Parameter(torch.randn(1, embed_dim))

    def encode_multiple(self, character_references):
        all_tokens = []
        for idx, refs in enumerate(character_references):
            char_tokens = self.banks[idx].encode(refs)
            # Add separator to prevent conflation
            char_tokens = torch.cat([char_tokens, self.character_separator])
            all_tokens.append(char_tokens)
        return torch.cat(all_tokens, dim=0)
I token separatori agiscono come assicurazioni tra gli arrampicatori, mantenendo identità distinte anche quando operano a stretto contatto.
Implicazioni pratiche per i creator
Per chi utilizza questi strumenti anziché svilupparli, sono emersi diversi schemi pratici:
Qualità dell'immagine di riferimento
Immagini di riferimento ad alta risoluzione, ben illuminate e con espressioni neutre producono risultati più coerenti. Il modello apprende l'identità da questi ancoraggi e il rumore si propaga.
Riferimenti multipli
Fornire 3-5 immagini di riferimento da angolazioni diverse aiuta il modello a costruire una rappresentazione dell'identità più completa. È come triangolare una posizione da più punti.
Prompt che descrivono l'identità
Descrizioni esplicite dell'identità nei prompt rafforzano la coerenza visiva. "Una donna di 30 anni con capelli castani corti e occhi verdi" fornisce vincoli aggiuntivi che il modello può sfruttare.
Come impostare un'inquadratura, passo dopo passo
- Passo 1: scegli un fotogramma di riferimento in cui il volto sia illuminato uniformemente e l'espressione sia neutra, quindi mantienilo come ancoraggio per ogni inquadratura della sequenza.
- Passo 2: aggiungi da due a quattro riferimenti da altre angolazioni, affinché l'embedding di identità venga triangolato anziché estrapolato da una singola vista.
- Passo 3: descrivi l'identità nel prompt usando sempre le stesse parole, perché una descrizione che cambia tra le inquadrature reintroduce la varianza eliminata dai riferimenti.
- Passo 4: genera un breve test prima della sequenza completa e confronta il primo e l'ultimo fotogramma, perché la deriva si accumula ed è meno costoso rilevarla a dieci secondi piuttosto che a novanta.
La strada da percorrere
Ci stiamo avvicinando a una soglia in cui i video generati dall'AI possono mantenere una coerenza dei personaggi sufficiente per la narrazione. Le sfide rimanenti, tra cui la coerenza delle espressioni sottili, la generazione in formato lungo oltre 60 secondi e l'interazione tra più personaggi, vengono affrontate attivamente.
In Bonega.ai, siamo particolarmente interessati a come questi miglioramenti della coerenza si integrino con le capacità di estensione video. La possibilità di estendere filmati esistenti mantenendo una perfetta coerenza dei personaggi apre possibilità creative che semplicemente non erano realizzabili 12 mesi fa.
L'eleganza matematica di trattare l'identità come una questione architetturale di primo livello, anziché come una correzione a posteriori, segna una maturazione nel modo in cui pensiamo alla generazione video. Come stabilire un campo alto ben attrezzato prima della spinta verso la vetta, questi miglioramenti fondamentali permettono i percorsi creativi più lunghi e ambiziosi che ci attendono.
La coerenza dei personaggi non è soltanto una metrica tecnica. È la base della narrazione visiva. E nel 2025, quella base è finalmente diventata abbastanza solida da poterci costruire sopra.
Cosa usare, e quando
Un embedding di identità è un vettore compatto che codifica a chi appartiene un volto piuttosto che il suo aspetto in un singolo fotogramma, e scegliere uno strumento significa scegliere come gestisce quel vettore.
- Inquadrature narrative brevi con un personaggio ricorrente: un modello basato su fotogrammi di riferimento è la scelta giusta. È l'approccio che mantiene l'identità con maggiore affidabilità sotto i dieci secondi, e il fotogramma di ancoraggio ti offre qualcosa di concreto su cui iterare quando una ripresa non funziona.
- Sequenze più lunghe di un minuto: aspettati deriva indipendentemente dal modello e pianifica i tagli. Generare segmenti più brevi e unirli richiede meno tempo che combattere un singolo rendering lungo che degrada nel suo ultimo terzo.
- Due o più personaggi nell'inquadratura: considera la perdita di identità come il risultato predefinito e testala presto, perché il fallimento non è graduale. Separa i personaggi tra le inquadrature ovunque il montaggio lo consenta.
- Somiglianza fotorealistica di una persona reale: nessuno di questi metodi è abbastanza affidabile da poterlo promettere a un cliente, e l'esposizione legale è un problema separato da quello tecnico.
La sintesi onesta è che l'identità è ora risolta abbastanza bene per la narrazione, ma non ancora abbastanza bene per una produzione non supervisionata. Se la tua sequenza è breve, con un solo personaggio, e puoi rivedere ogni inquadratura, questi modelli terranno. Se una qualsiasi di queste tre condizioni non è vera, prevedi dei rifacimenti.