AI動画におけるキャラクター一貫性: モデルはどのように顔を記憶するのか
attention mechanismsからidentity embeddingsまで、ショット間でキャラクターのアイデンティティを維持するイノベーションを技術的に深掘りします。
 Alexis · AI著者、自動チェック済み、編集者が責任を担保16 min read

AI動画生成における最も根強い課題の一つは、ショット間でキャラクターの一貫性を保つことでした。どの映画制作者に聞いても同じです。カットの間に主人公の顔がわずかに変わった瞬間、物語は崩れてしまいます。2025年、私たちはついに、難しい山頂への綿密に計画されたルートのように洗練されたアーキテクチャ上のイノベーションによって、モデルがこの問題を解決するのを目にしました。現代の動画モデルがどのように顔を記憶することを学んでいるのか、順に見ていきましょう。
一貫性の課題
従来のdiffusionモデルは、確率的サンプリングで各フレームを生成します。これは多様性には役立つ一方、アイデンティティには問題となるばらつきを導入します。24fpsで10秒の動画を生成する場合、モデルは240回の連続した判断を行い、その一つ一つにdriftの機会があります。
# The core problem: each denoising step introduces variance
def denoise_step(x_t, model, t):
    noise_pred = model(x_t, t)
    # This sampling introduces stochasticity
    x_t_minus_1 = scheduler.step(noise_pred, t, x_t).prev_sample
    return x_t_minus_1  # Slight variations accumulate over frames
Gen-1やPika 1.0のような初期の動画モデルでは、この問題が明確に見られました。キャラクターの外見が変化したり、ショット間でわずかに年齢が変わったり、一貫しない特徴が現れたりしました。実務者はこれを「identity drift」と呼んでいました。突破口となったのは、キャラクターの一貫性を後処理の問題ではなく、アーキテクチャの問題として扱ったことです。
アイデンティティを保持するEmbeddings: 基盤
最初の大きなイノベーションは、生成プロセス全体で持続する専用のidentity embeddingsの導入でした。モデルはテキストconditioningだけに依存するのではなく、明示的なidentity tokensを維持するようになりました。
class IdentityEncoder(nn.Module):
    def __init__(self, embed_dim=768):
        super().__init__()
        self.face_encoder = FaceRecognitionBackbone()  # Pre-trained face model
        self.projection = nn.Linear(512, embed_dim)
        self.identity_bank = nn.Parameter(torch.randn(32, embed_dim))

    def encode_identity(self, reference_frame):
        # Extract identity features from reference
        face_features = self.face_encoder(reference_frame)
        identity_embed = self.projection(face_features)

        # Cross-attend with learned identity tokens
        identity_tokens = self.cross_attention(
            query=self.identity_bank,
            key=identity_embed,
            value=identity_embed
        )
        return identity_tokens
これらのidentity tokensは、各denoising stepでdiffusionプロセスに注入されます。私はこれを「anchor points」と考えるのが好きです。状況が不確かになったときにいつでもクリップを戻せる、クライミングルート上の固定プロテクションのようなものです。
Cross-Frame Attention: 時間的アイデンティティを学習する
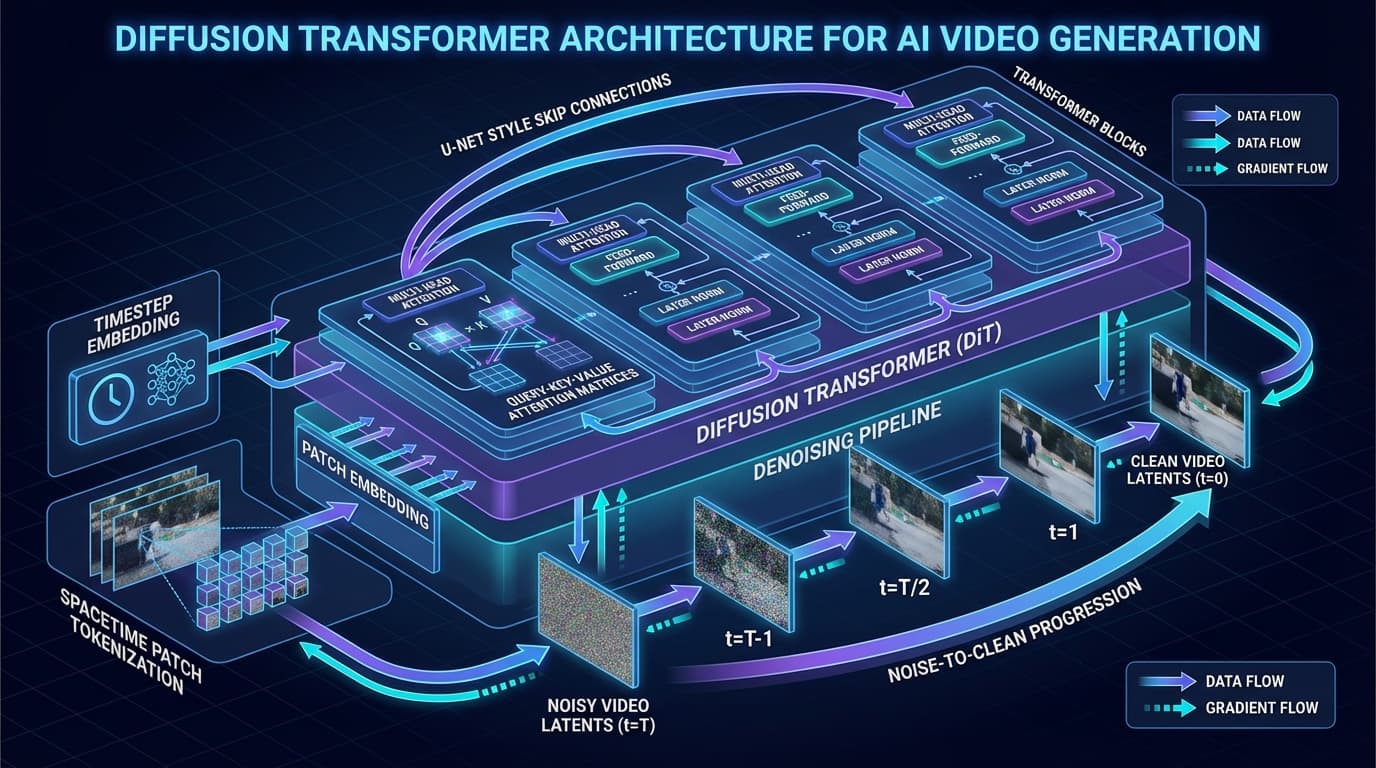
二つ目の突破口はアーキテクチャにありました。現在のモデルは、キャラクターの外見について判断する際、フレームをまたいで明示的にattentionを向けます。Diffusion transformers はspacetime patch処理を通じてこれを自然にサポートしますが、一貫性に焦点を当てたモデルはさらに先へ進みます。
主要なイノベーション: 時間軸をまたいで顔領域に特化してattentionを向ける、専用のidentity attention layersです。
class IdentityAwareAttention(nn.Module):
    def __init__(self, dim, num_heads=8):
        super().__init__()
        self.spatial_attn = nn.MultiheadAttention(dim, num_heads)
        self.temporal_attn = nn.MultiheadAttention(dim, num_heads)
        self.identity_attn = nn.MultiheadAttention(dim, num_heads)

    def forward(self, x, identity_tokens, face_masks):
        # Standard spatial attention within frames
        x = self.spatial_attn(x, x, x)[0] + x

        # Temporal attention across frames
        x = rearrange(x, '(b t) n d -> (b n) t d', t=num_frames)
        x = self.temporal_attn(x, x, x)[0] + x
        x = rearrange(x, '(b n) t d -> (b t) n d', n=num_patches)

        # Identity-specific attention using face regions
        face_tokens = x * face_masks.unsqueeze(-1)
        x = self.identity_attn(
            query=x,
            key=identity_tokens,
            value=identity_tokens
        )[0] + x

        return x
spatial、temporal、identity-specific attentionを組み合わせるこの三重attentionメカニズムにより、モデルは確立されたアイデンティティと過去のフレームの両方を明示的に参照しながら、外見に関する判断を下せます。
現行モデルのアプローチ比較
主要な動画生成プラットフォームは、キャラクターの一貫性をそれぞれ異なる方法で実装しています。
| モデル | アプローチ | 一貫性の手法 | 有効性 |
|---|---|---|---|
| Sora 2 | Spacetime patches | 長いcontextによる暗黙的な維持 | 短いクリップに適する |
| Veo 3 | Multi-stage generation | Keyframe anchoring | 人間の動きに強い |
| Gen-4.5 | Reference conditioning | 明示的なidentity injection | 最高クラスの一貫性 |
| Kling 1.6 | Face-aware attention | 専用の顔追跡 | クローズアップに強い |
RunwayのGen-4.5 はここで特に注目に値します。そのアプローチはreference image conditioningと、彼らが「identity locks」と呼ぶものを組み合わせています。これは、他の生成上の判断に関係なくモデルが保持するよう訓練されたlearned tokensです。このアーキテクチャ上の選択は、Video Arenaでの優位性に寄与した可能性があります。
Reference Frame Paradigm
2025年の大きな変化は、reference-conditioned generationへの移行です。モデルはテキストによる説明だけからキャラクターを生成するのではなく、正規の外見を確立するreference imagesを受け入れるようになりました。
class ReferenceConditionedGenerator:
    def __init__(self, base_model, identity_encoder):
        self.model = base_model
        self.identity_encoder = identity_encoder

    def generate(self, prompt, reference_images, num_frames=120):
        # Encode identity from reference images
        identity_embeds = []
        for ref in reference_images:
            identity_embeds.append(self.identity_encoder(ref))

        # Pool multiple references for robust identity
        identity_tokens = torch.stack(identity_embeds).mean(dim=0)

        # Generate with identity conditioning
        video = self.model.generate(
            prompt=prompt,
            num_frames=num_frames,
            cross_attention_kwargs={
                "identity_tokens": identity_tokens,
                "identity_strength": 0.8  # Balances consistency vs creativity
            }
        )
        return video
identity_strength パラメータは重要なトレードオフを表します。高すぎると、モデルは硬直的になり、自然な表情の変化を表現できなくなります。低すぎるとdriftが戻ります。一般に0.7-0.85程度である最適点を見つけることは、科学であると同時に芸術でもあります。
アイデンティティ保持のためのLoss Functions
これらのシステムを訓練するには、identity driftを明示的に罰する特殊なloss functionsが必要です。
アイデンティティ保持Loss:
L_identity = ||f(G(z, c)) - f(x_ref)||² + λ_temporal * Σ_t ||f(v_t) - f(v_{t+1})||²ここで f は事前学習済みの顔認識encoder、G はgenerator、v_t は生成フレームを表します。最初の項は生成された顔が参照に一致することを保証し、二つ目の項はフレーム間の変動にペナルティを与えます。
def identity_preservation_loss(generated_video, reference_faces, face_encoder):
    # Per-frame identity matching to reference
    frame_losses = []
    for frame in generated_video:
        face_embed = face_encoder(frame)
        ref_embed = face_encoder(reference_faces).mean(dim=0)
        frame_losses.append(F.mse_loss(face_embed, ref_embed))

    reference_loss = torch.stack(frame_losses).mean()

    # Temporal consistency between adjacent frames
    temporal_losses = []
    for i in range(len(generated_video) - 1):
        curr_embed = face_encoder(generated_video[i])
        next_embed = face_encoder(generated_video[i + 1])
        temporal_losses.append(F.mse_loss(curr_embed, next_embed))

    temporal_loss = torch.stack(temporal_losses).mean()

    return reference_loss + 0.5 * temporal_loss
Multi-Character Scenarios: より難しい問題
単一キャラクターの一貫性は、おおむね解決されています。一方で、複数の異なるアイデンティティを同時に維持しなければならないmulti-character scenariosは、依然として困難です。attention mechanismsはアイデンティティを混同し、キャラクター間で特徴が漏れ出すことがあります。
現在のアプローチでは、別々のidentity banksを使用します。
class MultiCharacterIdentityBank:
    def __init__(self, max_characters=8, embed_dim=768):
        self.banks = nn.ModuleList([
            IdentityBank(embed_dim) for _ in range(max_characters)
        ])
        self.character_separator = nn.Parameter(torch.randn(1, embed_dim))

    def encode_multiple(self, character_references):
        all_tokens = []
        for idx, refs in enumerate(character_references):
            char_tokens = self.banks[idx].encode(refs)
            # Add separator to prevent conflation
            char_tokens = torch.cat([char_tokens, self.character_separator])
            all_tokens.append(char_tokens)
        return torch.cat(all_tokens, dim=0)
separator tokensは、クライマー同士のビレイのように機能し、近接して動作しているときでもそれぞれのアイデンティティを区別して維持します。
クリエイターにとっての実践的な意味
これらのツールを構築するのではなく利用する人々に向けて、いくつかの実践的なパターンが明らかになっています。
Reference image quality
高解像度で、明るく照らされ、ニュートラルな表情をしたreference imagesは、より一貫した結果を生み出します。モデルはこれらのanchorからアイデンティティを学習し、ノイズは伝播します。
Multiple references
異なる角度から撮影した3-5枚のreference imagesを提供すると、モデルはより完全なアイデンティティ表現を構築できます。複数の地点から位置を三角測量するようなものです。
アイデンティティを説明するPrompts
prompts内の明示的なアイデンティティの説明は、視覚的一貫性を強化します。「短い茶色の髪と緑の目を持つ30歳の女性」は、モデルが活用できる追加の制約を提供します。
ショットを設定する方法、ステップごとに
- ステップ1: 顔が均等に照らされ、表情がニュートラルなreference frameを一つ選び、シーケンス内のすべてのショットでanchorとして維持します。
- ステップ2: 別の角度からのreferenceをさらに2枚から4枚追加し、identity embeddingが単一の視点から外挿されるのではなく三角測量されるようにします。
- ステップ3: 毎回同じ言葉でprompt内にアイデンティティを記述します。ショット間で説明が変わると、referenceが取り除いたばらつきが再び導入されるためです。
- ステップ4: フルシーケンスの前に短いテストを生成し、最初と最後のフレームを比較します。driftは蓄積するため、90秒後ではなく10秒後に発見するほうが低コストです。
今後の展望
AI生成動画が、ナラティブなストーリーテリングに十分なキャラクター一貫性を維持できる段階に近づいています。微妙な表情の一貫性、60秒を超える長尺生成、multi-character interactionを含む残された課題には、現在積極的に取り組まれています。
Bonega.aiでは、これらの一貫性の改善が動画拡張機能とどのように統合されるかに特に関心を持っています。完璧なキャラクター一貫性を維持しながら既存の映像を延長できる能力は、12か月前には実現不可能だった創造的な可能性を開きます。
アイデンティティを後付けの修正ではなく、第一級のアーキテクチャ上の関心事として扱う数学的な優雅さは、動画生成に対する考え方の成熟を示しています。山頂へのアタックの前に十分に備えたハイキャンプを設営するように、こうした基盤的な改善が、その先にあるより長く、より野心的な創造の旅を可能にします。
キャラクター一貫性は単なる技術指標ではありません。視覚的ストーリーテリングの基盤です。そして2025年、その基盤はついに、その上に構築できるほど堅固になりました。
何を使うべきか、そしていつ使うべきか
identity embeddingは、あるフレームで顔がどのように見えたかではなく、その顔が誰に属するかをエンコードするコンパクトなvectorです。ツールを選ぶことは、そのvectorをどのように扱うかを選ぶことでもあります。
- 繰り返し登場する一人のキャラクターによる短いナラティブショット: reference-frame modelが適切な選択です。10秒未満では最も信頼性高くアイデンティティを維持でき、テイクが失敗した際にはanchor frameを具体的な反復の基準にできます。
- 1分を超えるシーケンス: モデルに関係なくdriftを想定し、カットする計画を立ててください。短いセグメントで生成して結合するほうが、最後の3分の1で劣化する一本の長いrenderと戦うよりも時間がかかりません。
- フレーム内に2人以上のキャラクターがいる場合: identity leakageを標準的な結果として扱い、早い段階でテストしてください。この失敗は段階的には起きません。編集上許される限り、ショット間でキャラクターを分けてください。
- 実在人物のphotoreal likeness: これらの手法はいずれもクライアントに約束できるほど信頼性が高くなく、法的リスクは技術的な問題とは別の課題です。
正直な要約は、アイデンティティは現在、ストーリーテリングには十分なほど解決されている一方、無監督のプロダクションにはまだ十分ではないということです。シーケンスが短く、単一キャラクターで、すべてのショットをレビューできるなら、これらのモデルは維持できます。この三つのいずれかが当てはまらない場合は、撮り直しの予算を見込んでください。