ローカル環境でAI動画を生成:2026年におけるLTX-2、RTX、ComfyUIの活用法
ComfyUIでLTX-2をローカル実行:最小要件RTX 4060(8 GB)、推奨24 GB VRAM、ステップバイステップのセットアップ手順、クラウドツールとのコスト比較。
 Damien17 min read
AI著者、自動チェック済み、編集者が責任を担保
LightricksがNVIDIAと共同開発したオープンソースモデルLTX-2は、コンシューマー向けGPU単体で最大20秒、4K解像度、50 FPSの動画を生成できるようになりました。クラウドも、サブスクリプションも、マシン外へのデータ送信も一切不要です。
CES 2026において、NVIDIAは新型RTX 50シリーズ上でLTX-2をネイティブ動作させるデモを披露し、来場者を圧倒しました。これは単なる研究段階のデモではありません。クラウドサービスに匹敵する速度で動作する、プロダクションレディなローカル動画生成でした。
これが何を意味するのか、何が必要なのか、そしてどのようにセットアップするのかを詳しく解説します。
ローカルAI動画生成が重要である理由
技術的なセットアップに入る前に、なぜローカルでのAI動画生成が単なる趣味の領域にとどまらないのかを説明します。これは現実の課題を直接解決するものです。
月額サブスクリプション($20-100/月)、サードパーティサーバーへのデータアップロード、インターネット依存、ピーク時の生成待ちキュー、限られたカスタマイズ性
1回限りのハードウェア投資、完全なデータプライバシー、オフライン動作、待ちキューなし、LoRA学習による完全なモデルカスタマイズ、無制限の生成
クライアントの映像素材を扱う制作スタジオにとって、プライバシーの保護は必須要件です。インターネット回線が遅い地域のクリエイターにとって、クラウド生成は実用的ではありません。そして月に何百本ものクリップを生成する人にとっては、サブスクリプションの計算はすぐに採算が合わなくなります。
必要な環境:ハードウェア要件
客観的な要件の内訳は以下の通りです。ローカル生成には十分な性能のハードウェアが必要ですが、おそらく想像しているほど極端なものではありません。
| コンポーネント | 最小要件 | 推奨要件 | 最適要件 |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| ストレージ | 空き容量50 GB以上のSSD | 200 GB NVMe | 500 GB NVMe |
| OS | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
GPUパフォーマンス比較
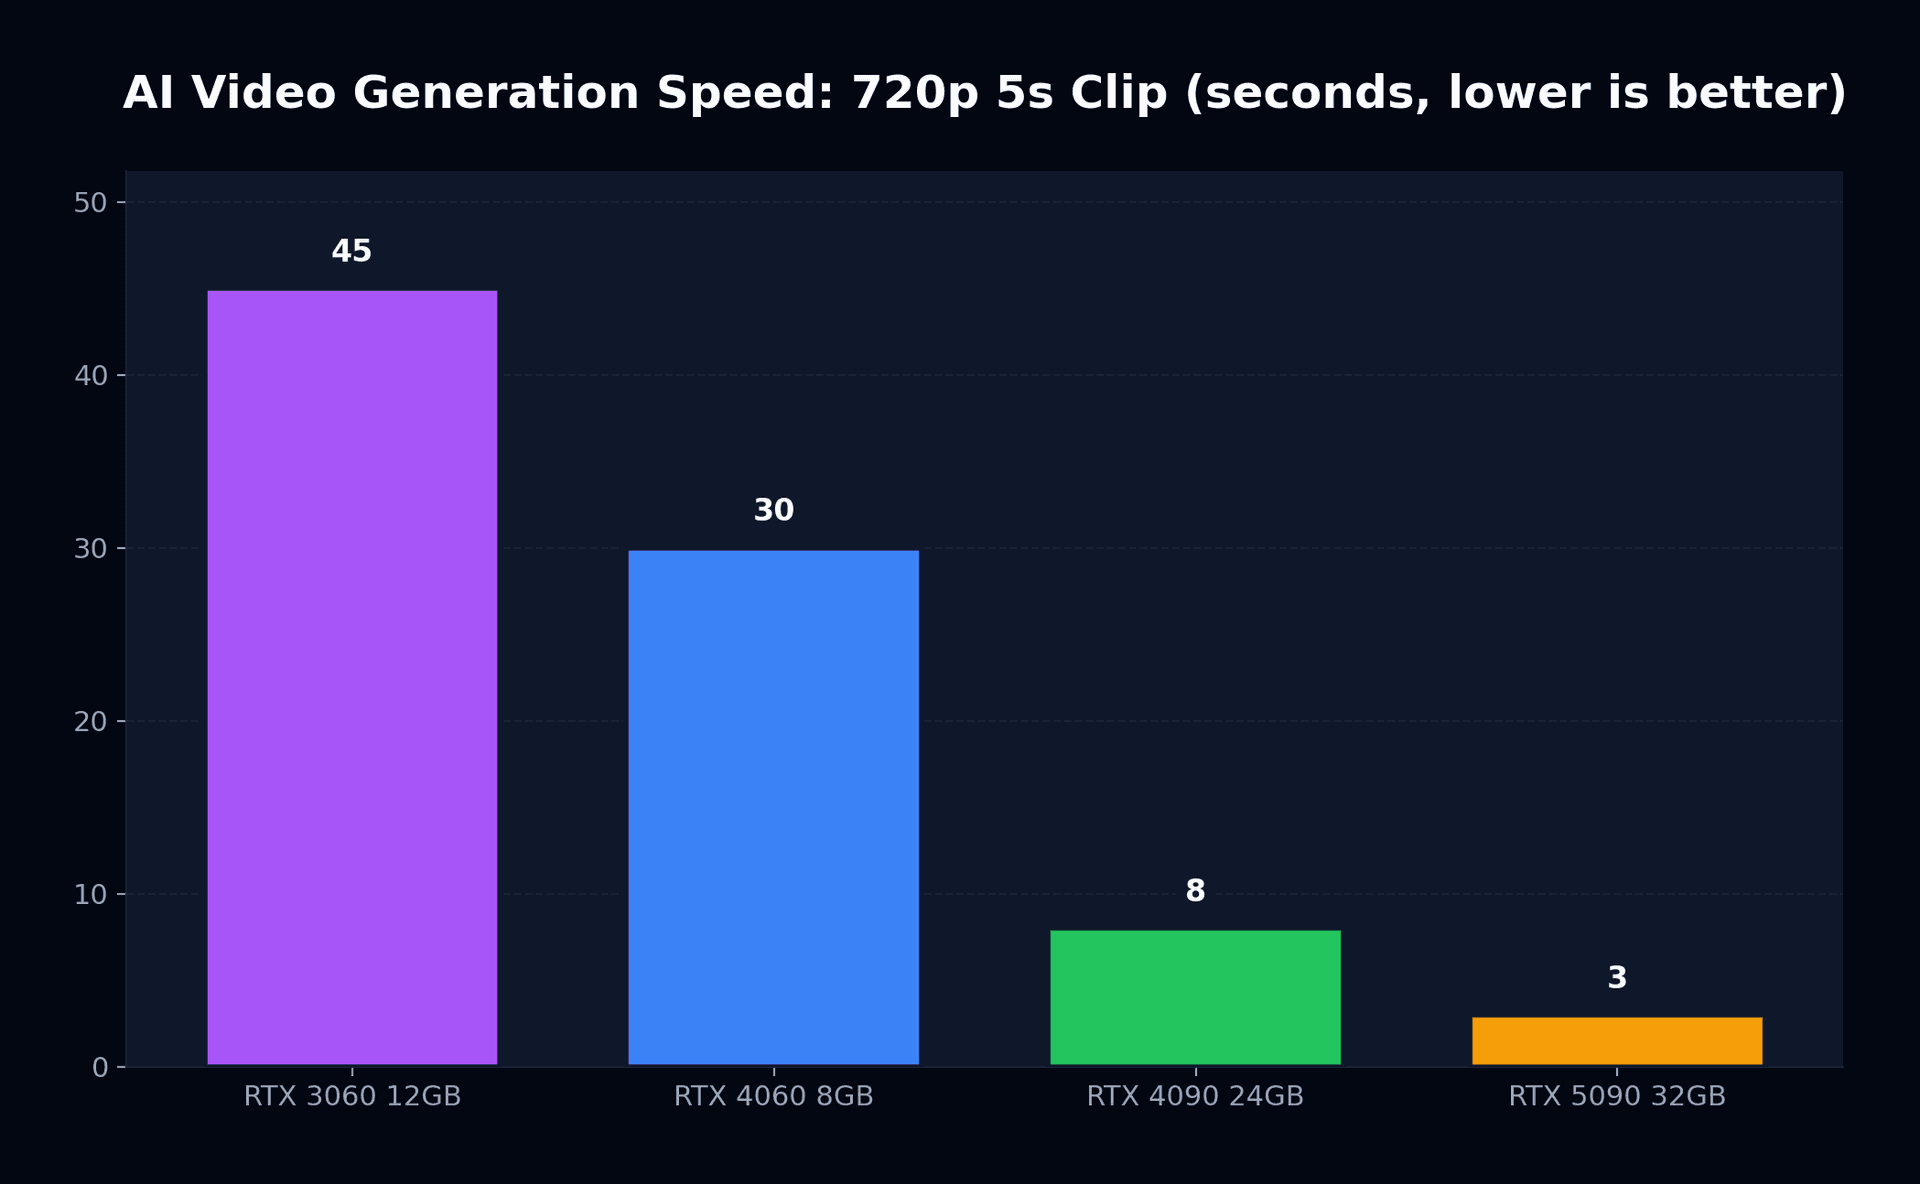
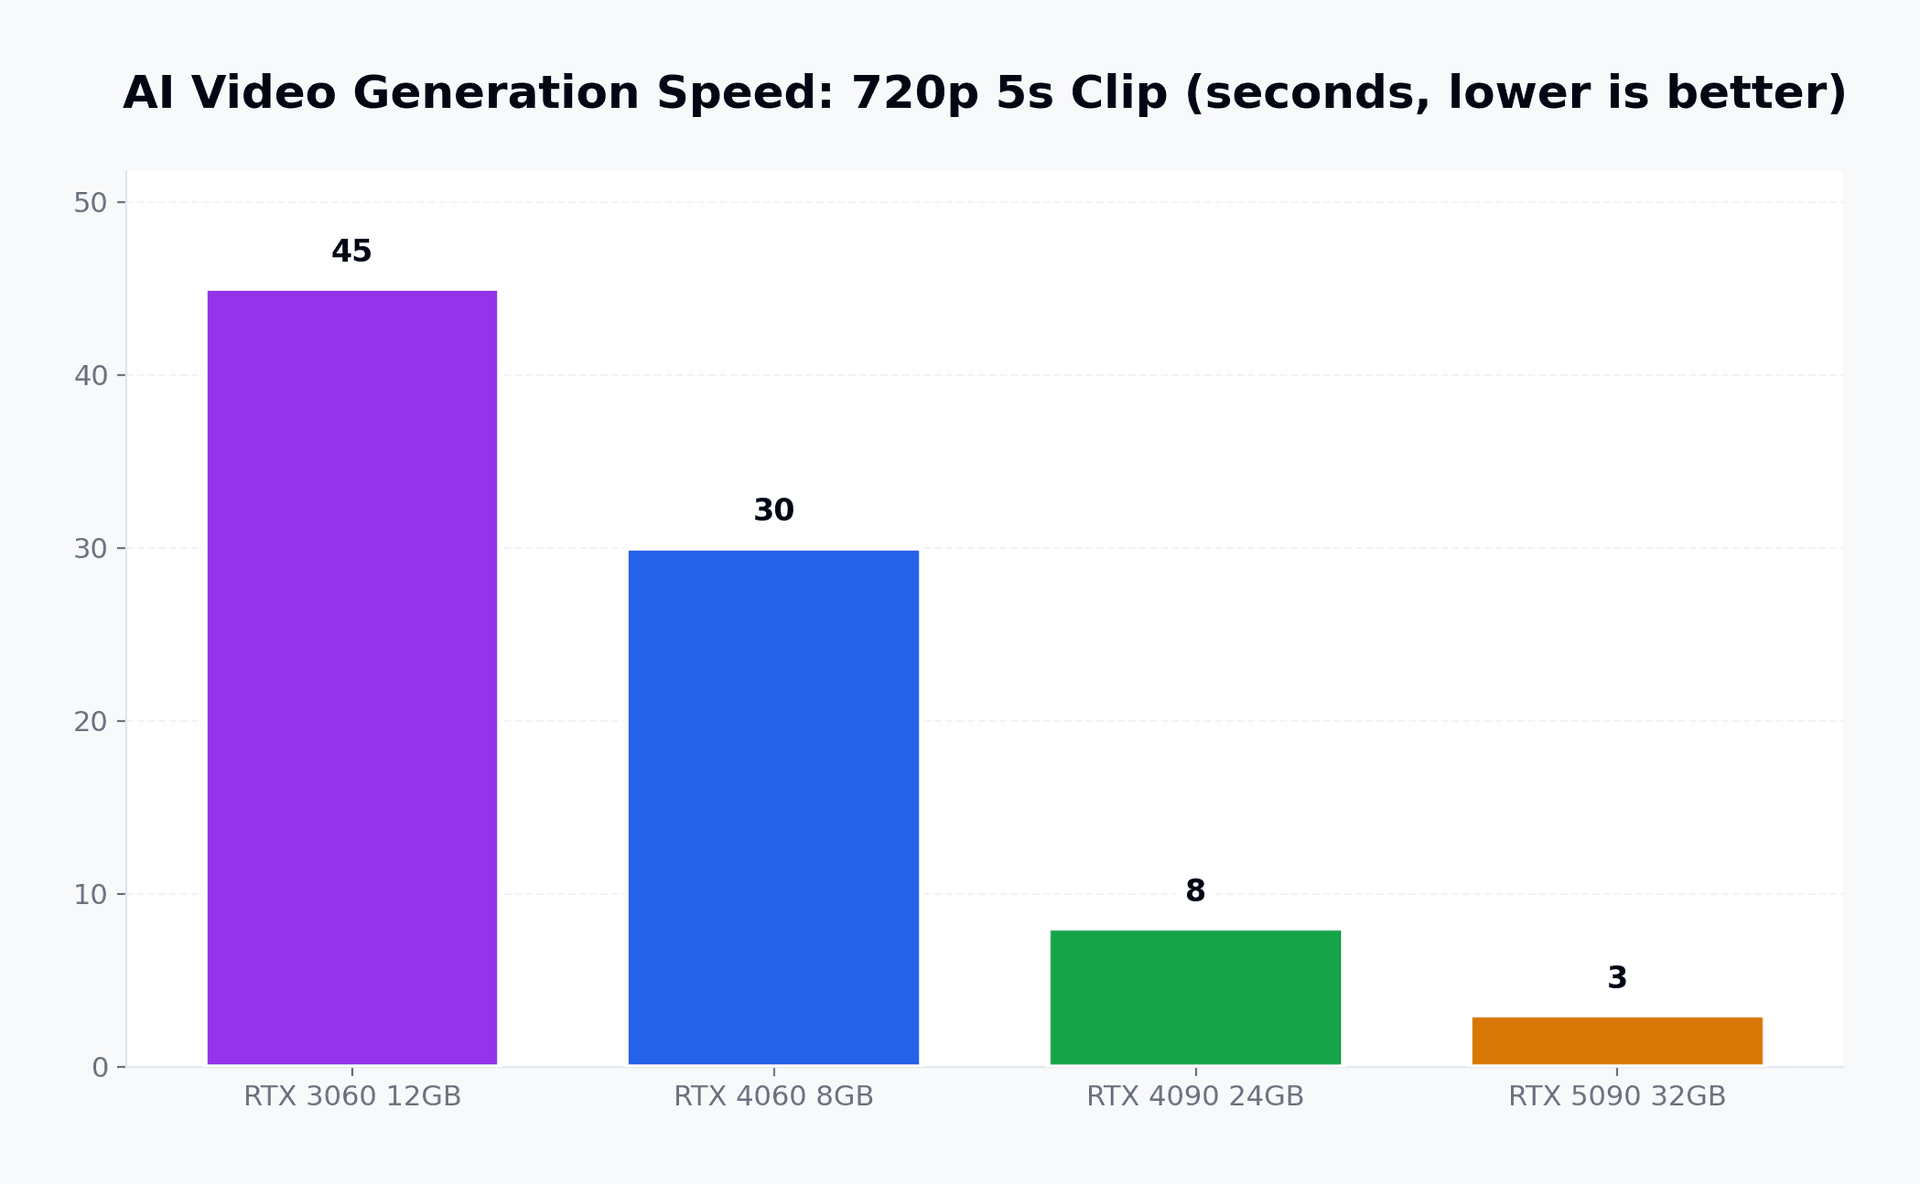
世代間の性能差は劇的です。以下はNVIDIAがCES 2026で公開した実測値です。
| GPU | 720p(5秒クリップ) | 1080p(5秒クリップ) | 4K(5秒クリップ) | VRAM使用量 |
|---|---|---|---|---|
| RTX 3060 12 GB | 約45秒 | 約90秒 | 非対応 | 11 GB |
| RTX 4060 8 GB | 約30秒 | 約60秒 | 非対応 | 7.5 GB |
| RTX 4090 24 GB | 約8秒 | 約15秒 | 約45秒 | 18 GB |
| RTX 5090 32 GB | 約3秒 | 約6秒 | 約15秒 | 20 GB |
RTX 50シリーズは、ネイティブのNVFP4量子化によって3倍の高速化を達成し、視覚的な品質を損なうことなくモデルの重み精度を半減させています。これはLLMをコンシューマー向けハードウェアで実用化させた手法と同じであり、今回動画拡散モデルにも適用されました。
LTX-2:何が特別なのか
LTX-2は単なる「もうひとつのオープンソースモデル」ではありません。コンシューマー向けハードウェアで何が可能かという基準を根本から覆す存在です。
最大20秒、4K 50 FPS
オーディオ生成機能内蔵
マルチキーフレーム制御
LoRAによるカスタマイズ
ComfyUI対応
クラウドサービスとの比較
主要なクラウドプラットフォームと比較して、ローカル生成で何ができて何ができないのかを具体的に整理します。
| 機能 | LTX-2(ローカル) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| 最大解像度 | 4K | 1080p | 4K | 1080p |
| 最大時間 | 20秒 | 20秒 | 8秒 | 10秒 |
| オーディオ | 内蔵 | 別途 | ネイティブ | 別途 |
| プライバシー | 完全 | クラウド | クラウド | クラウド |
| 月額コスト | $0 | $20-200 | $20-50 | $15-100 |
| カスタマイズ性 | 完全(LoRA) | 限定的 | 限定的 | 中程度 |
| 生成速度(1080p、5秒) | 6-60秒(GPU依存) | 30-120秒 | 15-60秒 | 20-90秒 |
トレードオフは明確です。クラウドサービスは最小限の準備でより洗練された出力を提供する一方、ローカル生成は完全なコントロール、プライバシー、そして生成ごとの限界費用ゼロという利点を提供します。これらクラウドプラットフォームの詳細な比較については、Sora 2 vs Runway vs Veo 3の比較記事をご覧ください。
ComfyUIでLTX-2をセットアップする:ステップバイステップ
実際の手順を解説します。ここでは、8 GB以上のVRAMを搭載したNVIDIA GPUと最新のドライバーがインストールされていることを前提とします。
ステップ1:ComfyUIのインストール
ComfyUIは、拡散モデル向けのノードベースのビジュアルインターフェースです。Unreal EngineのブループリントシステムのAI生成ワークフロー版と考えるとイメージしやすいでしょう。
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
ステップ2:LTX-2モデルのダウンロード
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
ステップ3:LTX-2 ComfyUI拡張機能のインストール
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
ステップ4:起動と生成
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
ブラウザで http://127.0.0.1:8188 を開きます。拡張機能のサンプルフォルダからLTX-2のワークフローを読み込み、プロンプトを入力して「Queue Prompt」をクリックします。
セットアップの最適化
基本的な動作を確認した後は、大きな差を生むチューニングのテクニックを紹介します。
VRAM管理
ローカル生成における最大のボトルネックはVRAMです。手元のリソースを最大限に活用する方法は以下の通りです。
- ✓モデルオフローディングを有効にする(未使用のレイヤーをシステムRAMへ退避)
- ✓使用しているGPU世代に合わせたNVFP8/NVFP4量子化の活用
- ✓ブラウザのタブや他のGPU消費アプリケーションを終了する
- ✓Windowsのディスプレイ設定で「ハードウェア アクセラレータによる GPU スケジューリング」を有効化する
- ✓Linuxとのデュアルブートを検討する(Windowsと比較してGPU使用効率が5-10%向上)
バッチ処理ワークフロー
多数のクリップを生成する必要があるクリエイター向けに、ComfyUIはバッチキューイングをサポートしています。JSONファイルでプロンプトを設定し、バッチローダーノードに接続すれば、夜間にGPUを自動で稼働させることができます。
カスタムスタイルのためのLoRA学習
これこそがローカル生成の真価を発揮する部分です。RTX 4090を使用すれば、50-100フレームの参照映像から約30分でLoRAアダプターを学習できます。出力される軽量なファイル(通常100-300 MB)により、特定のビジュアルスタイル、キャラクターの外見、環境の雰囲気をモデルに反映させることが可能です。
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
コスト試算
具体的な数値で計算してみましょう。毎月100本の5秒クリップを生成するフリーランスの映像クリエイターを想定します。
| 手法 | 月額コスト | 年間コスト | プライバシー |
|---|---|---|---|
| Sora 2 Pro | $100/月 | $1,200/年 | クラウド |
| Runway Standard | $76/月 | $912/年 | クラウド |
| Veo (Google AI Pro) | $50/月 | $600/年 | クラウド |
| LTX-2 + RTX 4090 | 約$15/月(電気代) | 約$180/年 | 完全 |
RTX 4090の希望小売価格(MSRP)は約$1,600ですが、生産終了の影響で現在の実売価格は$2,500-2,800前後で推移しています。クラウドサービスを利用しながら月に100本のクリップを制作する場合、実売価格であってもGPUへの投資は18-24ヶ月で回収でき、それ以降は電気代のみで生成を続けられます。
今後の展望
ローカルAI動画生成の進化スピードは加速しています。注目すべき3つの動向は以下の通りです。
LTX-2.1リリース
NVIDIA Rubinプラットフォーム
Meta Mango(オープンソース化の可能性)
結論
クラウドAI動画サービスは優れたプロダクトです。Sora、Veo、Runwayはいずれも最小限のセットアップで印象的な結果を提供します。しかし、それらは多くのクリエイターが受け入れがたいと感じ始めているトレードオフ(継続的な費用、プライバシーの懸念、インターネット回線への依存、限られたカスタマイズ性)を伴います。
NVIDIA RTX GPU上でComfyUIとLTX-2を運用することは、単なる妥協ではありません。まったく異なるパラダイムです。モデルの重みから最終的な出力に至るまで、パイプライン全体を自分自身で所有できます。セットアップには半日ほどかかり、一定の学習コストは存在しますが十分に対応可能です。そして特に最新の最適化を施した4K解像度での出力結果は、クラウドの競合サービスと真の意味で渡り合えるレベルに達しています。
ゲームの合間に眠っているRTX GPUがあるなら、動画生成という新しい役割を与えてみてください。その実力にきっと驚くはずです。
関連記事: オープンソースAI動画の最新動向については、オープンソースAI動画革命およびLTX-2ネイティブ4K生成の解説をご覧ください。業界全体の動向に関心がある場合は、AI動画の$10革命:低価格ツールはいかにして巨人に挑んでいるかもあわせてご覧ください。