로컬에서 AI 비디오 실행하기: 2026년 LTX-2, RTX, ComfyUI 가이드
ComfyUI를 활용해 로컬에서 LTX-2를 실행해 보세요. RTX 4060 (8 GB) 최소 사양, 24 GB VRAM 권장 사양, 단계별 설정 방법 및 클라우드 도구와의 비용 비교를 정리했습니다.
 Damien19 min read
AI 작성, 자동 검수, 편집자 책임
Lightricks가 NVIDIA와 협력하여 개발한 오픈소스 모델 LTX-2는 이제 단일 소비자용 GPU에서 최대 50 FPS의 4K 비디오 20초를 생성합니다. 클라우드도, 구독도 필요 없으며, 여러분의 컴퓨터 밖으로 데이터가 유출되지도 않습니다.
CES 2026에서 NVIDIA는 새로운 RTX 50 시리즈에서 네이티브로 실행되는 LTX-2를 시연했으며, 그 결과는 관객들을 놀라게 했습니다. 이는 단순한 연구용 데모가 아니었습니다. 클라우드 서비스에 필적하는 속도로 구동되는, 프로덕션 환경에 바로 투입 가능한 로컬 비디오 생성이었습니다.
이것이 무엇을 의미하는지, 무엇이 필요한지, 그리고 어떻게 설정하는지 단계별로 안내해 드리겠습니다.
로컬 AI 비디오 생성이 중요한 이유
기술적인 설정에 들어가기 전에, AI 비디오를 로컬에서 실행하는 것이 왜 단순한 애호가의 취향 이상인지 설명해 드리겠습니다. 이는 실제적인 문제들을 해결해 줍니다.
월간 구독료($20-100/월), 타사 서버로 데이터 업로드, 인터넷 의존성, 사용량이 몰리는 시간대의 생성 대기열, 제한된 커스터마이징 옵션
일회성 하드웨어 투자, 완벽한 데이터 프라이버시, 오프라인 작동, 대기 시간 없음, LoRA 학습을 통한 완전한 모델 커스터마이징, 무제한 생성
고객의 영상 클립을 다루는 스튜디오에게 프라이버시는 타협할 수 없는 문제입니다. 인터넷 속도가 느린 지역의 크리에이터에게 클라우드 생성은 실용적이지 않습니다. 그리고 매달 수백 개의 클립을 생성하는 사람이라면 누구나 구독 비용 계산서 앞에서 고민하게 됩니다.
준비 사항: 하드웨어 요구 사양
솔직한 사양 분석을 공개합니다. 로컬 생성에는 준수한 하드웨어가 필요하지만, 생각만큼 터무니없이 극단적인 사양이 필요한 것은 아닙니다.
| 부품 | 최소 사양 | 권장 사양 | 최적 사양 |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| 스토리지 | 50 GB 여유 SSD | 200 GB NVMe | 500 GB NVMe |
| OS | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
GPU 성능 비교
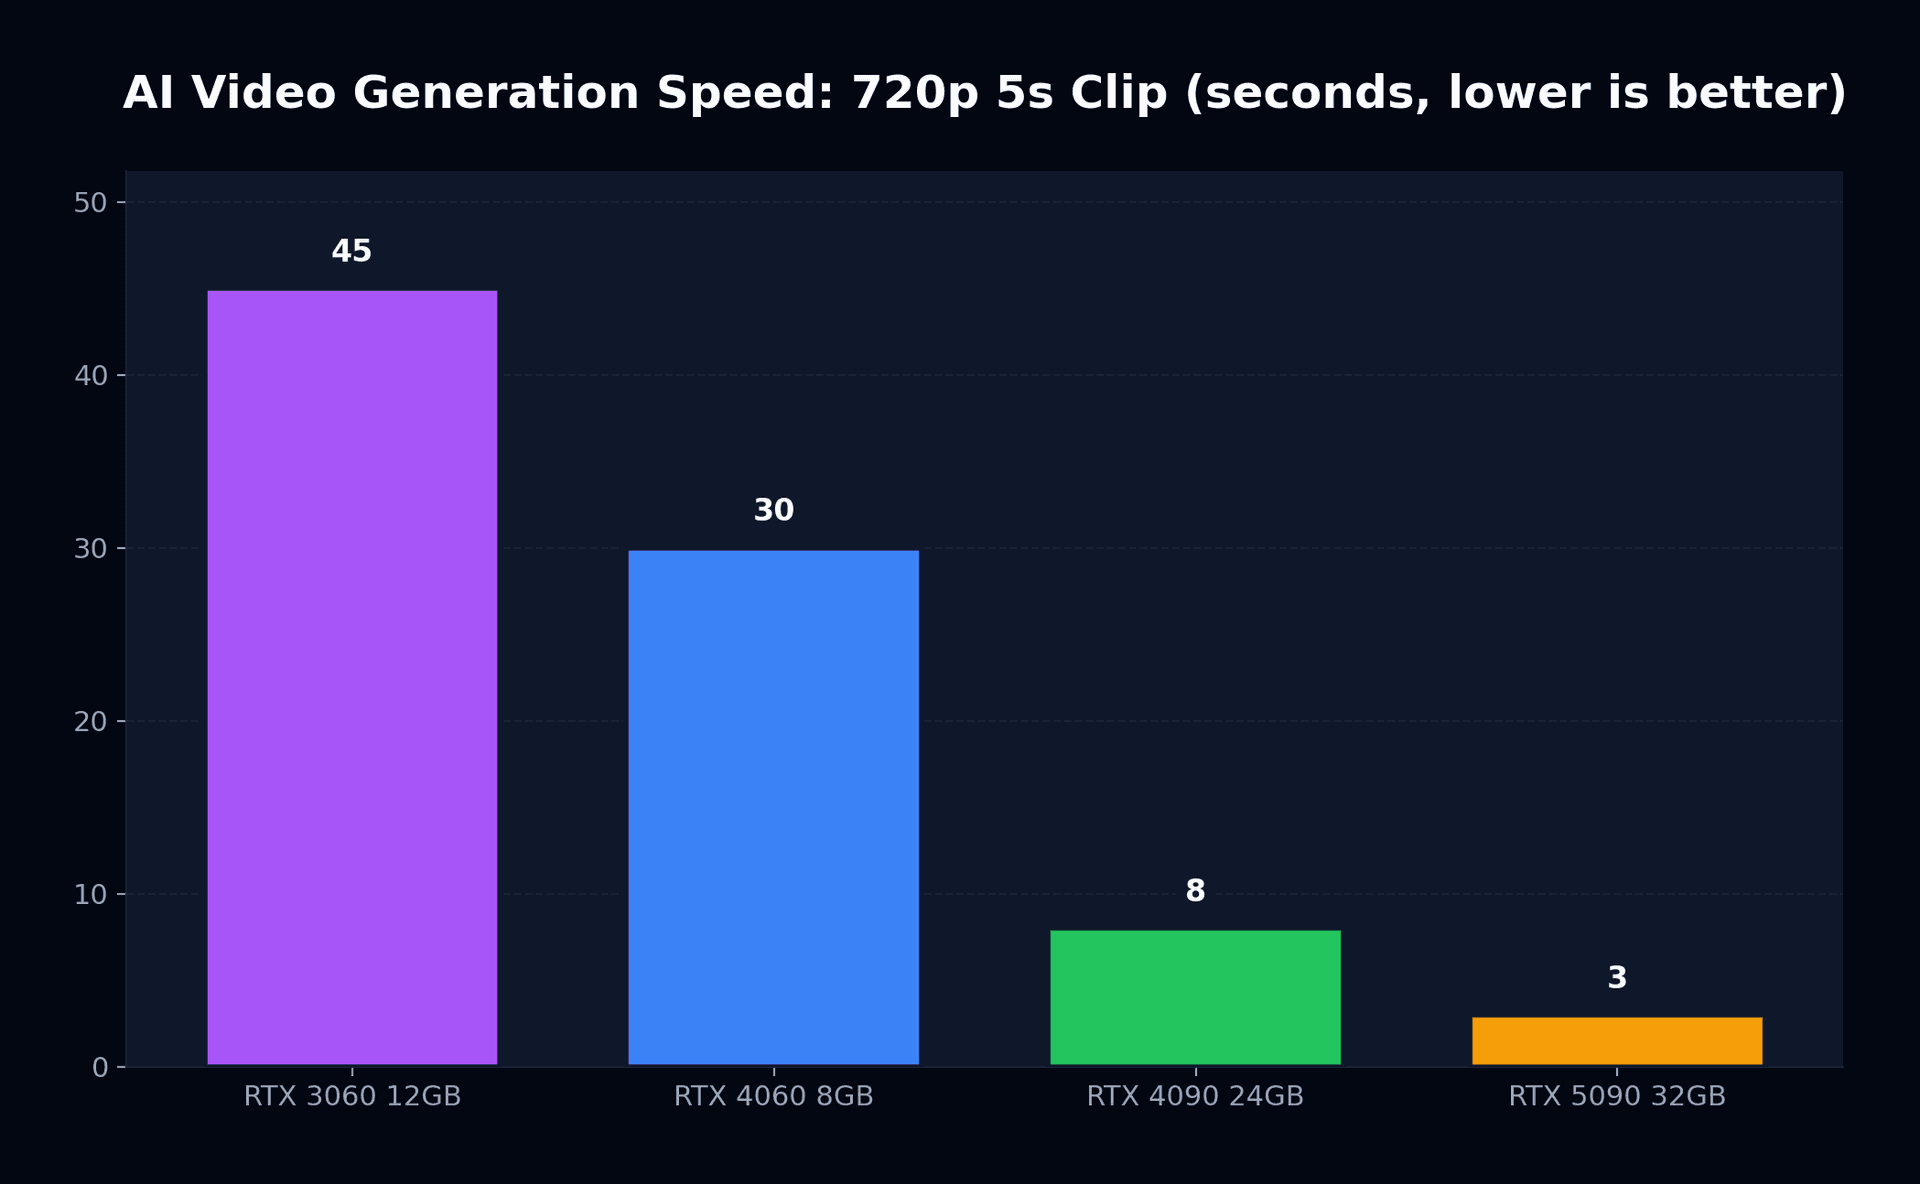
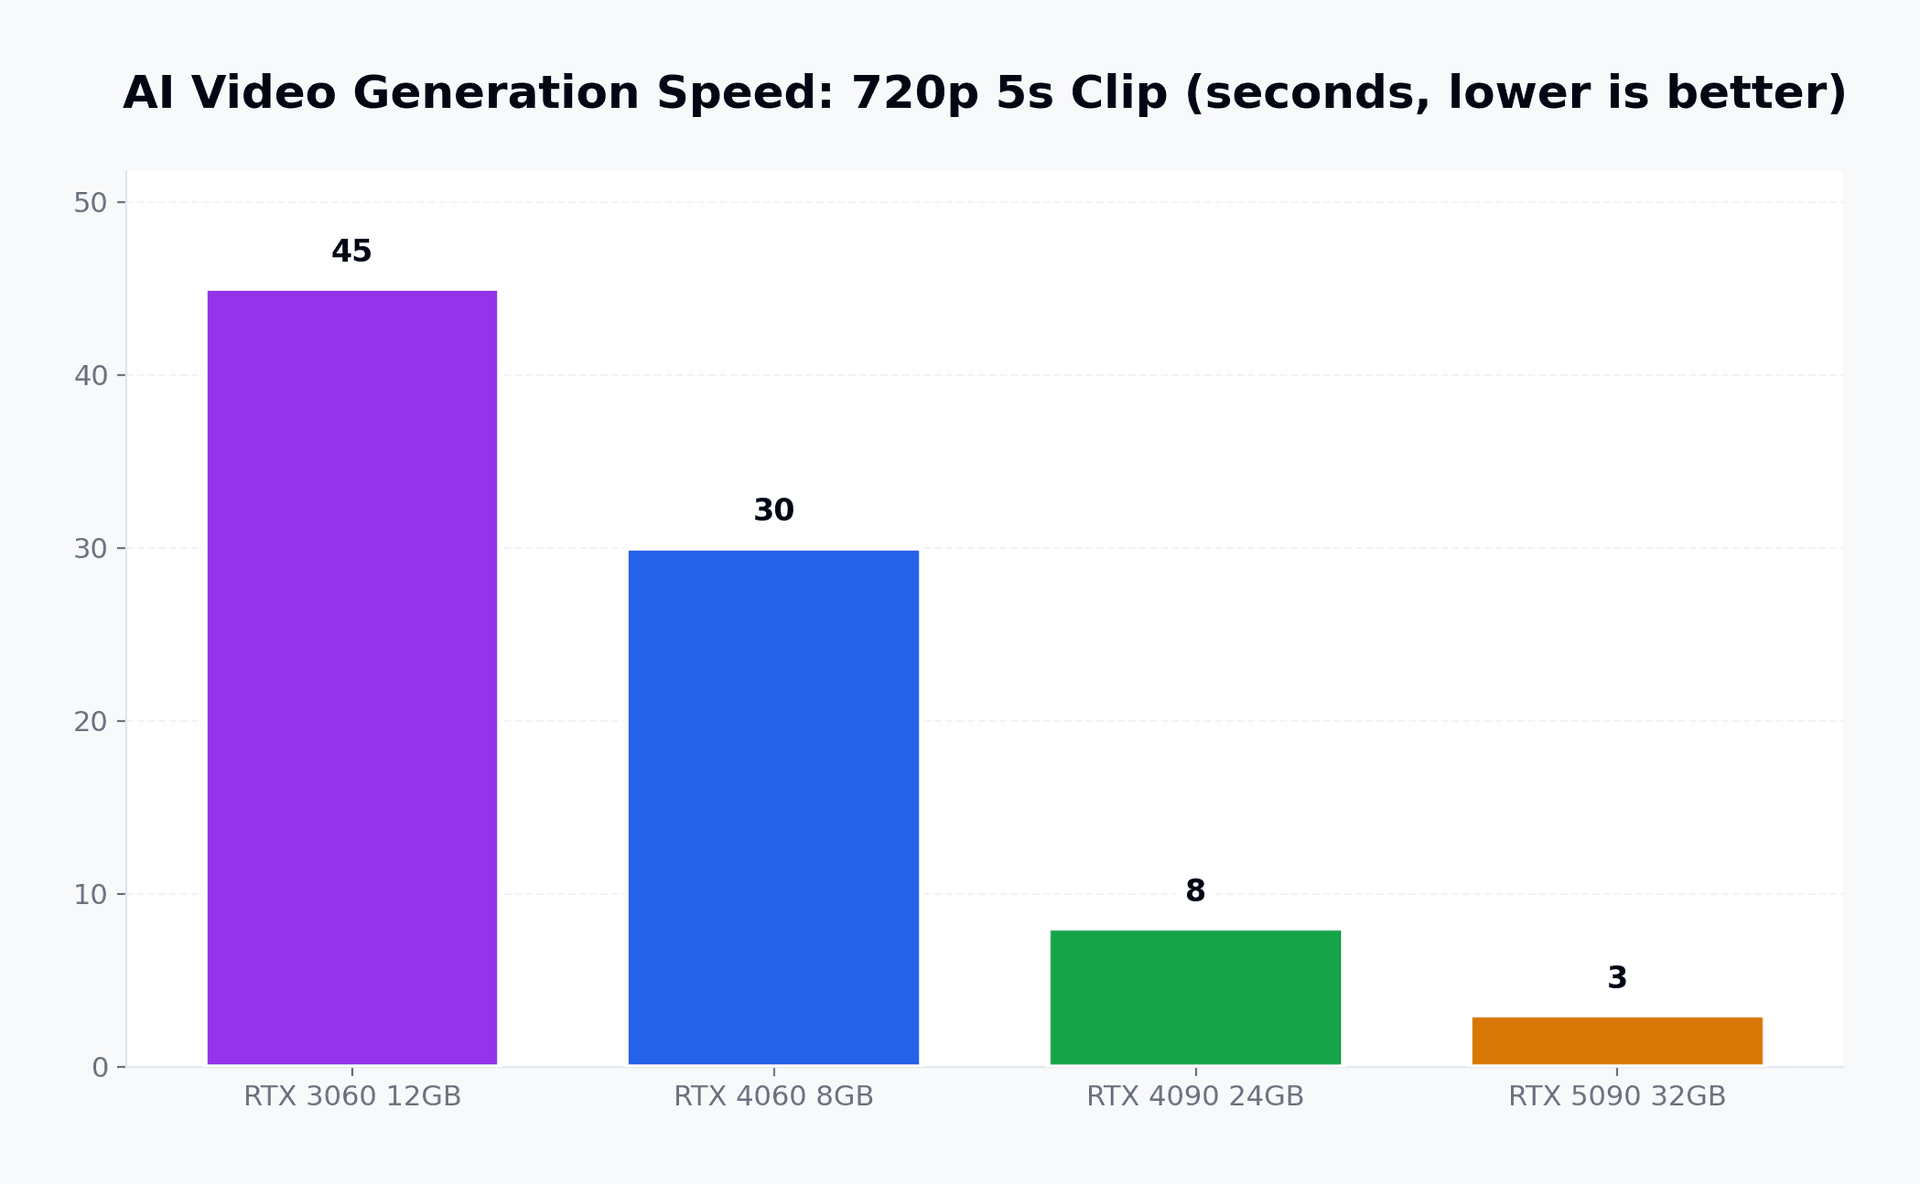
세대 간 성능 차이는 극적입니다. CES 2026에서 NVIDIA가 시연한 결과는 다음과 같습니다.
| GPU | 720p (5초 클립) | 1080p (5초 클립) | 4K (5초 클립) | VRAM 사용량 |
|---|---|---|---|---|
| RTX 3060 12 GB | 약 45초 | 약 90초 | 지원 안 됨 | 11 GB |
| RTX 4060 8 GB | 약 30초 | 약 60초 | 지원 안 됨 | 7.5 GB |
| RTX 4090 24 GB | 약 8초 | 약 15초 | 약 45초 | 18 GB |
| RTX 5090 32 GB | 약 3초 | 약 6초 | 약 15초 | 20 GB |
RTX 50 시리즈는 네이티브 NVFP4 양자화를 통해 눈에 띄는 품질 손실 없이 모델 가중치의 정밀도를 절반으로 줄여 3배의 속도 향상을 달성합니다. 이는 LLM을 소비자 하드웨어에서 실용적으로 만든 것과 동일한 기술이며, 이제 비디오 확산 모델(video diffusion)에도 적용되었습니다.
LTX-2의 특별한 점
LTX-2는 단순히 "또 하나의 오픈소스 모델"이 아닙니다. 소비자 하드웨어에서 가능한 작업의 근본적인 패러다임 전환을 보여줍니다.
최대 4K 50 FPS 20초 생성
내장 오디오 생성
멀티 키프레임 제어
LoRA 기반 커스터마이징
ComfyUI 통합
클라우드 서비스와의 비교
주요 클라우드 플랫폼과 비교했을 때 로컬 생성이 할 수 있는 것과 할 수 없는 것을 구체적으로 짚어보겠습니다.
| 기능 | LTX-2 (로컬) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| 최대 해상도 | 4K | 1080p | 4K | 1080p |
| 최대 길이 | 20초 | 20초 | 8초 | 10초 |
| 오디오 | 내장 | 별도 | 네이티브 | 별도 |
| 프라이버시 | 완전 보장 | 클라우드 | 클라우드 | 클라우드 |
| 월 비용 | $0 | $20-200 | $20-50 | $15-100 |
| 커스터마이징 | 완전 지원 (LoRA) | 제한적 | 제한적 | 보통 |
| 속도 (1080p, 5초) | 6-60초 (GPU에 따라 다름) | 30-120초 | 15-60초 | 20-90초 |
장단점은 명확합니다. 클라우드 서비스는 설정 과정이 적고 더 다듬어진 결과물을 제공하는 반면, 로컬 생성은 제어권, 프라이버시, 생성당 한계 비용 $0의 이점을 제공합니다. 이러한 클라우드 플랫폼 비교에 대한 자세한 내용은 Sora 2 vs Runway vs Veo 3 비교를 확인하세요.
ComfyUI로 LTX-2 설정하기: 단계별 가이드
실제 적용 가이드는 다음과 같습니다. 최소 8 GB VRAM이 장착된 NVIDIA GPU와 최신 드라이버가 설치되어 있다고 가정합니다.
1단계: ComfyUI 설치
ComfyUI는 확산 모델을 위한 노드 기반 시각적 인터페이스입니다. 언리얼 엔진의 블루프린트 시스템과 같지만, AI 생성 워크플로를 위해 설계된 도구라고 생각하시면 됩니다.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
2단계: LTX-2 모델 다운로드
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
3단계: LTX-2 ComfyUI 확장 기능 설치
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
4단계: 실행 및 생성
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
브라우저에서 http://127.0.0.1:8188에 접속합니다. 확장 기능의 예제 폴더에서 LTX-2 워크플로를 로드하고, 프롬프트를 입력한 다음 "Queue Prompt"를 클릭합니다.
설정 최적화
기본 설정이 작동한 후, 눈에 띄는 차이를 만들어내는 튜닝 팁들을 소개합니다.
VRAM 관리
로컬 생성에서 가장 큰 단일 병목 지점은 VRAM입니다. 보유한 리소스를 극대화하는 방법은 다음과 같습니다.
- ✓모델 오프로딩 활성화(사용하지 않는 레이어를 시스템 RAM으로 이동)
- ✓사용 중인 GPU 세대에 맞춰 NVFP8/NVFP4 양자화 사용
- ✓브라우저 탭 및 기타 GPU 사용량이 많은 애플리케이션 닫기
- ✓Windows 디스플레이 설정에서 "하드웨어 가속 GPU 일정 예약" 활성화
- ✓Linux 듀얼 부팅 고려(Windows 대비 GPU 활용률 5-10% 향상)
배치 처리 워크플로
많은 클립을 생성해야 하는 크리에이터를 위해 ComfyUI는 배치 큐(batch queuing)를 지원합니다. JSON 파일에 프롬프트를 설정하고 배치 로더 노드에 연결하면 밤새 GPU가 자동으로 작업을 처리합니다.
커스텀 스타일을 위한 LoRA 학습
이 부분이야말로 로컬 생성이 진정으로 빛을 발하는 지점입니다. RTX 4090에서 약 30분 만에 50-100개 프레임의 참조 영상으로 LoRA 어댑터를 학습시킬 수 있습니다. 그 결과 모델이 특정 시각적 스타일, 캐릭터 외형 또는 환경 미학을 반영하도록 유도하는 경량 파일(보통 100-300 MB)이 생성됩니다.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
비용 계산
구체적인 수치로 살펴보겠습니다. 매달 5초짜리 클립 100개를 생성하는 프리랜서 비디오 크리에이터라고 가정해 보겠습니다.
| 방식 | 월 비용 | 연간 비용 | 프라이버시 |
|---|---|---|---|
| Sora 2 Pro | $100/월 | $1,200/년 | 클라우드 |
| Runway Standard | $76/월 | $912/년 | 클라우드 |
| Veo (Google AI Pro) | $50/월 | $600/년 | 클라우드 |
| LTX-2 + RTX 4090 | 약 $15/월 (전기세) | 약 $180/년 | 완전 보장 |
RTX 4090의 MSRP는 약 $1,600이지만, 단종으로 인해 현재 시장 가격은 $2,500-2,800 선에 머물러 있습니다. 클라우드 서비스를 사용해 월 100개의 클립을 생성하는 경우, 시장 가격을 기준으로 하더라도 GPU는 18-24개월 이내에 비용을 회수하며, 그 이후에는 전기세만으로 비디오를 생성하게 됩니다.
앞으로 주목할 변화
로컬 AI 비디오 생성의 발전 속도는 점점 더 빨라지고 있습니다. 주목해야 할 세 가지 흐름은 다음과 같습니다.
LTX-2.1 출시
NVIDIA Rubin 플랫폼
Meta Mango (오픈소스 출시 가능성)
핵심 요약
클라우드 AI 비디오 서비스는 훌륭한 제품입니다. Sora, Veo, Runway는 모두 최소한의 설정만으로도 인상적인 결과를 제공합니다. 하지만 반복되는 비용, 개인정보 보호 문제, 인터넷 의존성, 제한된 커스터마이징 등 많은 크리에이터들이 받아들이기 어려워하는 트레이드오프가 존재합니다.
NVIDIA RTX GPU에서 ComfyUI와 함께 사용하는 LTX-2는 타협안이 아닙니다. 완전히 새로운 패러다임입니다. 모델 가중치부터 최종 출력까지 전체 파이프라인을 온전히 소유하는 방식입니다. 설정에는 반나절 정도가 걸립니다. 학습 곡선이 분명 존재하지만 충분히 감당할 수 있는 수준입니다. 그리고 결과물, 특히 최신 최적화가 적용된 4K 출력은 클라우드 대안들과 비교해도 충분히 경쟁력이 있습니다.
게임 세션 사이에 쉬고 있는 RTX GPU가 있다면, 두 번째 역할을 맡겨 보세요. 이 하드웨어가 무엇을 해낼 수 있는지 직접 확인하면 놀라실 것입니다.
관련 읽을거리: 오픈소스 AI 비디오 트렌드에 대해 더 알아보려면 오픈소스 AI 비디오 혁명과 LTX-2 네이티브 4K 생성 심층 분석을 확인하세요. 더 넓은 시장 상황이 궁금하시다면 AI 비디오의 $10 혁명: 가성비 도구가 대기업에 도전하는 방법을 살펴보시기 바랍니다.