2026년 최고의 AI 비디오 생성기는 무엇일까? 테스트 및 순위 비교
2026년 최고의 AI 비디오 생성기를 확인해 보세요. Veo 3.1, Runway, Kling을 초당 $0.045부터 $0.35에 이르는 다단계 파이프라인과 비교 테스트합니다.
 Alexis14 min read
AI 작성, 자동 검수, 편집자 책임
2026년 최고의 AI 비디오 생성기를 결정하려면 단순한 개별 벤치마크 클립을 넘어 실제 제작 안정성, API 단위 경제성, 그리고 멀티샷 일관성을 종합적으로 평가해야 합니다.
지난 12개월 동안 비디오 diffusion 생태계는 전문화된 엔진들로 세분화되었습니다. 독립형 text-to-video 인터페이스는 대체로 아키텍처적 한계에 도달했습니다. 최고 사양 부문에서는 Google DeepMind가 Google Cloud Vertex AI에서 초당 $0.35의 요금으로 자체 오디오 생성을 지원하는 Veo 3.1을 출시했습니다. 대량 처리 중심 부문에서는 MiniMax Hailuo H3가 추론 비용을 초당 $0.045까지 낮췄습니다. 한편 상업적 워크로드를 운영하는 제작 팀들은 단일 프롬프트 입력창 방식에서 완전히 벗어나, 공간적 구도와 시간적 움직임을 분리하는 다단계 아키텍처를 도입하고 있습니다.
2026 AI 비디오 매트릭스: 주요 모델 벤치마크
2026년 최고의 AI 비디오 생성기를 파악하기 위해 주요 프로덕션 모델들을 최대 렌더링 해상도, 자체 오디오 통합, 개발자 API 가격, 카메라 제어 정밀도라는 네 가지 측정 가능한 차원에서 비교했습니다.
| 모델 | 최대 해상도 | 자체 오디오 | 초당 API 비용 | 지연 시간 (6초 클립) | 주요 강점 |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | 지원 (대화 + Foley) | $0.350 | 120s | 시네마틱 디테일, 동기화된 사운드 |
| Runway Gen-4.5 | 1080p | 미지원 | $0.250 | 95s | 키프레임 카메라 경로, 모션 벡터 |
| Kling AI 2.0 | 1080p | 실험적 지원 | $0.080 | 85s | 인물 얼굴 일관성, 프롬프트 준수 |
| Luma Dream Machine | 1080p | 미지원 | $0.180 | 65s | 유연한 3D 시점 전환 |
| MiniMax Hailuo H3 | 768p / 1080p | 지원 (앰비언트 + 사운드) | $0.045 | 73s | 빠른 동적 물리, 낮은 생성 비용 |
| Bonega Pipeline | 1080p / 4K | 지원 | $0.070 | 60s | 다단계 오케스트레이션, 모델 종속성 제로 |
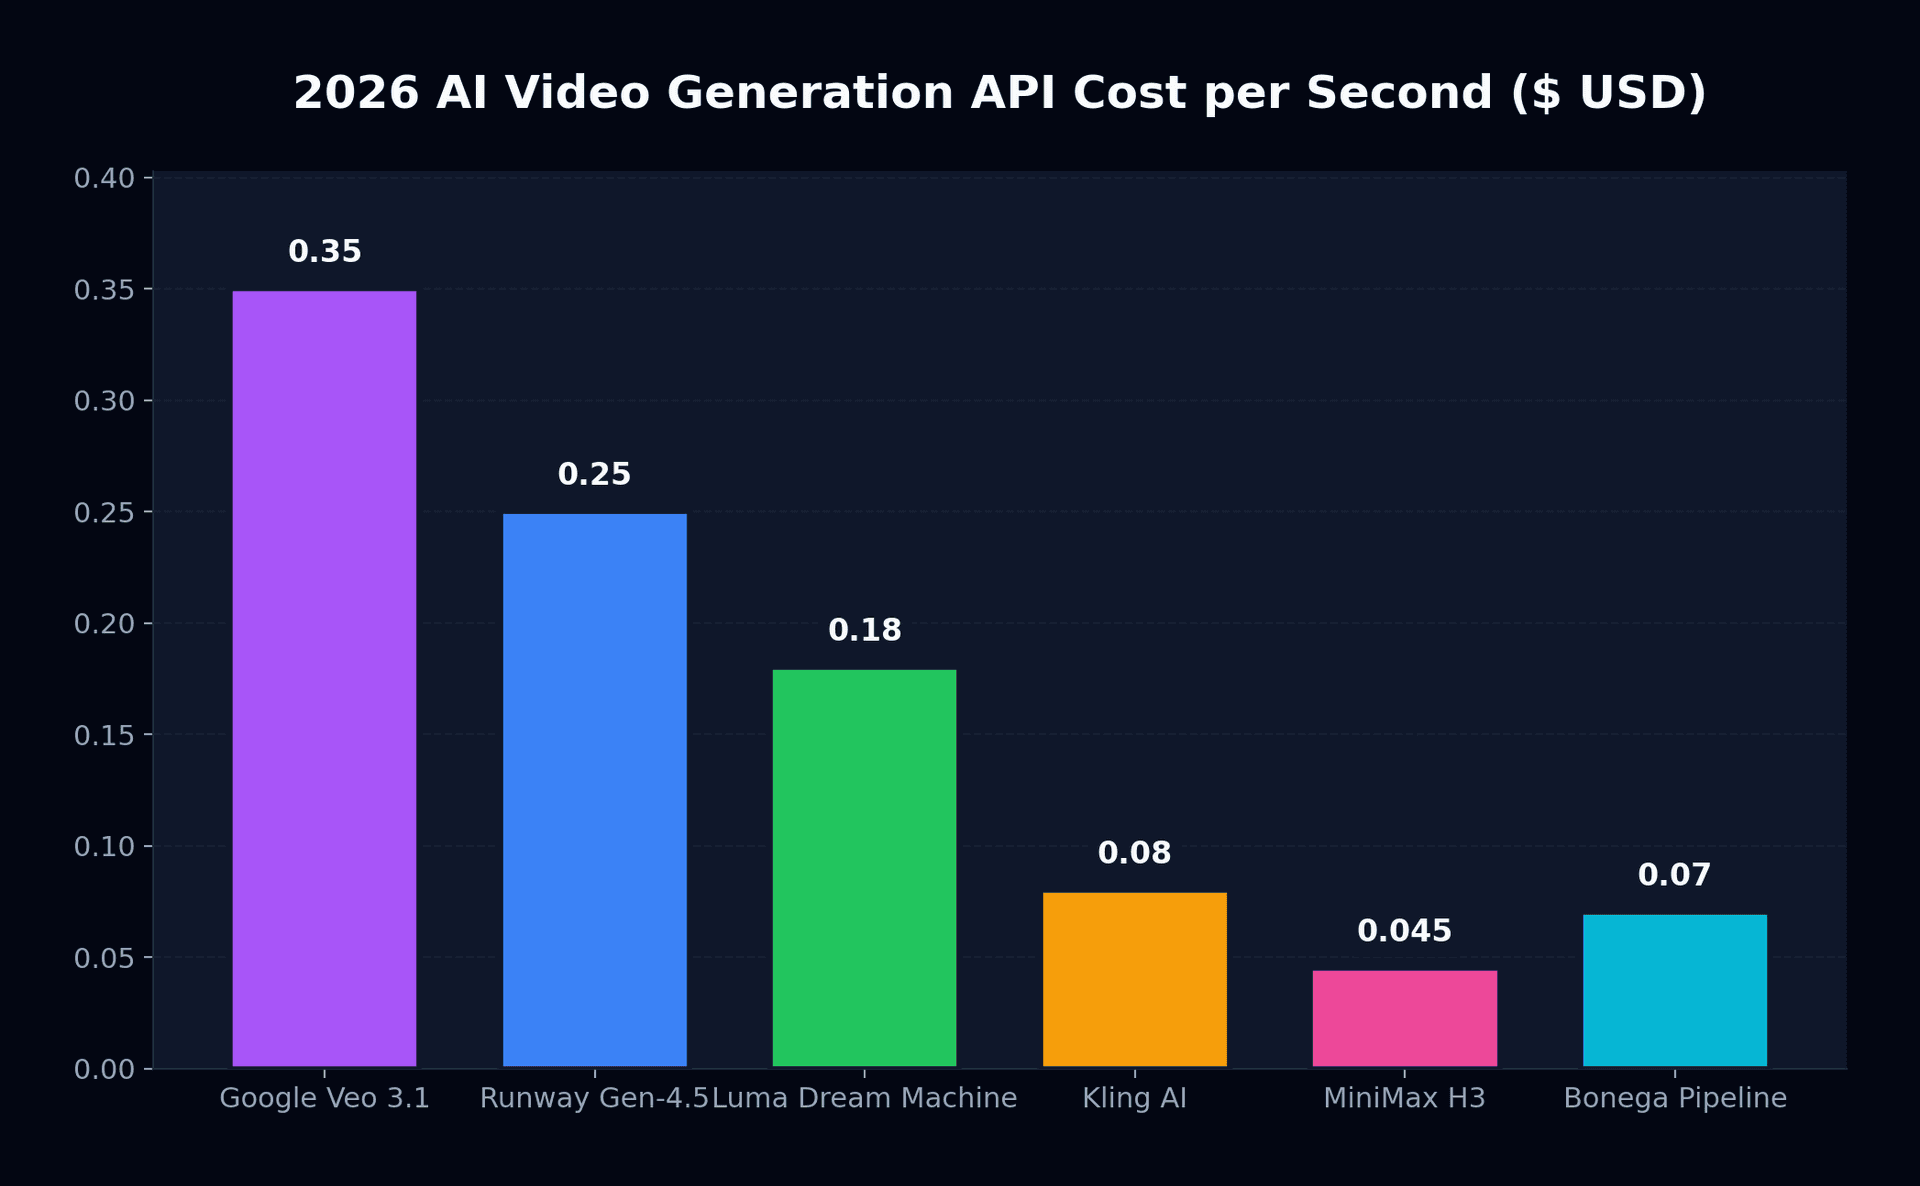
이들 엔진 간의 가격 차이는 거의 한 자릿수 규모에 달합니다. Veo 3.1 Quality 모드에서 매일 60초의 원본 비디오를 생성하는 크리에이터는 월 $630를 초과하는 API 비용을 부담해야 합니다. 반면 동일한 분량을 MiniMax H3로 실행하면 약 $81가 소요됩니다. 그러나 비용만으로 실용성을 단정할 수는 없습니다. 격렬한 스포츠 시퀀스는 고속 시간 훈련이 부족한 모델에서 쉽게 무너지며, 기업 인터뷰 장면에서는 Kling AI와 Veo가 보존해 주는 깨끗한 얼굴 형상이 필수적입니다.
단일 프롬프트 Text-to-Video 방식이 프로덕션에서 실패하는 이유
크리에이터가 연속적인 스토리텔링을 위해 2026년 최고의 AI 비디오 생성기를 살펴볼 때, 단일 프롬프트 모델은 실제 제작 테스트에서 지속적으로 한계를 드러냅니다. 근본적인 한계는 텐서 할당 문제입니다. 알고리즘이 자연어 토큰을 3차원 시공간 잠재 볼륨에 직접 매핑하려고 시도할 때, 공간적 형상과 시간적 물리 법칙을 동시에 해결해야 하기 때문입니다.
실제 환경에서는 이러한 문제로 인해 세 가지 전형적인 실패 양상이 나타납니다:
- 의미론적 시간 드리프트(Semantic Temporal Drift): 모델이 화면 재생 2초 만에 대상의 속성을 망각합니다. 프레임이 바뀔 때마다 의복 패턴이 변하고, 눈 색상이 달라지며, 장신구가 사라집니다.
- 프롬프트 과열 및 왜곡(Prompt Tax and Hallucination): 배경 건축물을 제어하기 위해 묘사 토큰을 추가하다 보면 전경의 캐릭터 해부학 구조가 손상되어 손이 일그러지거나 걸음걸이가 부자연스러워집니다.
- 정확한 프레이밍 구현의 불가능성: 감독이 배우가 바스트 샷(medium close-up)으로 시작해 와이드 3/4 프로필 샷으로 끝나기를 원하더라도, 텍스트 조건화만으로는 정확한 좌표 제약을 강제할 수 없습니다.
모델 진화에 대한 자세한 분석은 Google Veo 3.1 비디오 생성 리뷰와 2026년 최고의 Sora 대안 비교 가이드를 참고하세요.
다단계 Image-First 아키텍처
전문 스튜디오들은 시각적 정체성을 시간적 모션에서 분리함으로써 의미론적 드리프트를 해결했습니다. 텍스트 단어만으로 장면과 움직임을 한 번에 만들어내도록 단일 diffusion 모델에 요구하는 대신, 제작 팀들은 다단계 파이프라인을 구축합니다.
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
         └── Native 4K upscaling and synchronized Foley generation
Midjourney 비디오 가이드라인이나 전문 이미지 생성기를 활용해 사진 같은 첫 프레임을 생성함으로써, 크리에이터는 시간 벡터를 계산하기 전에 캐릭터의 정체성과 조명을 먼저 고정합니다. 그런 다음 비디오 엔진이 초기 프레임을 불변의 경계 조건으로 취급하면서 image-to-video 확산을 수행합니다.
첫 프레임에서 얼굴 기하학, 의상, 제품 브랜딩을 고정합니다. 생성 폐기율을 70%에서 15% 미만으로 낮추어 전체 제작 연산 비용을 대폭 절감합니다.
샷 간에 심각한 캐릭터 변형이 발생합니다. 허용 가능한 구도를 얻기 위해 수십 번의 프롬프트 반복이 필요하며, 반복성을 보장하지 못한 채 API 크레딧 소모를 배가시킵니다.
이 워크플로우의 구체적인 메커니즘은 frame-to-video AI 워크플로우 가이드에 상세히 정리되어 있습니다.
오케스트레이션 테제: 단일 모델 선택이 함정인 이유
단일 벤치마크 리더보드에서 2026년 최고의 AI 비디오 생성기가 무엇인지에만 매몰되기보다, 엔터프라이즈 팀들은 전체 파이프라인의 효율성을 평가합니다. 단 하나의 비디오 생성 플랫폼에 워크플로우 전체를 묶어두는 것은 운영상의 취약성을 야기합니다. 모델의 역량은 분기마다 바뀝니다. 스튜디오가 서로 다른 네 개의 서비스에 계정당 매월 $50에서 $200를 지불하며 개별 구독할 경우, 운영 오버헤드가 창작 결과물을 빠르게 압도하게 됩니다.
Bonega는 지능형 오케스트레이션 레이어로 기능하여 이러한 파편화를 해결합니다. Veo 3.1, Runway, MiniMax 중 하나를 억지로 선택하게 만드는 대신, Bonega는 파이프라인의 각 단계에 가장 적합한 모델을 자동으로 배치합니다:
- 첫 프레임 합성은 사실적인 이미지 모델을 사용해 고품질 키프레임을 생성하고, 구도와 캐릭터 정체성을 고정합니다.
- 모션 애니메이션은 움직임의 복잡도와 목표 가로세로 비율에 맞춰 키프레임을 최적의 image-to-video 엔진으로 전달합니다.
- 재생 시간 확장은 자동화된 프레임 매칭 알고리즘을 통해 짧은 클립들을 자연스러운 서사 시퀀스로 이어 붙입니다.
이 파이프라인은 text-to-video 제작 워크스페이스에서 직접 테스트해 보실 수 있으며, 3일 무료 체험이 포함된 월 $9부터 시작하는 플랜은 Bonega 요금제 페이지에서 확인할 수 있습니다. 표준 10초 모델 제한을 넘어 지속적인 클립 제작이 필요한 프로젝트라면 AI 비디오 확장 가이드를 확인해 보세요.
의사결정 프레임워크: 어떤 AI 비디오 생성기를 선택해야 할까?
특정 파이프라인에 맞춰 2026년 최고의 AI 비디오 생성기를 결정하는 문제는 다섯 가지 구체적인 제작 시나리오로 요약할 수 있습니다:
- 동시 대화와 앰비언트 사운드가 포함된 방송급 4K 해상도가 필요하고 초당 $0.35 예산을 감당할 수 있다면 Google Gemini API 문서를 통해 Google Veo 3.1을 도입하세요.
- 정밀한 카메라 모션 경로, 디렉터 그리드, 전문적인 후반 편집 제어가 필요한 프로젝트라면 Runway Gen-4.5를 선택하세요.
- 대규모 프로그래매틱 광고 베리에이션이나 빠른 템포의 소셜 비디오를 대량 제작해야 하며 초당 $0.045의 단위 경제성이 필수적이라면 MiniMax Hailuo H3를 선택하세요.
- 인물 얼굴의 사실감, 섬세한 미세 표정, 자연스러운 립싱크가 서사의 중심이라면 Kling AI 2.0을 활용하세요.
- 키프레임의 사실감과 역동적인 모션을 결합한 자동 다단계 파이프라인을 구축하고 개별 모델 구독이나 API 래퍼 관리 번거로움을 없애고 싶다면 Bonega를 선택하세요.
출처
- Google Cloud Vertex AI Pricing (Google Cloud)
- Google Gemini API Video Generation Documentation (Google AI)
- Midjourney Video Generation Guidelines (Midjourney)
자주 묻는 질문
- 2026년 최고의 AI 비디오 생성기는 무엇인가요?
- 모든 상업적 기준에서 전적으로 앞서는 단일 엔진은 없습니다. Veo 3.1은 내장 폴리(Foley) 사운드를 갖춘 독보적인 4K 시네마틱 선명도를 제공하고, Runway Gen-4.5는 공간 카메라 내비게이션을 선도하며, Hailuo H3는 매우 저렴한 비용으로 역동적인 모션을 지원합니다. 안정적인 장면 연속성을 확보하려면 정지 키프레임을 모션 모델과 연결하는 다단계 파이프라인이 단일 프롬프트 방식보다 일관되게 우수한 성능을 보여줍니다.
- 2026년 전문 AI 비디오 생성 비용은 얼마인가요?
- 상업용 API 가격은 경량 아시아 엔진의 초당 4.5센트부터 Google 고품질 모드의 초당 35센트까지 다양합니다. 일반적인 크리에이터 구독료는 월 $76에서 $249 사이입니다. 깨끗한 정지 이미지를 렌더링하고 선택된 프레임을 애니메이션화하는 모듈형 파이프라인은 초당 평균 7센트 수준입니다.
- 일관성 측면에서 왜 text-to-video보다 image-to-video가 더 나은가요?
- 직접적인 텍스트 프롬프팅은 신경망이 텍스트 단어로부터 캐릭터의 정체성, 배경 조명, 구도, 시간적 물리 법칙을 동시에 만들어내도록 강제합니다. 이로 인해 컷 사이에 심각한 캐릭터 왜곡이 발생합니다. 반면 사전 렌더링된 참조 이미지를 입력하면 정체성과 기하학적 구조가 고정되어 확산(diffusion) 네트워크가 오직 부드러운 모션 벡터를 계산하는 데만 집중할 수 있습니다.
- AI 비디오 생성기가 동기화된 음향 효과와 대화도 생성할 수 있나요?
- 고급 diffusion 아키텍처는 이제 시각적 프레임과 함께 동기화된 음성, 앰비언트 사운드스케이프, 기계적 폴리 오디오를 동시에 생성합니다. 이러한 기능은 짧은 소셜 에셋의 보조 오디오 후반 작업을 없애주지만, 복잡한 오케스트라 스코어링이나 보이스오버 마스터링은 여전히 전용 외부 오디오 워크스테이션에 의존합니다.