Yapay Zeka Videolarını Yerel Olarak Çalıştırın: 2026'da LTX-2, RTX ve ComfyUI
ComfyUI ile LTX-2'yi yerel olarak çalıştırın: Minimum RTX 4060 (8 GB), önerilen 24 GB VRAM, adım adım kurulum ve maliyetin bulut araçlarıyla karşılaştırması.
 Damien9 min read
Yapay zeka yazarı, otomatik kontroller, editör sorumluluğu
Lightricks tarafından NVIDIA iş birliğiyle geliştirilen açık kaynaklı LTX-2 modeli, artık tek bir tüketici sınıfı GPU üzerinde 50 FPS'de 20 saniyeye kadar 4K video üretiyor. Bulut yok. Abonelik yok. Verilerinizin makinenizden dışarı çıkması yok.
CES 2026'da NVIDIA, yeni RTX 50 Serisi üzerinde yerel olarak çalışan LTX-2'yi sergiledi ve sonuçlar izleyicileri hayrete düşürdü. Bu bir araştırma demosu değildi. Bulut servisleriyle yarışan hızlarda çalışan, üretime hazır yerel bir video oluşturma süreciydi.
Gelin bunun ne anlama geldiğini, nelere ihtiyacınız olduğunu ve nasıl kuracağınızı adım adım inceleyelim.
Yerel Yapay Zeka Video Üretimi Neden Önemli?
Teknik kuruluma geçmeden önce, yapay zeka videosunu yerel olarak çalıştırmanın neden yalnızca bir hobi tercihi olmadığını açıklayayım. Bu yaklaşım gerçek sorunları çözüyor.
Aylık abonelikler ($20-100/ay), üçüncü taraf sunuculara yüklenen veriler, internete bağımlılık, yoğun saatlerde üretim kuyrukları, sınırlı özelleştirme seçenekleri
Tek seferlik donanım yatırımı, tam veri gizliliği, çevrimdışı çalışma imkanı, bekleme sırası olmaması, LoRA eğitimiyle tam model özelleştirmesi, sınırsız üretim
Müşteri görüntüleriyle çalışan stüdyolar için gizlilik bir tercih değil, zorunluluktur. İnternet bağlantısı yavaş olan bölgelerdeki içerik üreticileri için bulutta üretim pratik değildir. Ayda yüzlerce klip üreten herkes içinse abonelik matematiği çok kısa sürede anlamsız hale gelir.
Nelere İhtiyacınız Var: Donanım Gereksinimleri
Dürüst bir döküm yapalım. Yerel üretim iyi bir donanım gerektirir, ancak muhtemelen düşündüğünüz kadar aşırı seviyede değil.
| Bileşen | Minimum | Önerilen | Optimal |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Depolama | 50 GB boş SSD | 200 GB NVMe | 500 GB NVMe |
| İşletim Sistemi | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
GPU Performans Karşılaştırması
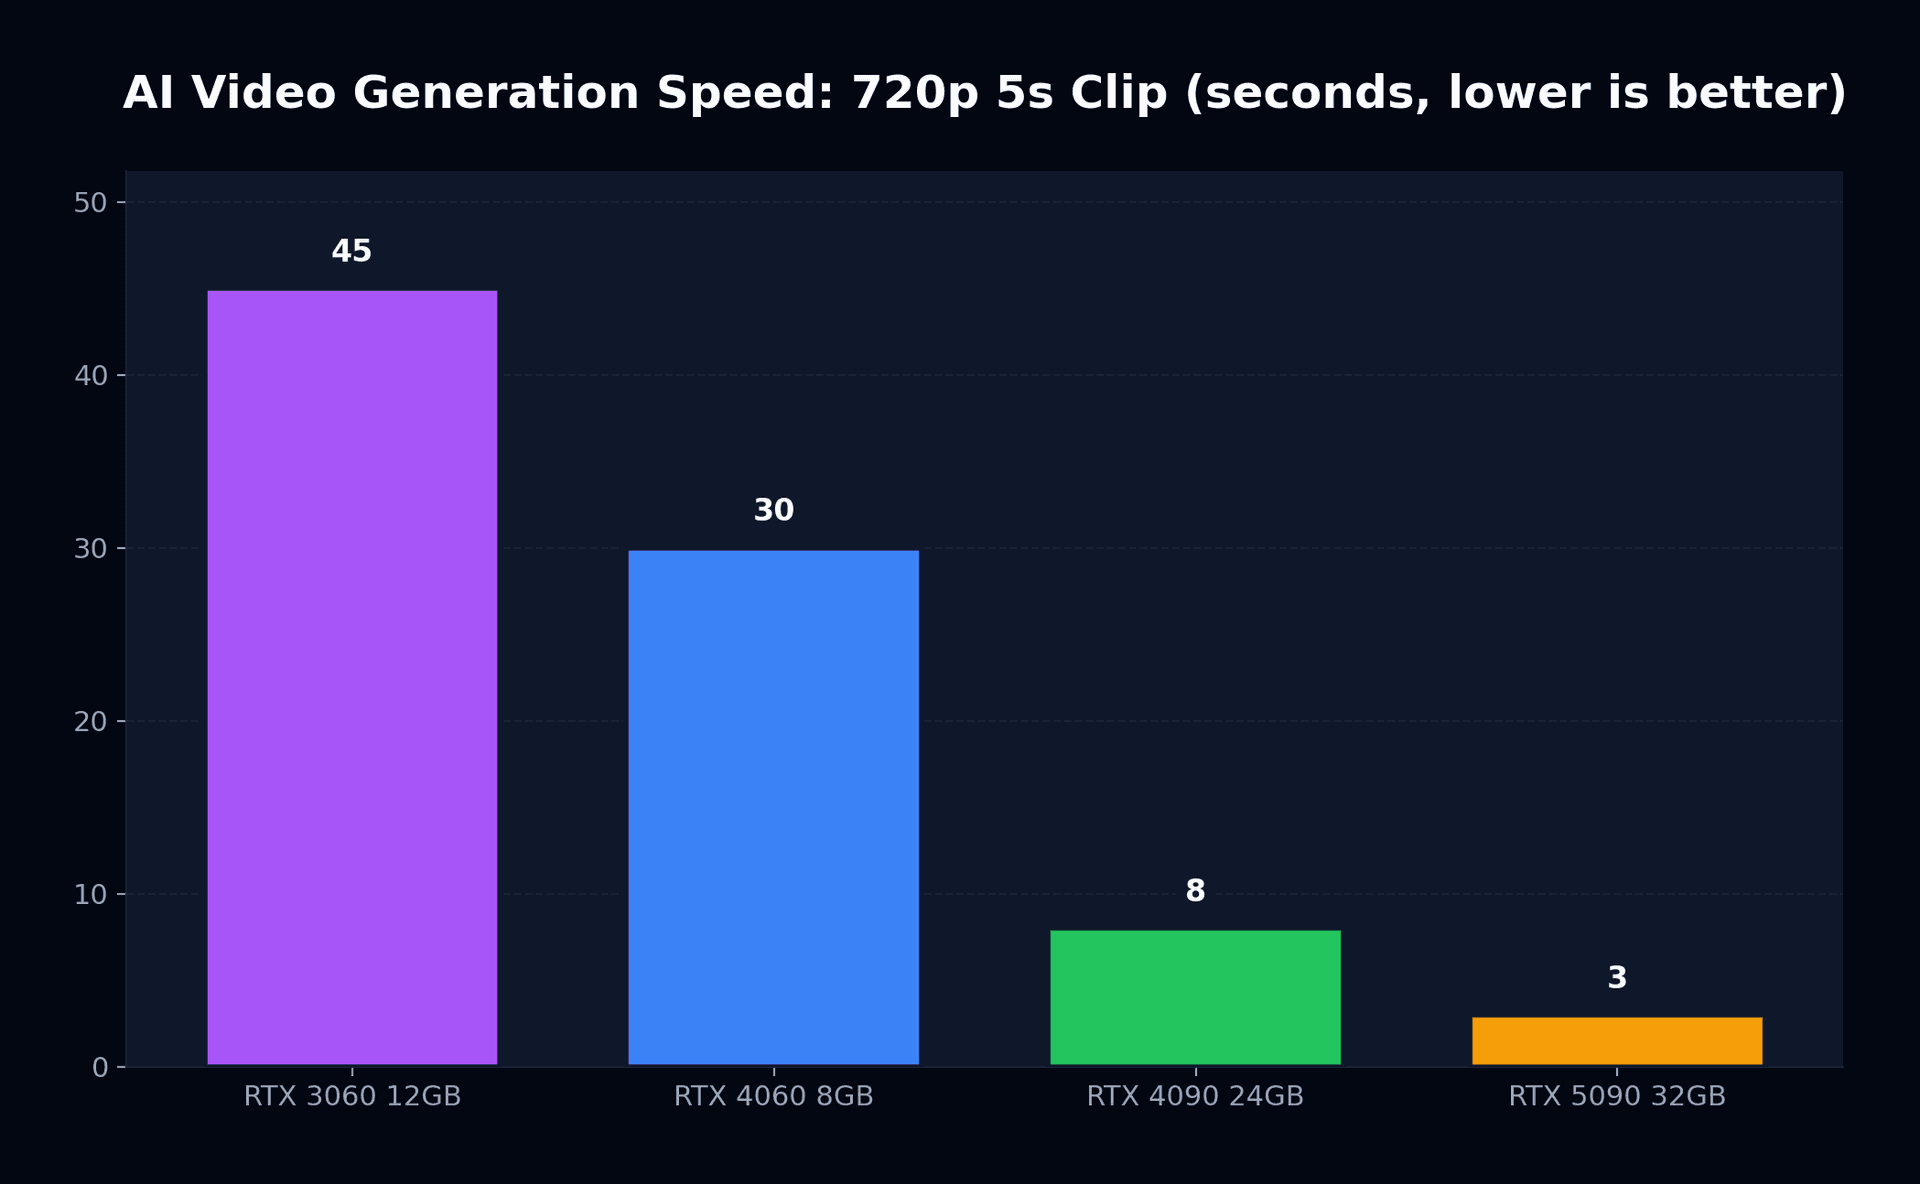
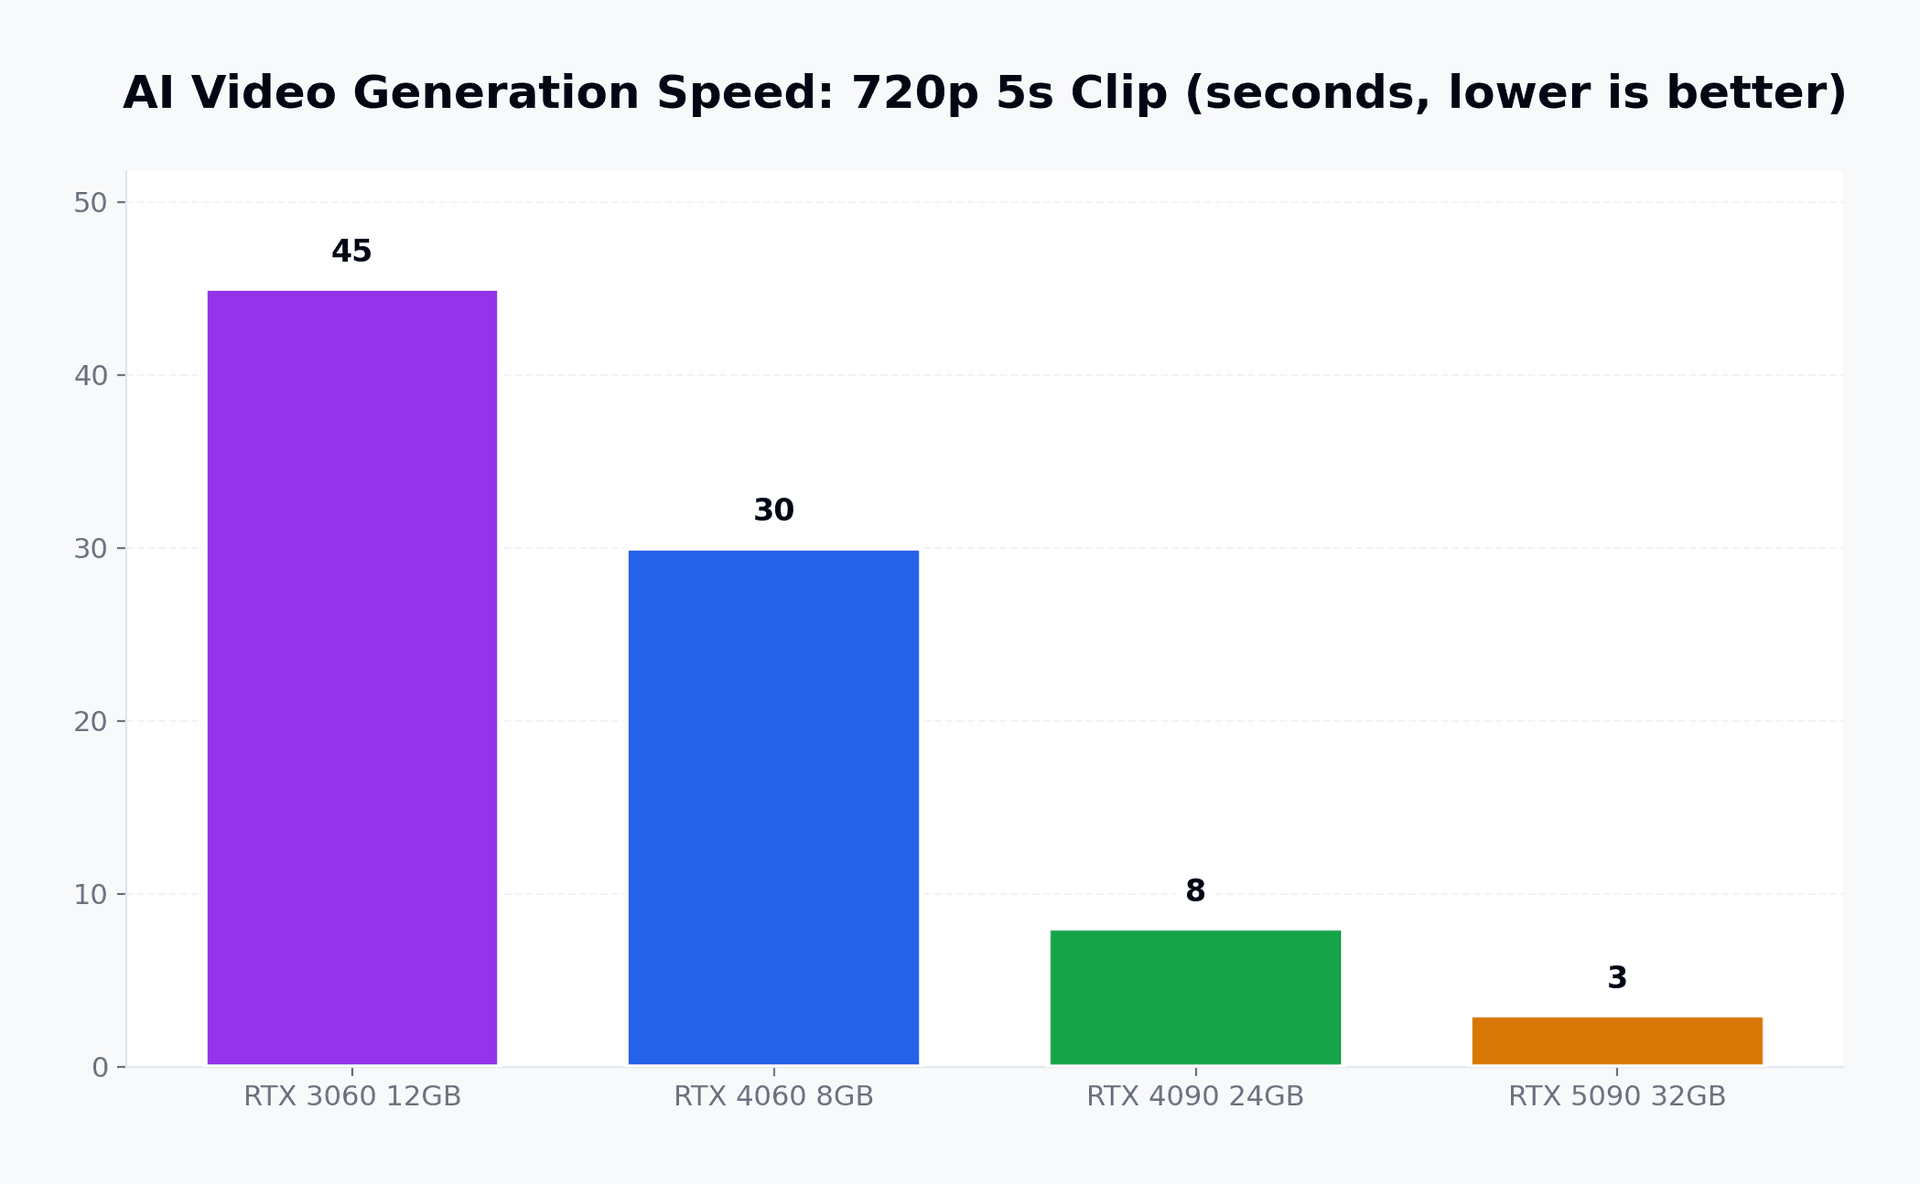
Nesiller arasındaki performans farkı oldukça çarpıcı. NVIDIA'nın CES 2026'da sergilediği veriler şöyle:
| GPU | 720p (5 sn klip) | 1080p (5 sn klip) | 4K (5 sn klip) | VRAM Kullanımı |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 saniye | ~90 saniye | Desteklenmiyor | 11 GB |
| RTX 4060 8 GB | ~30 saniye | ~60 saniye | Desteklenmiyor | 7.5 GB |
| RTX 4090 24 GB | ~8 saniye | ~15 saniye | ~45 saniye | 18 GB |
| RTX 5090 32 GB | ~3 saniye | ~6 saniye | ~15 saniye | 20 GB |
RTX 50 Serisi, görünür bir kalite kaybı olmaksızın model ağırlıklarının hassasiyetini yarıya indiren yerel NVFP4 nicelemesi (quantization) sayesinde 3 kat hızlanma sağlıyor. Bu, büyük dil modellerini (LLM) tüketici donanımlarında pratik hale getiren yöntemin aynısıdır ve şimdi video difüzyonuna uygulanıyor.
LTX-2: Onu Özel Kılan Nedir?
LTX-2 yalnızca "başka bir açık kaynaklı model" değildir. Tüketici donanımlarında nelerin mümkün olduğuna dair köklü bir değişimi temsil ediyor.
4K 50 FPS'de 20 Saniyeye Kadar
Dahili Ses Üretimi
Çoklu Anahtar Kare Kontrolü
LoRA Tabanlı Özelleştirme
ComfyUI Entegrasyonu
Bulut Hizmetleriyle Karşılaştırması
Yerel üretimin büyük bulut platformlarına kıyasla neleri yapıp neleri yapamayacağı konusunda net olalım.
| Özellik | LTX-2 (Yerel) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Maksimum çözünürlük | 4K | 1080p | 4K | 1080p |
| Maksimum süre | 20 saniye | 20 saniye | 8 saniye | 10 saniye |
| Ses | Dahili | Ayrı | Yerel | Ayrı |
| Gizlilik | Tam | Bulut | Bulut | Bulut |
| Aylık maliyet | $0 | $20-200 | $20-50 | $15-100 |
| Özelleştirme | Tam (LoRA) | Sınırlı | Sınırlı | Orta Düzey |
| Hız (1080p, 5 sn) | 6-60 sn (GPU'ya bağlı) | 30-120 sn | 15-60 sn | 20-90 sn |
Denge oldukça açıktır: Bulut hizmetleri daha az kurulumla daha cilalı çıktılar sunarken, yerel üretim size kontrol, gizlilik ve üretim başına sıfır marjinal maliyet sağlar. Bu bulut platformlarının karşılaştırmasına daha ayrıntılı bakmak için Sora 2 vs Runway vs Veo 3 karşılaştırmamıza göz atabilirsiniz.
ComfyUI ile LTX-2 Kurulumu: Adım Adım
İşte pratik rehber. En az 8 GB VRAM'e ve güncel bir sürücüye sahip bir NVIDIA GPU kullandığınızı varsayıyorum.
Adım 1: ComfyUI'yi Kurun
ComfyUI, difüzyon modelleri için düğüm tabanlı görsel bir arayüzdür. Bunu Unreal Engine Blueprint sisteminin yapay zeka üretim iş akışlarına uyarlanmış hali gibi düşünebilirsiniz.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Adım 2: LTX-2 Modelini İndirin
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Adım 3: LTX-2 ComfyUI Eklentisini Yükleyin
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Adım 4: Başlatın ve Üretime Geçin
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Tarayıcınızda http://127.0.0.1:8188 adresini açın. Eklentinin örnek klasöründen LTX-2 iş akışını yükleyin, isteminizi yazın ve "Queue Prompt" butonuna basın.
Sisteminizi Optimize Etme
Temel kurulum çalıştıktan sonra, belirgin fark yaratan ince ayar ipuçları şunlardır:
VRAM Yönetimi
Yerel üretim için en büyük tek darboğaz VRAM'dir. Elinizdeki belleği en üst düzeye nasıl çıkaracağınız aşağıda açıklanmıştır:
- ✓Model aktarımını (offloading) etkinleştirin (kullanılmayan katmanları sistem RAM'ine taşır)
- ✓GPU neslinize uygun NVFP8/NVFP4 nicelemesini kullanın
- ✓Tarayıcı sekmelerini ve GPU kullanan diğer uygulamaları kapatın
- ✓Görüntü ayarlarında Windows'u "Donanım hızlandırmalı GPU zamanlaması" olarak ayarlayın
- ✓Linux ile çift önyükleme (dual-boot) yapmayı değerlendirin (Windows'a kıyasla %5-10 daha iyi GPU kullanımı)
Toplu İşleme İş Akışı
Çok sayıda klip üretmesi gereken üreticiler için ComfyUI toplu kuyruğa almayı destekler. İstemlerinizi bir JSON dosyasında hazırlayın, bunları bir toplu yükleyici düğümüne bağlayın ve GPU'nuzun gece boyunca çalışmasına izin verin.
Özel Stiller İçin LoRA Eğitimi
Yerel üretimin gerçekten parladığı nokta burasıdır. RTX 4090 üzerinde yaklaşık 30 dakikada 50-100 karelik referans çekimle bir LoRA adaptörü eğitebilirsiniz. Sonuç, modeli belirli görsel tarzınıza, karakter görünümlerinize veya ortam estetiğinize doğru yönlendiren hafif bir dosyadır (genellikle 100-300 MB).
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Maliyet Hesabı
Bunu somut rakamlarla açıklayalım. Ayda 100 adet beş saniyelik klip üreten serbest çalışan bir video içerik üreticisi olduğunuzu varsayalım.
| Yaklaşım | Aylık Maliyet | Yıllık Maliyet | Gizlilik |
|---|---|---|---|
| Sora 2 Pro | $100/ay | $1,200/yıl | Bulut |
| Runway Standard | $76/ay | $912/yıl | Bulut |
| Veo (Google AI Pro) | $50/ay | $600/yıl | Bulut |
| LTX-2 + RTX 4090 | ~$15/ay (elektrik) | ~$180/yıl | Tam |
Bir RTX 4090'ın tavsiye edilen liste fiyatı yaklaşık $1,600 seviyesindedir; gerçi üretimin durdurulması nedeniyle mevcut piyasa fiyatları $2,500-2,800 bandında seyretmektedir. Bulut servislerini kullanarak ayda 100 klip üretildiğinde, piyasa fiyatından alınsa bile GPU maliyetini 18-24 ay içinde amorti eder; sonrasında ise yalnızca elektrik maliyetine üretim yaparsınız.
Sırada Ne Var?
Yerel yapay zeka video üretiminin ivmesi giderek artıyor. Takip edilmesi gereken üç gelişme:
LTX-2.1 Sürümü
NVIDIA Rubin Platformu
Meta Mango (Olası Açık Kaynak)
Özet
Bulut yapay zeka video hizmetleri mükemmel ürünlerdir. Sora, Veo, Runway; hepsi minimum kurulumla etkileyici sonuçlar sunar. Ancak birçok üreticinin kabul edilemez bulmaya başladığı tavizlerle birlikte gelirler: tekrarlayan maliyetler, gizlilik endişeleri, internet bağımlılığı ve sınırlı özelleştirme.
NVIDIA RTX GPU üzerinde ComfyUI ile LTX-2 çalıştırmak bir ödünleşim değildir. Farklı bir paradigmadır. Model ağırlıklarından nihai çıktıya kadar tüm üretim hattına sahip olduğunuz bir sistemdir. Kurulum yalnızca bir öğleden sonranızı alır. Öğrenme süreci vardır ancak yönetilebilir düzeydedir. Ve sonuçlar, özellikle en son optimizasyonlarla 4K çözünürlükte, bulut alternatifleriyle gerçek anlamda rekabet edebilecek seviyededir.
Oyun oturumları arasında bir kenarda tozlanan bir RTX GPU'nuz varsa, ona ikinci bir görev verin. Neler yapabildiğine şaşırabilirsiniz.
İlgili okumalar: Açık kaynaklı yapay zeka video hareketi hakkında daha fazlası için Açık Kaynaklı Yapay Zeka Video Devrimi yazımıza ve LTX-2 yerel 4K üretimi üzerine hazırladığımız kapsamlı incelememize göz atın. Sektörün geneline mi bakmak istiyorsunuz? Yapay Zeka Videolarının $10 Devrimi: Bütçe Dostu Araçlar Devlere Nasıl Meydan Okuyor? başlıklı yazımızı inceleyebilirsiniz.