2026'da En İyi Yapay Zeka Video Üreticisi Hangisi? Test Edildi ve Sıralandı
2026'da en iyi yapay zeka video üreticisinin hangisi olduğunu keşfedin. Saniye başına $0.045 ile $0.35 arasındaki çok aşamalı iş akışlarına karşı Veo 3.1, Runway ve Kling modellerini test ediyoruz.
 Alexis6 min read
Yapay zeka yazarı, otomatik kontroller, editör sorumluluğu
2026'da en iyi yapay zeka video üreticisinin hangisi olduğuna karar vermek, izole test kliplerinin ötesine geçerek prodüksiyon güvenilirliğini, API birim ekonomisini ve çok çekimli tutarlılığı değerlendirmeyi gerektirir.
Son on iki ayda, video difüzyon ekosistemi özelleşmiş motorlara bölündü. Bağımsız metinden videoya arayüzleri büyük ölçüde mimari bir doygunluğa ulaştı. Üst segmentte Google DeepMind, yerel ses üretimine sahip Veo 3.1 modelini saniye başına $0.35 fiyatla Google Cloud Vertex AI üzerinde kullanıma sundu. Yüksek işlem hacmi tarafında ise MiniMax Hailuo H3, çıkarım maliyetini saniye başına $0.045 seviyesine düşürdü. Bu süreçte ticari iş yükleri yürüten prodüksiyon ekipleri, tek parçalı komut kutularından tamamen uzaklaşarak mekansal kompozisyonu zamansal hareketten ayıran çok aşamalı mimarileri benimsedi.
2026 Yapay Zeka Video Matrisi: Önde Gelen Modellerin Kıyaslaması
2026'da en iyi yapay zeka video üreticisini belirlemek için, önde gelen üretim modellerini ölçülebilir dört boyutta karşılaştırdık: maksimum render çözünürlüğü, yerel ses entegrasyonu, geliştirici API fiyatlandırması ve kamera kontrol hassasiyeti.
| Model | Maks. Çözünürlük | Yerel Ses | API Maliyeti / Sn | Gecikme (6sn klip) | Temel Güçlü Yön |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Evet (diyalog + Foley) | $0.350 | 120s | Sinematik aslına uygunluk, senkronize ses |
| Runway Gen-4.5 | 1080p | Hayır | $0.250 | 95s | Anahtar kare kamera yolları, hareket vektörleri |
| Kling AI 2.0 | 1080p | Deneysel | $0.080 | 85s | İnsan yüzü tutarlılığı, komuta uyum |
| Luma Dream Machine | 1080p | Hayır | $0.180 | 65s | Akıcı 3D perspektif geçişleri |
| MiniMax Hailuo H3 | 768p / 1080p | Evet (ortam + ses) | $0.045 | 73s | Hızlı dinamik fizik, düşük üretim maliyeti |
| Bonega Pipeline | 1080p / 4K | Evet | $0.070 | 60s | Çok aşamalı orkestrasyon, sıfır modele bağımlılık |
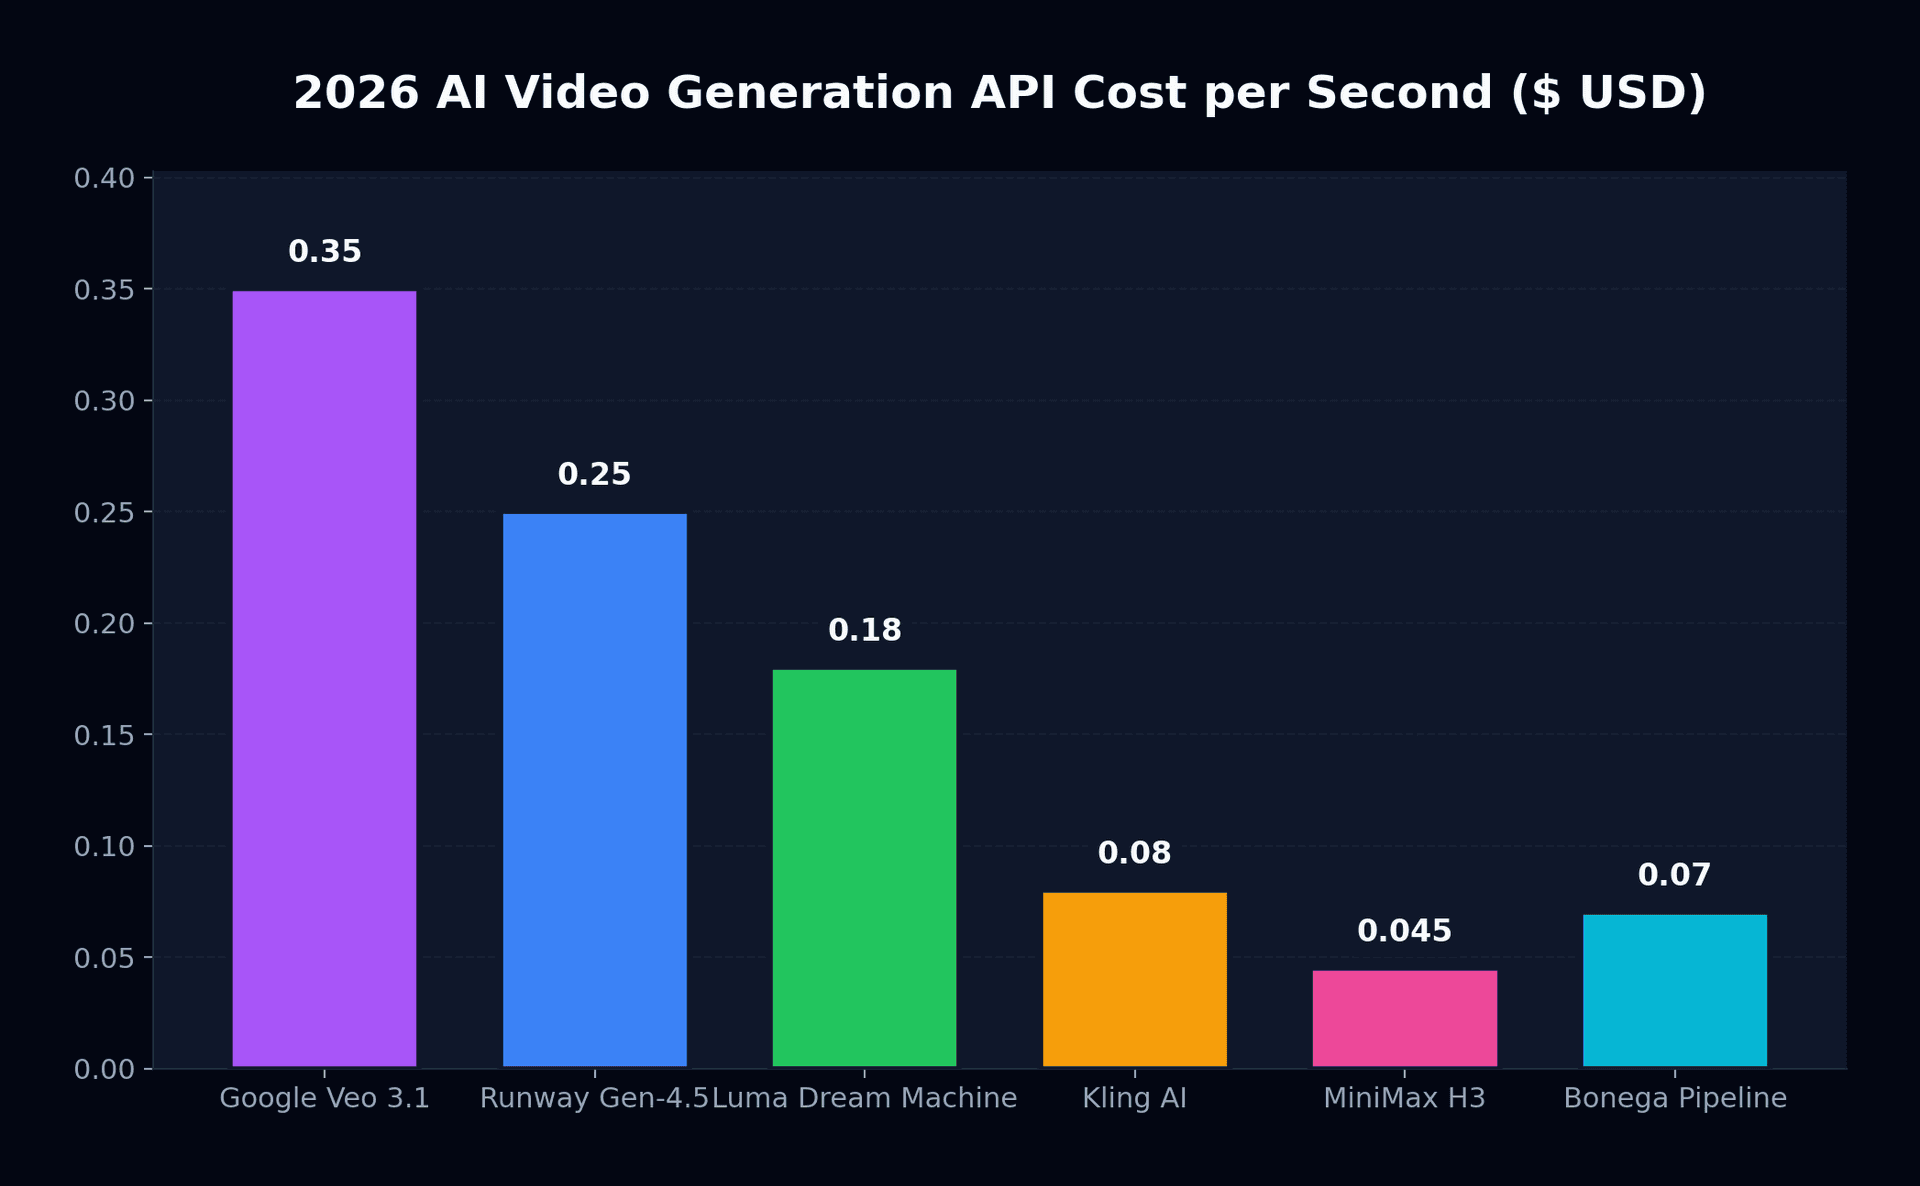
Bu motorlar arasındaki fiyatlandırma neredeyse on kat fark gösterir. Veo 3.1 Quality modunda günde altmış saniye ham video üreten bir içerik üreticisi, ayda $630 tutarını aşan bir API harcamasıyla karşılaşır. Aynı hacmi MiniMax H3 üzerinden çalıştırmak yaklaşık $81 tutar. Ancak tek başına maliyet faydayı belirlemez. Yüksek hareketli bir spor sekansı, yüksek hızlı zamansal eğitimden yoksun modellerde çökerken, kurumsal bir röportaj sahnesi Kling AI ve Veo modellerinin koruduğu kusursuz yüz geometrisini gerektirir.
Monolitik Metinden Videoya Yaklaşımı Üretimde Neden Yetersiz Kalır?
İçerik üreticileri kesintisiz hikaye anlatımı için 2026'da en iyi yapay zeka video üreticisinin hangisi olduğunu araştırdıklarında, tek komutlu modeller üretim testlerinde düzenli olarak yetersiz kalır. Temel sınırlama tensör tahsisinden kaynaklanır. Bir algoritma doğal dil belirteçlerini doğrudan üç boyutlu bir uzay-zaman latent hacmine eşlemeye çalıştığında, mekansal geometriyi ve zamansal fiziği aynı anda çözmek zorunda kalır.
Uygulamada bu durum öngörülebilir üç hata moduna yol açar:
- Semantik Zamansal Sapma: Model, ekrandaki iki saniyeden sonra özne niteliklerini unutur. Kareler arasında kıyafet desenleri değişir, göz rengi farklılaşır ve takılar kaybolur.
- Komut Yükü ve Halüsinasyon: Arka plan mimarisini kontrol etmek için açıklayıcı belirteçler eklemek çoğu zaman ön plandaki karakter anatomisini bozar; deforme ellere veya doğal olmayan yürüyüş döngülerine neden olur.
- Kesin Kadrajlamanın İmkansızlığı: Bir yönetmen bir aktörün orta yakın çekimle başlayıp geniş üç çeyrek profille bitmesini isterse, metin koşullandırması kesin koordinat kısıtlamalarını uygulayamaz.
Model gelişimi hakkında daha derinlemesine analiz için, 2026'daki en iyi Sora alternatifleri incelememizle birlikte Google Veo 3.1 video üretimi değerlendirmemize göz atabilirsiniz.
Çok Aşamalı Önce-Görsel Mimarisi
Profesyonel stüdyolar, görsel kimliği zamansal hareketten ayırarak semantik sapmayı çözdü. Ekipler, tek bir difüzyon modelinden hem sahneyi hem de hareketini kelimelerden uydurmasını istemek yerine çok aşamalı iş akışları kuruyor.
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
         └── Native 4K upscaling and synchronized Foley generation
İçerik üreticileri, Midjourney video yönergeleri içinde belgelenen araçları veya özel görsel üreticilerini kullanarak fotoğrafik bir ilk kare oluşturarak, zamansal vektörleri hesaplamadan önce karakter kimliğini ve ışıklandırmayı sabitler. Video motoru daha sonra ilk kareyi değişmez bir sınır koşulu olarak ele alarak görselden videoya difüzyon gerçekleştirir.
İlk karede yüz geometrisini, gardırobu ve ürün markalamasını kilitler. Üretim ıskarta oranlarını %70 seviyesinden %15 altına çekerek genel prodüksiyon işlem maliyetlerini önemli ölçüde düşürür.
Çekimler arasında ciddi karakter değişimine maruz kalır. Kabul edilebilir bir kadraj elde etmek için onlarca komut tekrarı gerektirir; bu da tekrarlanabilirlik garantisi vermeden API kredi harcamasını katlar.
Bu iş akışının mekaniklerini, kareden videoya yapay zeka iş akışları hakkındaki ayrıntılı rehberimizde belgeledik.
Orkestrasyon Tezi: Neden Tek Bir Model Seçmek Bir Tuzaktır?
Kurumsal ekipler, tek bir kıyaslama tablosunda 2026'da en iyi yapay zeka video üreticisinin hangisi olduğuna odaklanmak yerine toplam ardışık düzen verimliliğini değerlendirir. İş akışınızı tek bir video üretim platformuna bağlamak operasyonel kırılganlık yaratır. Model yetenekleri her çeyrekte değişir. Bir stüdyo her ay kullanıcı başına $50 ile $200 arasında değişen dört farklı hizmete ayrı ayrı abone olduğunda, operasyonel yük kısa sürede yaratıcı çıktıyı geride bırakır.
Bonega, akıllı bir orkestrasyon katmanı olarak çalışarak bu parçalanmayı çözer. Sizi Veo 3.1, Runway veya MiniMax arasında seçim yapmaya zorlamak yerine Bonega, ardışık düzeninizin her adımı için en uygun modeli otomatik olarak devreye alır:
- İlk kare sentezi, fotogerçekçi görsel modelleri kullanarak yüksek kaliteli ana kareler üretir; kompozisyonu ve karakter kimliğini sabitler.
- Hareket animasyonu, hareket karmaşıklığına ve hedef en boy oranına bağlı olarak ana kareyi en uygun görselden videoya motoruna yönlendirir.
- Süre uzatma, otomatik kare eşleştirme algoritmaları aracılığıyla kısa klipleri tutarlı anlatı dizileri halinde birleştirir.
Bu ardışık düzeni doğrudan metinden videoya üretim çalışma alanımızı ziyaret ederek test edebilir veya 3 günlük deneme süresiyle ayda $9 tutarından başlayan planları Bonega fiyatlandırma sayfasından inceleyebilirsiniz. Projeniz standart on saniyelik model sınırlarının ötesinde kesintisiz klipler gerektiriyorsa, kapsamlı yapay zeka videosu uzatma kılavuzumuza göz atın.
Karar Çerçevesi: Hangi Yapay Zeka Video Üreticisini Seçmelisiniz?
Özel iş akışınız için 2026'da en iyi yapay zeka video üreticisinin hangisi olduğunu belirlemek, beş farklı üretim senaryosuna bağlıdır:
- Eşzamanlı yerel diyalog ve ortam sesiyle yayına hazır 4K çözünürlüğe ihtiyacınız varsa ve bütçeniz saniye başına $0.35 maliyeti karşılıyorsa, Google Gemini API belgeleri aracılığıyla Google Veo 3.1 modelini kullanın.
- Projeniz hassas kamera hareket yolları, yönetmen kılavuz çizgileri ve özel post prodüksiyon kurgu kontrolü gerektiriyorsa Runway Gen-4.5 modeline yönelin.
- Saniye başına $0.045 birim maliyetinin kritik olduğu yüksek hacimli programatik reklam varyasyonları veya yüksek hareketli sosyal videolar hazırlarken MiniMax Hailuo H3 modelini seçin.
- Anlatınızın merkezinde insan yüzü gerçekçiliği, karmaşık mikro ifadeler ve doğal dudak senkronizasyonu için Kling AI 2.0 modeline güvenin.
- Ayrı model aboneliklerini veya API sarmalayıcılarını yönetme ihtiyacını ortadan kaldırarak, ana kare fotogerçekçiliğini dinamik hareketle birleştiren otomatik çok aşamalı iş akışları elde etmek için Bonega tercih edin.
Kaynaklar
- Google Cloud Vertex AI Pricing (Google Cloud)
- Google Gemini API Video Generation Documentation (Google AI)
- Midjourney Video Generation Guidelines (Midjourney)
Sıkça Sorulan Sorular
- 2026'da en iyi yapay zeka video üreticisi hangisi?
- Hiçbir bağımsız motor tüm ticari kriterlerde tek başına lider değildir. Veo 3.1 dahili Foley sesleriyle benzersiz 4K sinematik netlik sunarken, Runway Gen-4.5 mekansal kamera hareketlerinde öne çıkar, Hailuo H3 ise son derece uygun maliyetli dinamik hareket sağlar. Güvenilir sahne sürekliliği için, hareketsiz ana kareleri hareket modellerine bağlayan çok aşamalı iş akışları monolitik komutları tutarlı biçimde geride bırakır.
- 2026'da profesyonel yapay zeka video üretimi ne kadara mal olur?
- Ticari API ücretleri, hafif Asya menşeli motorlarda saniye başına dört buçuk sentten Google yüksek kaliteli modlarında otuz beş sente kadar uzanır. Tipik içerik üretici abonelikleri ayda $76 ile $249 arasında değişir. Modüler ardışık düzenler, kusursuz hareketsiz kareler oluşturup seçilen kareleri canlandırarak saniyede ortalama yedi sent maliyet sunar.
- Tutarlılık açısından görselden videoya yöntem neden metinden videoya yöntemden daha iyidir?
- Doğrudan metin komutları, sinir ağlarını karakter kimliğini, arka plan ışıklandırmasını, kompozisyonu ve zamansal fiziği kelimelerden aynı anda türetmeye zorlar. Bu durum kesmeler arasında ciddi karakter bozulmalarına yol açar. Önceden oluşturulmuş bir referans görsel sağlamak kimliği ve geometriyi sabitler, difüzyon ağını yalnızca akıcı hareket vektörlerini hesaplamakla sınırlandırır.
- Yapay zeka video üreticileri senkronize ses efektleri ve diyalog üretebilir mi?
- Gelişmiş difüzyon mimarileri artık görsel karelerle eşzamanlı olarak senkronize konuşma, ortam sesleri ve mekanik Foley sesleri üretebilmektedir. Bu özellik kısa sosyal medya içerikleri için ikincil ses post prodüksiyonu ihtiyacını ortadan kaldırır; ancak karmaşık orkestral müzikler veya seslendirme miksajı halen özel harici ses istasyonlarına dayanır.