أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي: دليل المبتدئين لعام 2026
اكتشف أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي في عام 2026: استخدم سير عمل تحويل الصورة إلى فيديو المكون من مرحلتين للتخلص من الأخطاء البصرية وخفض تكاليف التوليد إلى أقل من $0.30 لكل مقطع.
 Damien · كاتب ذكاء اصطناعي، فحوصات آلية، المسؤولية للمحرر8 min read
إذا سبق لك أن طلبت من مولد فيديو بالذكاء الاصطناعي تصميم شخص يسير نحو مقهى وحصلت على كتلة متحولة ثلاثية الأرجل، فأنت تعرف الإحباط الناتج عن التوليد المباشر من النص إلى فيديو. في اختباراتنا عبر آلاف عمليات التوليد، فإن التعامل مع الفيديو كمطالبة سحرية من خطوة واحدة يستهلك الرصيد بسرعة تفوق مزرعة تصيير معطلة.
تماماً مثل الطهي في مطبخ احترافي، يتطلب الإنتاج الجيد التحضير المسبق. أنت تجهز مكوناتك قبل إشعال الموقد. عندما تفصل بين تكوين الصورة وتوليف الحركة، تكتشف أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي بجودة متوقعة وقابلة للتكرار.
لماذا تفشل مطالبات تحويل النص إلى فيديو المباشرة للمبتدئين
عند إدخال مطالبة في محرك نقي لتحويل النص إلى فيديو، يواجه نموذج الانتشار الأساسي تحدياً رياضياً مستحيلاً. يجب عليه ابتكار الهندسة المكانية وملامح وجه الشخصية والإضاءة المحيطة والحركة الزمنية عبر 24 إطاراً في الثانية في آن واحد.
نظراً لأن النظام يحلل الضوضاء العشوائية عبر الزمان والمكان في اللحظة نفسها، فإن الانحرافات الحسابية الطفيفة في الإطارات المبكرة تتضاعف بشكل أسي. فاليد التي تمسك كوباً في الإطار 1 تتحول إلى مخلب بستة أصابع في الإطار 15. وتنزاح زاوية الكاميرا بشكل غير متوقع، أو يتغير لون قميص الشخصية في منتصف اللقطة.
في المقابل، فإن استخدام سير عمل إبداعي لتحويل الصورة إلى فيديو يزيل درجتين كاملتين من درجات الحرية من المعادلة. فوجه الشخصية وملابسها وزاوية الإضاءة وتكوين المشهد تكون مصيرة بالفعل بدقة عالية. ويتبقى لنموذج الفيديو مهمة واحدة فقط: حساب متجهات حركة واقعية لوحدات البكسل الموجودة بالفعل.
يعمل الإطار المرجعي كإطار مفتاحي بصري في الرسوم المتحركة الكلاسيكية. من خلال قفل الصورة الأولية، فإنك تمنح نموذج الفيديو أساساً متيناً، مما يمنع انحراف الشخصية وهلوسة الخلفية.
سير عمل الإطار المرجعي المكون من مرحلتين: خطوة بخطوة
إن فهم الآليات يحول إنشاء الفيديو من مجرد مقامرة إلى عملية هندسية. فيما يلي المسار المتدرج خطوة بخطوة الذي يشكل أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي اليوم.
الخطوة 1: توليد الإطار المفتاحي المرجعي الأولي
لا تطلب أبداً من نموذج الفيديو تصميم موضوعك. قم بتوليد إطار البداية في محرك صور مخصص مثل Midjourney أو Flux أو GPT Image. تتمتع نماذج الصور المخصصة بالتزام فائق بالمطالبات، ونسيج أكثر وضوحاً، وفهم تشريحي أفضل بكثير من محركات الفيديو. بالنسبة للمنشئين الذين يبحثون عن أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي دون انحراف في ملامح الشخصية، فإن البدء بإطار مرجعي نظيف يختصر ساعات من التجربة والخطأ.
راجع الإطار المفتاحي بعناية قبل التحريك:
- تأكد من أن اليدين والأصابع وتناسق الوجه تظهر بنظافة تامة.
- تأكد من أن نسبة العرض إلى الارتفاع تطابق تنسيقك المستهدف (9:16 رأسي للهاتف، أو 16:9 لسطح المكتب).
- تأكد من أن الإضاءة الاتجاهية توفر إشارات عمق واضحة لتقدير الحركة.
إن قضاء دقيقتين وإنفاق $0.02 لتوليد خمسة تنويعات من الصور يوفر $2.00 من تصييرات الفيديو المستبعدة لاحقاً.
الخطوة 2: كتابة مطالبات مخصصة للحركة فقط
الخطأ الأكثر شيوعاً بين المبتدئين في توليد الفيديو من الصور هو إعادة وصف الصورة. إذا كانت صورتك تظهر طاهياً يقطع البصل على لوح خشبي، فلا تكتب: "طاهٍ يرتدي مئزراً أبيض يقطع بصلاً أصفر في مطبخ مشمس."
النموذج يرى بالفعل الطاهي والمئزر والبصل والمطبخ. وكتابة هذه الكلمات تجبر النموذج على إعادة تفسيرها، مما يؤدي إلى تشوه القوام والنسيج.
بدلاً من ذلك، يجب أن تحتوي مطالبتك على أفعال الحركة وتعليمات الكاميرا فقط:
- جيد:
"طاهٍ يقطع البصل بحركة إيقاعية ثابتة، وتتحرك الكاميرا ببطء مقتربة بنسبة 10% نحو لوح التقطيع." - سيئ:
"طاهٍ سينمائي بدقة 4K واقعي للغاية يقطع البصل في مطبخ مشرق."
تفسر محركات الفيديو الرئيسية مثل أدوات Runway الإبداعية ومنصة توليد Kling AI توجيهات الحركة المنفصلة بدقة أعلى بكثير عند حذف الأوصاف البصرية.
الخطوة 3: تطبيق قاعدة اللقطة ذات الخمس ثوانٍ
غالباً ما يحاول المبتدئون توليد مقاطع مستمرة مدتها 15 ثانية أو 30 ثانية. في الفيديو التوليدي، يتدهور التماسك الزمني بشكل حاد بعد 6 ثوانٍ.
المحررون المحترفون لا يصورون لقطات مستمرة مدتها 30 ثانية للمحتوى سريع الوتيرة، ويجب ألا تفعل ذلك أيضاً. قسّم فكرتك إلى لقطات منفصلة مدة كل منها خمس ثوانٍ:
- اللقطة الأولى (5s): مشهد افتتاحي مع تحريك أفقي بطيء للكاميرا.
- الزاوية الثانوية (5s): لقطة متوسطة مقربة للشخصية أثناء أداء حركة معينة.
- الإدراج النهائي (5s): لقطة رد فعل من فوق الكتف أو لقطة تفصيلية مقربة.
إن توليد ثلاثة مقاطع موجهة مدة كل منها 5 ثوانٍ ينتج فيديو أكثر جاذبية بكثير من لقطة واحدة مشتتة مدتها 15 ثانية، مع خفض عمليات التصيير الفاشلة إلى ما يقارب الصفر. بالنسبة للمنشئين الذين ينتجون مقاطع قصيرة عمودية، يشرح دليلنا حول كيفية إنشاء فيديوهات TikTok بالذكاء الاصطناعي التجميع السريع لعدة مقاطع بالتفصيل.
تفصيل التكاليف: إدارة الأرصدة وميزانيات المنصات
يركز تسعير توليد الفيديو في عام 2026 على أرصدة الاستهلاك بدلاً من الخطط غير المحدودة الثابتة. يساعدك فهم كيفية استهلاك المنصات للرصيد في اختيار الإعداد الأنسب لحجم إنتاجك.
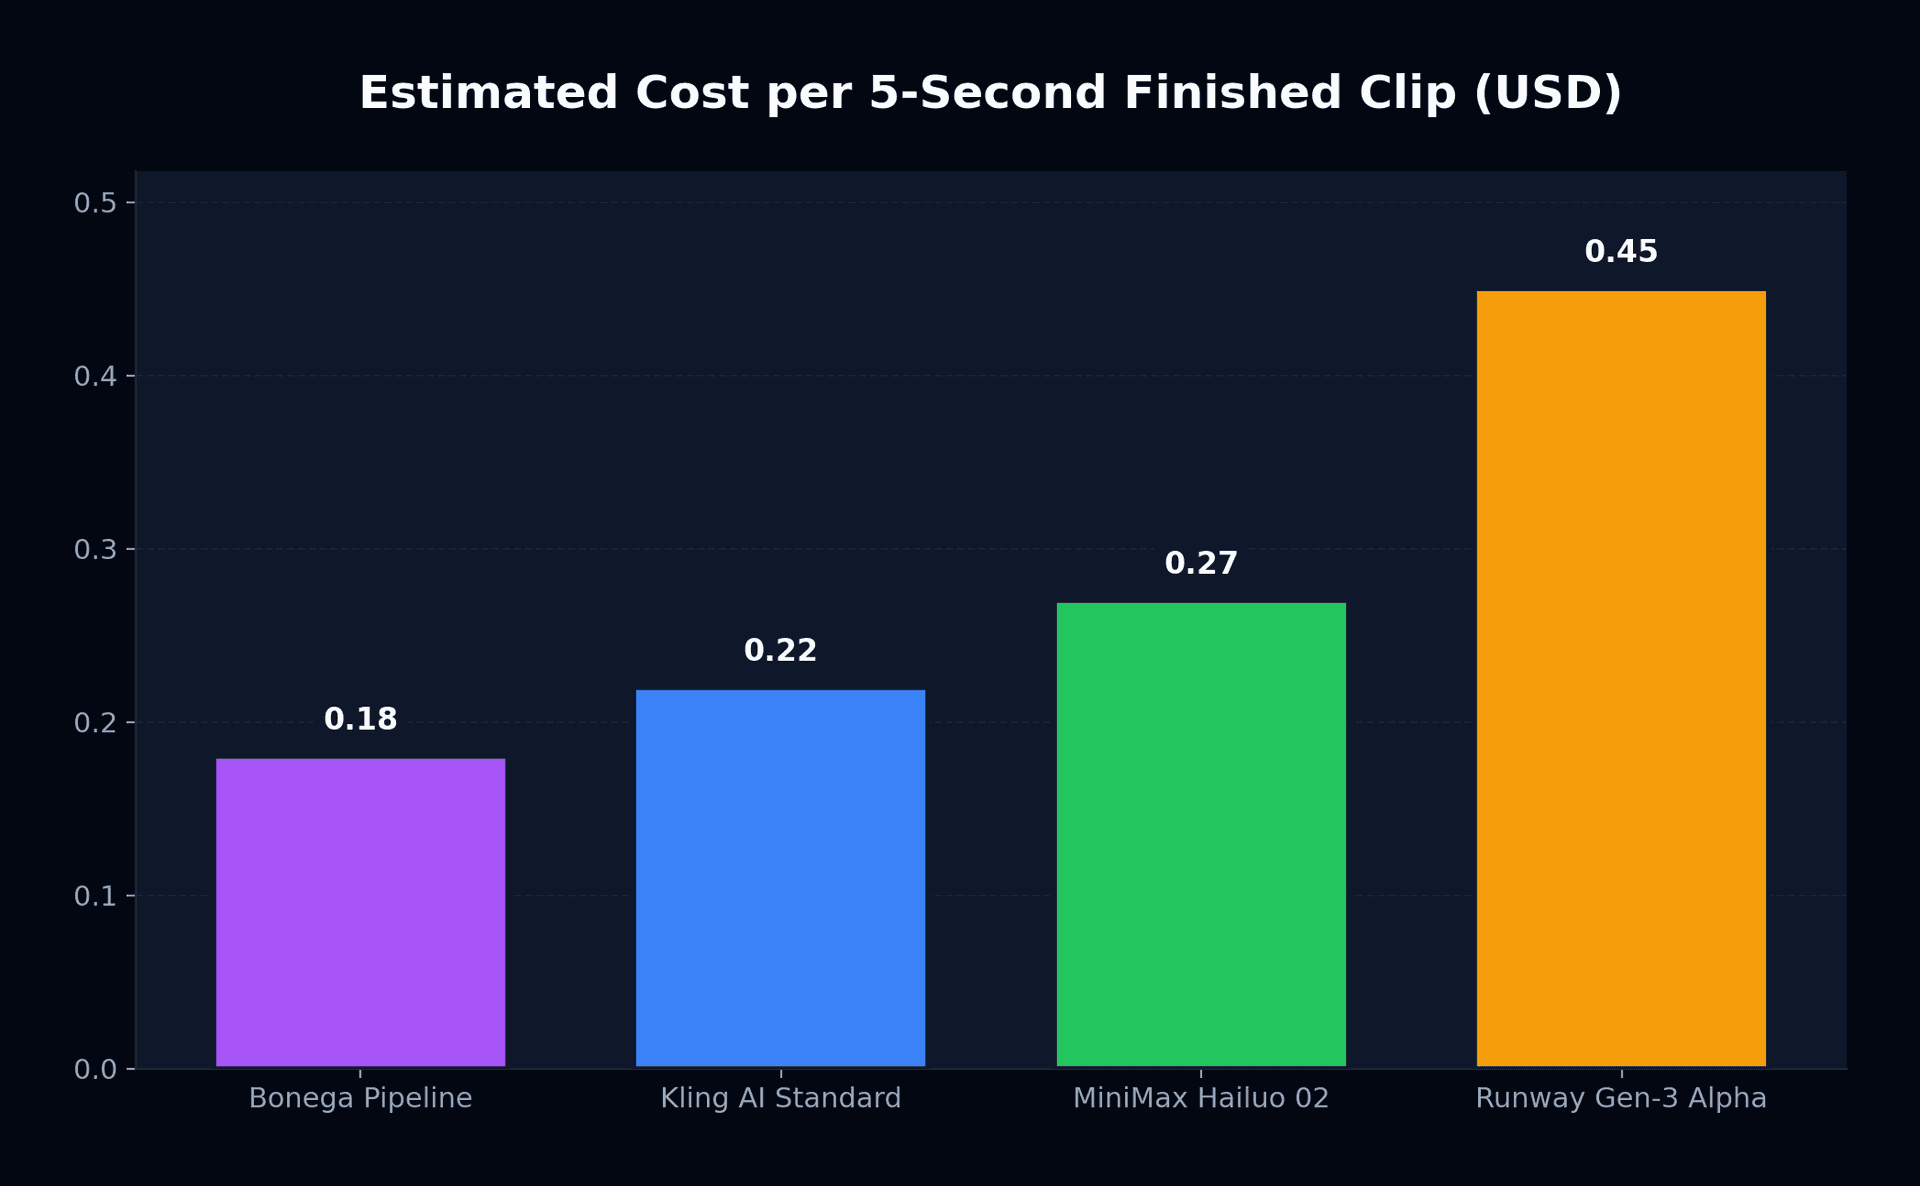
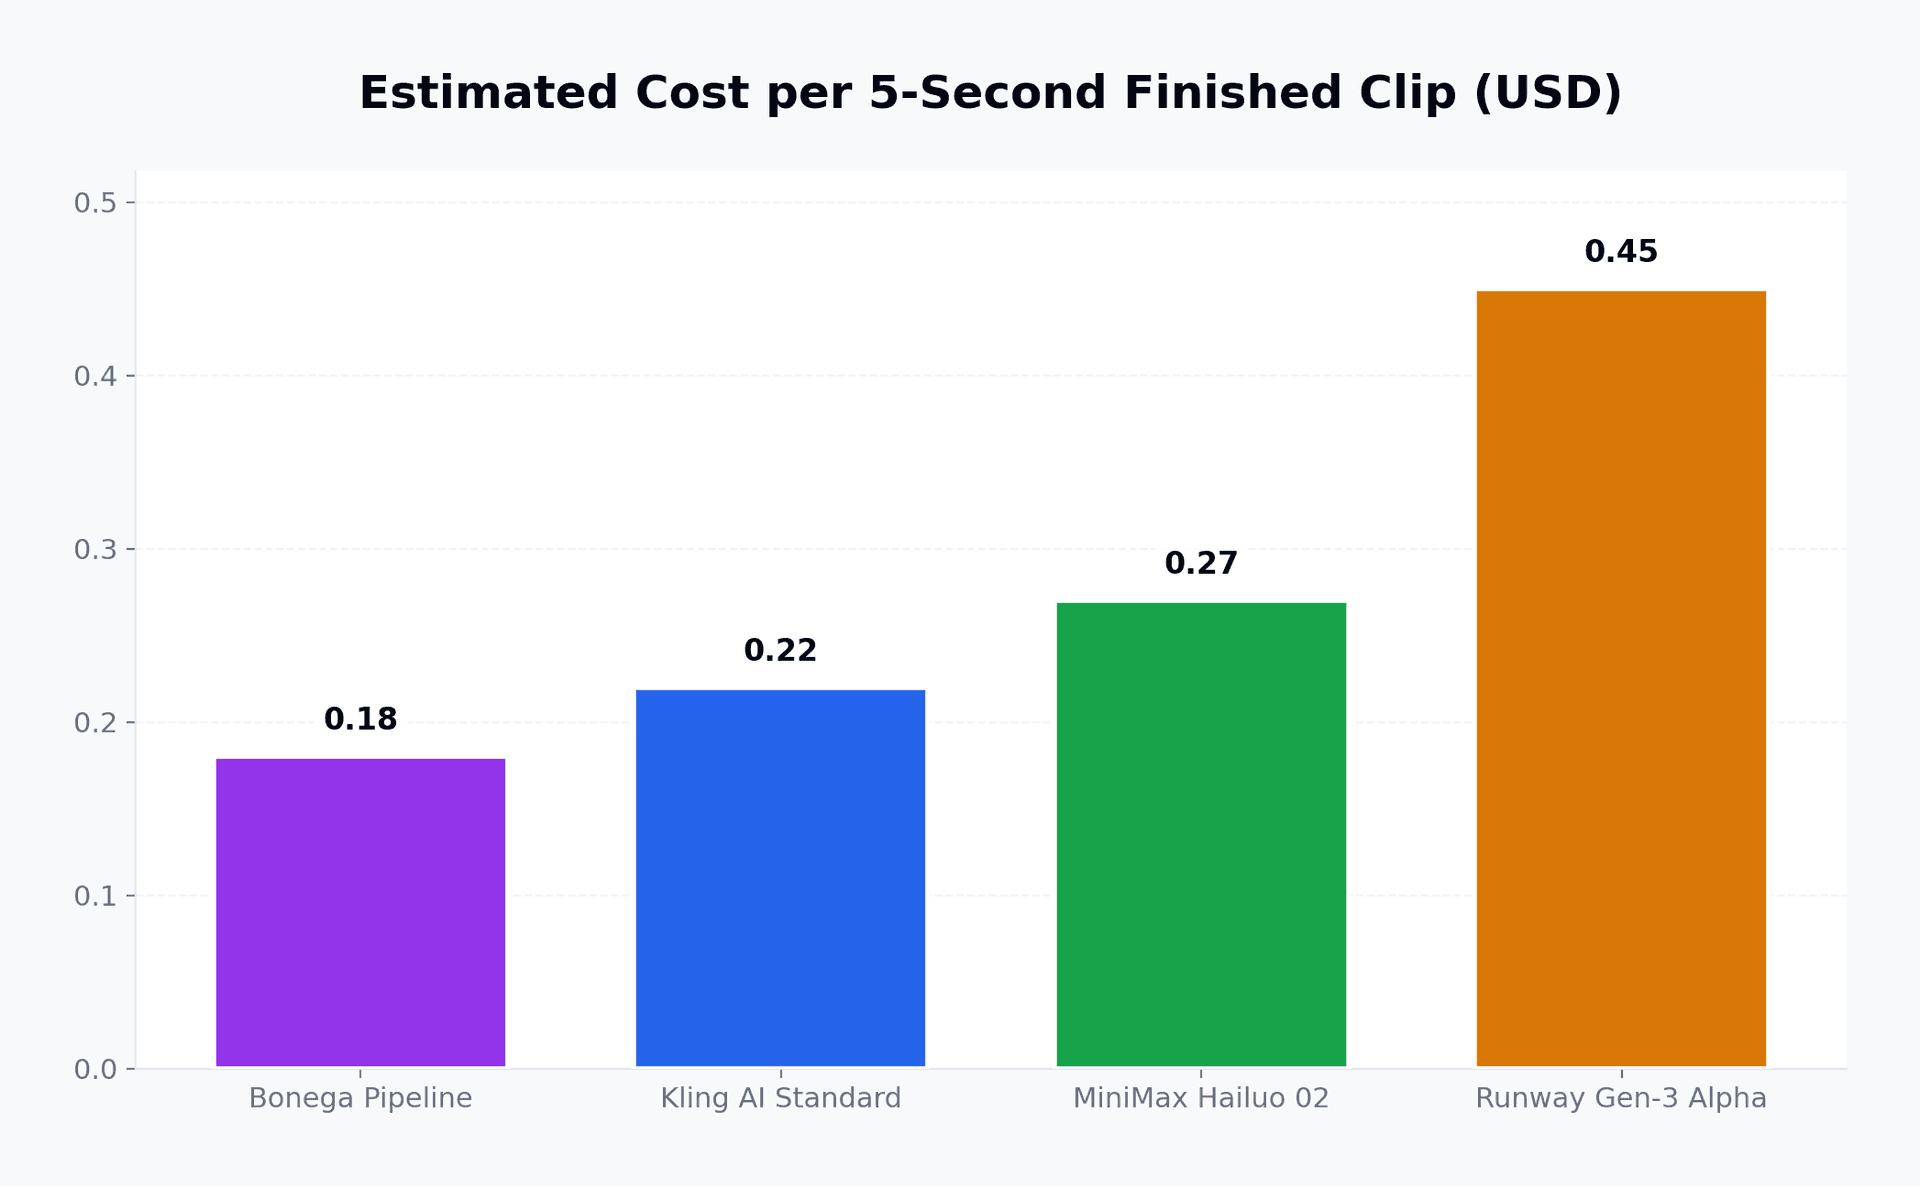
| المنصة | الاشتراك الأساسي | الحصة الشهرية | التكلفة لكل تصيير مدته 5s | حصة الفئة المجانية |
|---|---|---|---|---|
| Bonega Pipeline | $9.00 / شهر | تنسيق كامل لسير العمل | ~$0.18 | تجربة لمدة 3 أيام تتطلب بطاقة |
| Kling AI Standard | $8.80 / شهر | 660 رصيداً | ~$0.22 (10 أرصدة) | 66 رصيداً يومياً (بعلامة مائية) |
| MiniMax Hailuo 02 | $10.00 / شهر | ~55 مقطعاً قياسياً | ~$0.27 (مقطع مدته 6s) | تجارب يومية محدودة |
| Runway Gen-3 Alpha | $15.00 / شهر | 625 رصيداً | ~$0.45 (25 رصيداً) | 125 رصيداً أولياً لمرة واحدة |
تتراوح خطط البداية عبر الخدمات الرائدة مثل منصة فيديو MiniMax بين $8.80 و $15.00 شهرياً. إذا كنت تختبر الأدوات دون الدفع مقدماً، فراجع تفصيلنا لمولدات الفيديو المجانية بالذكاء الاصطناعي لمقارنة شروط العلامة المائية والحصص التجريبية.
إذا كنت تفضل تجنب التنقل بين أدوات الصور ومنصات التحريك المنفصلة، يمكنك إنشاء مشروع الفيديو الخاص بك مع Bonega في تجربة مدتها 3 أيام بقيمة $0 اليوم للجمع تلقائياً بين التوليد الأمثل للصور والتحريك في سير عمل واحد.
ثلاث صيغ لحركة الكاميرا للحصول على نتائج نقية
يمنح توجيه الكاميرا لقطات الذكاء الاصطناعي طابعاً مقصوداً وهادفاً. بدون إشارات واضحة للكاميرا، غالباً ما تعتمد النماذج على تحولات غير طبيعية أو انجراف فوضوي. استخدم هذه الصيغ الثلاث المجربة كمطالبات حركة أساسية.
1. التقريب البطيء للأمام
تخلق هذه الصيغة إحساساً بالألفة وتجذب المشاهد نحو الموضوع دون زعزعة استقرار الخلفية.
Slow forward dolly push-in, 8% scale increase over 5 seconds, subject maintains eye contact, shallow depth of field.2. التحريك الأفقي المنزلق
مثالي لتهيئة البيئات المحيطة، أو المناظر الطبيعية، أو كشف العناصر الثانوية في الغرفة.
Smooth lateral slider pan from left to right at constant velocity, steady camera movement, background parallax with stable horizon line.3. التتبع الديناميكي للشخصية
الأفضل للشخصيات التي تمشي أو تركض أو تعمل في بيئات ديناميكية.
Low-angle tracking shot following subject walking forward, steadycam stability, camera maintains fixed distance of two meters.إذا بدت لقطة مكتملة مدتها خمس ثوانٍ نقية ولكنها تحتاج إلى مسار سردي أطول، فاتبع دليل تمديد فيديو الذكاء الاصطناعي لإلحاق إطارات لاحقة دون كسر الاستمرارية البصرية.
عند كتابة مطالبات لحركات الكاميرا، حدد السرعة والمسافة. كلمات مثل "بطيء" أو "ثابت" أو "تكبير طفيف بنسبة 10%" تمنع المولد من تطبيق تقريبات سريعة ومفاجئة تمزق هندسة الخلفية.
قاعدة القرار: ما هي الأداة المناسبة لاحتياجات إنتاجك؟
يعتمد العثور على أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي على مطابقة مسار عملك مع وتيرة النشر الخاصة بك:
- للمقاطع الاجتماعية اليومية العمودية على TikTok أو Instagram Reels: استخدم مسار عمل متعدد النماذج يجمع بين توليد الإطارات المفتاحية والتحريك في واجهة واحدة.
- عندما تكون هناك حاجة إلى تحكم دقيق بفرشاة الحركة في العناصر البصرية الفردية: اختر Runway Gen-3 Alpha في خطة شهرية قياسية.
- حيث يكون التركيز الأساسي على تعبيرات الوجه البشري الطبيعية والإيماءات الجسدية: اختر Kling AI Standard لالتزامه العالي بالحركة.
راجع عدد المشاهد الشهري المخطط له وتحقق من باقات تسعير Bonega الكاملة قبل الالتزام باشتراكات مستقلة عالية التكلفة.
ما يجب متابعته حتى أواخر عام 2026: تتبع ما إذا كان زمن استجابة تحويل الصورة إلى فيديو سينخفض إلى أقل من 15 ثانية لكل مقطع قياسي. بمجرد أن يكسر زمن التصيير حاجز الـ 15 ثانية، سيحل التمرير التفاعلي اللحظي على المخطط الزمني محل الانتظار غير المتزامن كسير عمل مهيمن للمنشئين. إن إتقان أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي يعتمد على التعامل مع العملية كخط تجميع بدلاً من مجرد عملية تصيير واحدة.
المصادر
- وثائق Runway Creative Suite (Runway AI)
- إمكانيات منصة Kling AI (Kuaishou Technology)
- وثائق توليف الفيديو في MiniMax (MiniMax)
الأسئلة الشائعة
- ما هي أسهل طريقة لإنشاء فيديوهات بالذكاء الاصطناعي دون أخطاء بصرية؟
- يوفر أسلوب الإطار المرجعي النتيجة الأكثر نقاءً. يقوم المنشئون بتوليد إطار مفتاحي أصلي باستخدام محرك رسوميات مخصص لتحديد الإضاءة والتفاصيل، ثم يغذون هذه الصورة المرجعية في أداة تحريك. يساعد تثبيت الهندسة الساكنة أولاً في حل أخطاء التصيير الشائعة.
- لماذا تبدو المطالبات المباشرة لتحويل النص إلى فيديو مشوهة في كثير من الأحيان؟
- يتطلب التوجيه النصي المباشر من الشبكة العصبية حل الهوية والتكوين والحركة الفيزيائية في وقت واحد. تتراكم الأخطاء الحسابية عبر الإطارات، مما يؤدي إلى تغير ملامح الوجه وتحور الأيدي بشكل غير متوقع أثناء حركة الكاميرا.
- كم تبلغ تكلفة إنتاج مقطع فيديو بالذكاء الاصطناعي في عام 2026؟
- تبلغ تكلفة باقات المبتدئين عادةً أقل من $10 شهرياً، بينما ترتفع الباقات المتقدمة عن ذلك. في المتوسط، يكلف توليد مشهد قصير مدته خمس ثوانٍ حوالي عشرين سنتاً من طاقة الحوسبة. توفر المحركات متعددة الخطوات أعلى موثوقية مقابل كل دولار يتم إنفاقه.
- كم يجب أن تكون مدة كل مشهد مولد بالذكاء الاصطناعي؟
- استهدف لقطات قصيرة تتراوح مدتها بين أربع وست ثوانٍ. تعاني التوليدات المستمرة الأطول من تدهور بصري حاد. يؤدي تجميع ثلاثة مقاطع منفصلة مدة كل منها خمس ثوانٍ في برنامج تحرير خارجي إلى تحقيق وتيرة واستمرارية أفضل بكثير.