تشغيل فيديو الذكاء الاصطناعي محلياً: LTX-2 وRTX وComfyUI في عام 2026
تشغيل LTX-2 محلياً باستخدام ComfyUI: بطاقة RTX 4060 (8 GB) كحد أدنى، و24 GB VRAM موصى بها، مع دليل إعداد خطوة بخطوة ومقارنة التكلفة مع الأدوات السحابية.
 Damien10 min read
كاتب ذكاء اصطناعي، فحوصات آلية، المسؤولية للمحرر
النموذج مفتوح المصدر LTX-2، الذي طورته شركة Lightricks بالتعاون مع NVIDIA، يقوم الآن بتوليد ما يصل إلى 20 ثانية من فيديو بدقة 4K بمعدل 50 إطاراً في الثانية على وحدة معالجة رسومات استهلاكية واحدة. بلا سحابة، وبلا اشتراك، ودون أن تغادر أي بيانات جهازك.
في معرض CES 2026، عرضت NVIDIA نموذج LTX-2 يعمل بشكل أصلي على سلسلة RTX 50 الجديدة، وتركت النتائج الحضور في حالة دهشة. لم يكن هذا مجرد عرض بحثي، بل كان توليد فيديو محلياً جاهزاً للإنتاج، ويعمل بسرعات تضاهي الخدمات السحابية.
دعني آخذك في جولة نوضح فيها ما يعنيه هذا، وما تحتاجه، وكيفية إعداده.
لماذا يعد توليد فيديو الذكاء الاصطناعي محلياً أمراً مهماً
قبل الغوص في الإعداد التقني، دعني أشرح لماذا لا يعتبر تشغيل فيديو الذكاء الاصطناعي محلياً مجرد تفضيل للهواة. إنه يحل مشاكل حقيقية.
اشتراكات شهرية ($20-100/شهر)، رفع البيانات إلى خوادم جهات خارجية، الاعتماد على الإنترنت، طوابير انتظار للتوليد خلال ساعات الذروة، خيارات تخصيص محدودة
استثمار في العتاد لمرة واحدة، خصوصية كاملة للبيانات، يعمل دون اتصال بالإنترنت، لا توجد أوقات انتظار، تخصيص كامل للنموذج عبر تدريب LoRA، عدد لا نهائي من التوليدات
بالنسبة للاستوديوهات التي تتعامل مع لقطات العملاء، فإن الخصوصية ليست خياراً ثانوياً. وبالنسبة للمبدعين في المناطق ذات الإنترنت البطيء، يكون التوليد السحابي غير عملي. ولكل من يولد مئات المقاطع شهرياً، تصبح حسابات الاشتراكات غير مجدية بسرعة كبيرة.
ما تحتاجه: متطلبات العتاد
إليك التفصيل الدقيق والصادق. يتطلب التوليد المحلي عتاداً جيداً، ولكنه على الأرجح ليس بالمتطلب الخارق كما قد تظن.
| المكون | الحد الأدنى | الموصى به | الأمثل |
|---|---|---|---|
| بطاقة الرسوميات (GPU) | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| الذاكرة العشوائية (RAM) | 16 GB | 32 GB | 64 GB |
| التخزين | 50 GB SSD مساحة فارغة | 200 GB NVMe | 500 GB NVMe |
| نظام التشغيل | Windows 10/11، Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
مقارنة أداء بطاقات الرسوميات
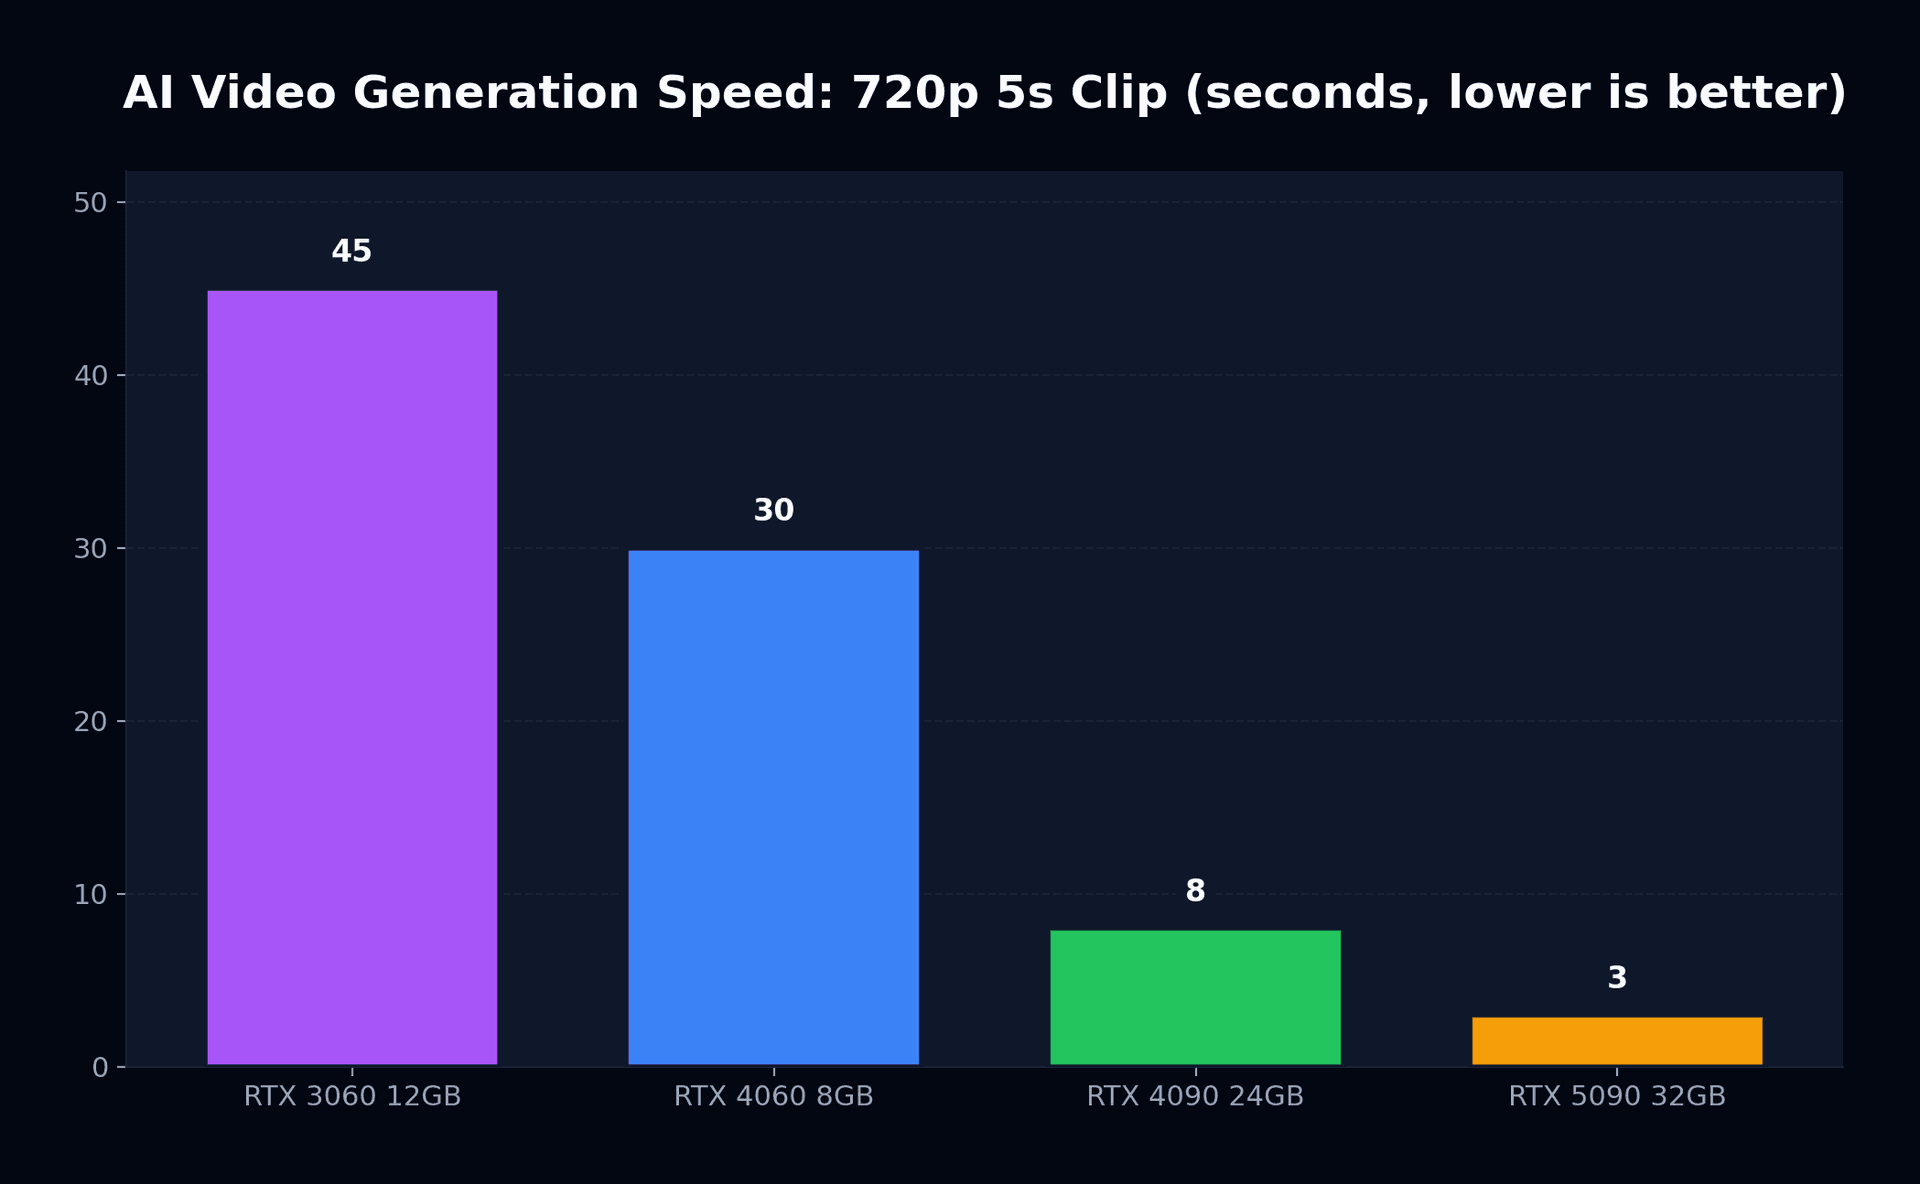
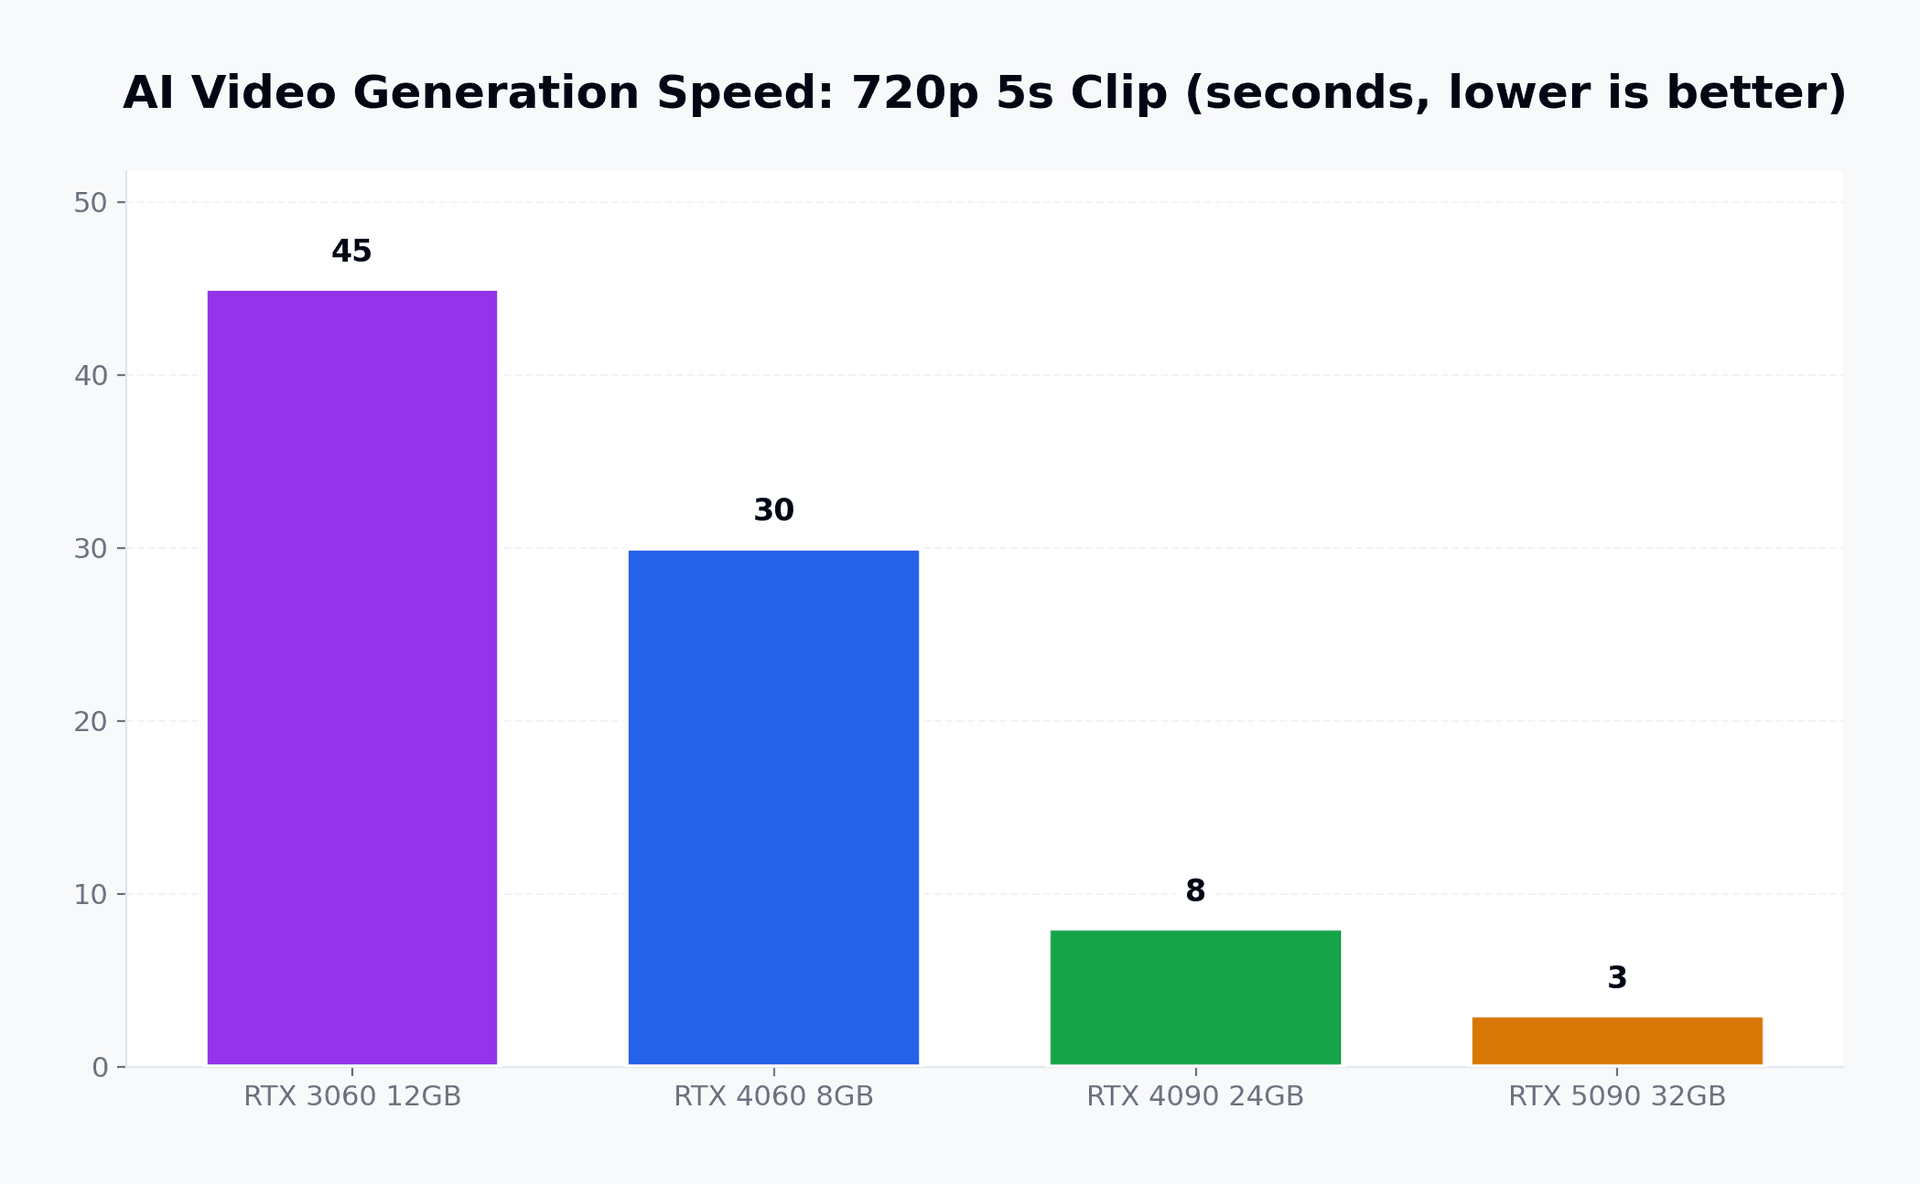
الفجوة في الأداء بين الأجيال مذهلة. إليك ما عرضته NVIDIA في معرض CES 2026:
| بطاقة الرسوميات | 720p (مقطع 5 ثوانٍ) | 1080p (مقطع 5 ثوانٍ) | 4K (مقطع 5 ثوانٍ) | استهلاك VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 ثانية | ~90 ثانية | غير مدعوم | 11 GB |
| RTX 4060 8 GB | ~30 ثانية | ~60 ثانية | غير مدعوم | 7.5 GB |
| RTX 4090 24 GB | ~8 ثوانٍ | ~15 ثانية | ~45 ثانية | 18 GB |
| RTX 5090 32 GB | ~3 ثوانٍ | ~6 ثوانٍ | ~15 ثانية | 20 GB |
تحقق سلسلة RTX 50 تسريعاً بمقدار 3x عبر التكميم الأصلي NVFP4، مما يخفض دقة أوزان النموذج إلى النصف دون فقدان مرئي في الجودة. هذه هي نفس الحيلة التي جعلت نماذج اللغة الكبيرة (LLMs) عملية على العتاد الاستهلاكي، والآن يتم تطبيقها على انتشار الفيديو.
LTX-2: ما الذي يجعله مميزاً
LTX-2 ليس مجرد "نموذج آخر مفتوح المصدر". إنه يمثل تحولاً جوهرياً فيما يمكن تحقيقه على العتاد الاستهلاكي.
حتى 20 ثانية بدقة 4K و50 إطاراً في الثانية
توليد صوتي مدمج
التحكم بالإطارات المفتاحية المتعددة
تخصيص قائم على LoRA
تكامل مع ComfyUI
كيف يقارن بالخدمات السحابية
دعني أكون محدداً بشأن ما يمكن للتوليد المحلي القيام به وما لا يمكنه فعله مقارنة بالمنصات السحابية الكبرى.
| الميزة | LTX-2 (محلي) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| أقصى دقة | 4K | 1080p | 4K | 1080p |
| أقصى مدة | 20 ثانية | 20 ثانية | 8 ثوانٍ | 10 ثوانٍ |
| الصوت | مدمج | منفصل | أصلي | منفصل |
| الخصوصية | كاملة | سحابية | سحابية | سحابية |
| التكلفة الشهرية | $0 | $20-200 | $20-50 | $15-100 |
| التخصيص | كامل (LoRA) | محدود | محدود | متوسط |
| السرعة (1080p، 5 ثوانٍ) | 6-60 ثانية (حسب الـ GPU) | 30-120 ثانية | 15-60 ثانية | 20-90 ثانية |
المفاضلة واضحة: تقدم الخدمات السحابية مخرجات أكثر صقلاً مع إعداد أقل، بينما يمنحك التوليد المحلي التحكم الكامل والخصوصية وانعدام التكلفة الحدية لكل عملية توليد. لإلقاء نظرة أعمق على مقارنة هذه المنصات السحابية، راجع مقارنة Sora 2 مقابل Runway مقابل Veo 3.
إعداد LTX-2 باستخدام ComfyUI: خطوة بخطوة
إليك الدليل العملي. أفترض أنك تمتلك بطاقة رسوميات من NVIDIA تحتوي على 8 GB من VRAM على الأقل مع تثبيت تعريف حديث.
الخطوة 1: تثبيت ComfyUI
ComfyUI هي واجهة مرئية قائمة على العقد لنماذج الانتشار. فكر فيها كنظام Unreal Engine Blueprint، ولكن لسير عمل توليد الذكاء الاصطناعي.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
الخطوة 2: تنزيل نموذج LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
الخطوة 3: تثبيت إضافة LTX-2 الخاصة بـ ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
الخطوة 4: التشغيل والتوليد
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
افتح http://127.0.0.1:8188 في متصفحك. قم بتحميل سير عمل LTX-2 من مجلد الأمثلة الخاص بالإضافة، واكتب موجه الأوامر الخاص بك، ثم اضغط على "Queue Prompt".
تحسين إعداداتك
بعد نجاح الإعداد الأساسي، إليك حيل الضبط الدقيق التي تحدث فرقاً حقيقياً.
إدارة VRAM
أكبر عنق زجاجة وحيد في التوليد المحلي هو ذاكرة VRAM. إليك كيفية الاستفادة القصوى مما لديك:
- ✓تمكين تفريغ النموذج (ينقل الطبقات غير المستخدمة إلى ذاكرة النظام العشوائية RAM)
- ✓استخدام تكميم NVFP8/NVFP4 المناسب لجيل بطاقة الرسوميات لديك
- ✓إغلاق علامات تبويب المتصفح والتطبيقات الأخرى المستهلكة للرسوميات
- ✓ضبط Windows على "جدولة وحدة معالجة الرسوميات ذات الأجهزة المسرعة" في إعدادات العرض
- ✓التفكير في الإقلاع المزدوج لنظام Linux (استفادة أفضل من وحدة معالجة الرسوميات بنسبة 5-10% مقارنة بـ Windows)
سير عمل المعالجة الدُفعية
للمبدعين الذين يحتاجون إلى توليد العديد من المقاطع، يدعم ComfyUI إدراج المهام الدُفعية في قوائم الانتظار. قم بإعداد موجهاتك في ملف JSON، واربطها بعقدة تحميل الدُفعات (batch loader node)، ودع بطاقة الرسوميات تعمل طوال الليل.
تدريب LoRA للأنماط المخصصة
هنا يتألق التوليد المحلي حقاً. يمكنك تدريب مهايئ LoRA على 50-100 إطار من اللقطات المرجعية في غضون 30 دقيقة تقريباً على بطاقة RTX 4090. النتيجة هي ملف خفيف الوزن (عادةً بين 100-300 MB) يوجه النموذج نحو أسلوبك البصري الخاص، أو ملامح شخصيات معينة، أو جماليات بيئية محددة.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
حساب التكلفة
دعني أضع أرقاماً ملموسة لهذا. افترض أنك صانع فيديو مستقل تولد 100 مقطع مدته خمس ثوانٍ شهرياً.
| النهج | التكلفة الشهرية | التكلفة السنوية | الخصوصية |
|---|---|---|---|
| Sora 2 Pro | $100/شهر | $1,200/سنة | سحابية |
| Runway Standard | $76/شهر | $912/سنة | سحابية |
| Veo (Google AI Pro) | $50/شهر | $600/سنة | سحابية |
| LTX-2 + RTX 4090 | ~$15/شهر (كهرباء) | ~$180/سنة | كاملة |
تبلغ تكلفة بطاقة RTX 4090 حوالي $1,600 بالسعر المقترح من الشركة المصنعة، رغم أن أسعار السوق الحالية تحوم حول $2,500-2,800 بسبب توقف الإنتاج. وعند توليد 100 مقطع شهرياً باستخدام الخدمات السحابية، حتى بسعر السوق، فإن بطاقة الرسوميات تعوض قيمتها في غضون 18-24 شهراً، وبعد ذلك تصبح التوليدات بتكلفة استهلاك الكهرباء فقط.
ما هو قادم تالياً
يتسارع مسار توليد فيديو الذكاء الاصطناعي محلياً. وهناك ثلاثة تطورات جديرة بالمتابعة:
إصدار LTX-2.1
منصة NVIDIA Rubin
Meta Mango (مفتوح المصدر محتمل)
خلاصة القول
تعد خدمات فيديو الذكاء الاصطناعي السحابية منتجات ممتازة. فكل من Sora وVeo وRunway تقدم نتائج مبهرة مع حد أدنى من الإعدادات. لكنها تأتي مع مقايضات بدأ العديد من المبدعين يجدونها غير مقبولة: تكاليف دورية متكررة، ومخاوف تتعلق بالخصوصية، واعتماد دائم على الإنترنت، وتخصيص محدود.
إن تشغيل LTX-2 مع ComfyUI على بطاقة NVIDIA RTX ليس حلاً وسطاً، بل هو نموذج عمل مختلف تماماً. نموذج تمتلك فيه مسار الإنتاج بالكامل، من أوزان النموذج إلى المخرج النهائي. يستغرق الإعداد فترة ما بعد الظهيرة، ومنحنى التعلم حقيقي ولكنه قابل للاستيعاب، والنتائج، خاصة بدقة 4K مع أحدث التحسينات، تنافس بالفعل البدائل السحابية.
إذا كانت لديك بطاقة RTX GPU يعلوها الغبار بين جلسات اللعب، فامنحها وظيفة ثانية. قد تفاجئك تماماً بما يمكنها إنجازه.
قراءات ذات صلة: لمزيد من المعلومات حول حركة فيديو الذكاء الاصطناعي مفتوح المصدر، اطلع على ثورة فيديو الذكاء الاصطناعي مفتوح المصدر ومقالنا المتعمق السابق حول توليد 4K الأصلي عبر LTX-2. هل أنت مهتم بالمشهد الأوسع؟ اقرأ ثورة الـ $10 في فيديو الذكاء الاصطناعي: كيف تتحدى الأدوات الاقتصادية العمالقة.