Générer de la vidéo IA en local : LTX-2, RTX et ComfyUI en 2026
Exécutez LTX-2 en local avec ComfyUI : RTX 4060 (8 GB) au minimum, 24 GB de VRAM recommandés, configuration pas à pas et comparaison des coûts avec les outils cloud.
 Damien11 min read
Auteur IA, vérifications automatiques, rédacteur responsable
Le modèle open source LTX-2, développé par Lightricks en collaboration avec NVIDIA, génère désormais jusqu'à 20 secondes de vidéo 4K à 50 FPS sur un seul GPU grand public. Sans cloud. Sans abonnement. Sans qu'aucune donnée ne quitte votre machine.
Au CES 2026, NVIDIA a démontré LTX-2 tournant nativement sur la nouvelle gamme RTX 50 Series, et les résultats ont laissé l'assistance sans voix. Il ne s'agissait pas d'une démo de recherche. C'était une génération vidéo locale prête pour la production, fonctionnant à des vitesses qui rivalisent avec les services cloud.
Voici ce que cela implique concrètement, le matériel requis et la méthode pour tout installer.
Pourquoi la génération vidéo IA en local est essentielle
Avant de plonger dans la configuration technique, précisons pourquoi faire tourner la vidéo IA en local ne relève pas d'une simple lubie de passionné. Cela répond à de vrais problèmes.
Abonnements mensuels ($20-100/mois), données téléversées sur des serveurs tiers, dépendance à Internet, files d'attente aux heures de pointe, options de personnalisation limitées
Investissement matériel unique, confidentialité totale des données, fonctionnement hors ligne, aucune file d'attente, personnalisation complète du modèle par entraînement LoRA, générations illimitées
Pour les studios qui traitent des séquences pour des clients, la confidentialité n'est pas négociable. Pour les créateurs situés dans des zones à faible débit Internet, le cloud s'avère impraticable. Et pour quiconque produit des centaines de clips chaque mois, l'équation financière de l'abonnement devient vite intenable.
Ce dont vous avez besoin : configuration matérielle
Voici un état des lieux réaliste. La génération locale nécessite du matériel solide, mais probablement pas aussi inaccessible qu'on l'imagine.
| Composant | Minimum | Recommandé | Optimal |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Stockage | 50 GB SSD libre | 200 GB NVMe | 500 GB NVMe |
| OS | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Comparatif de performances des GPU
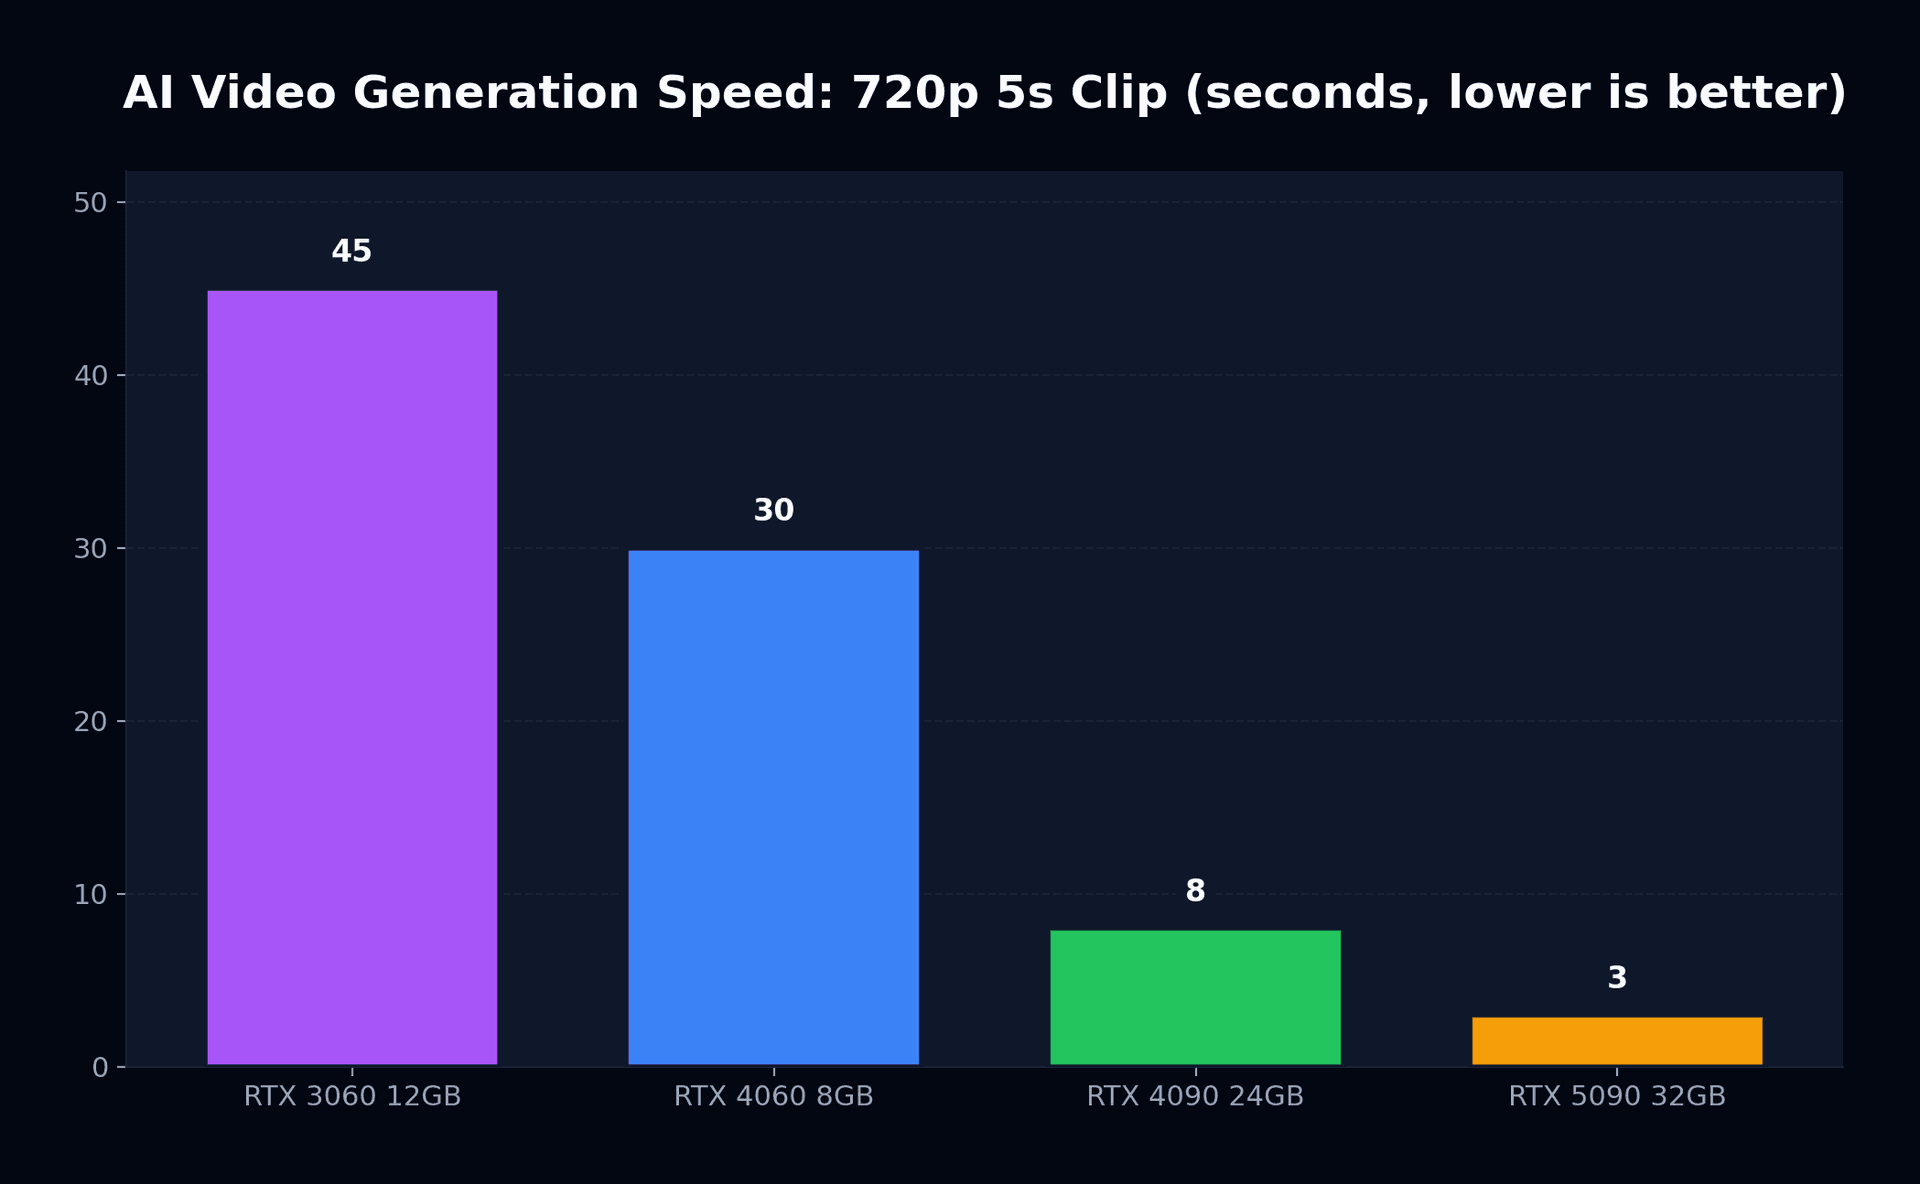
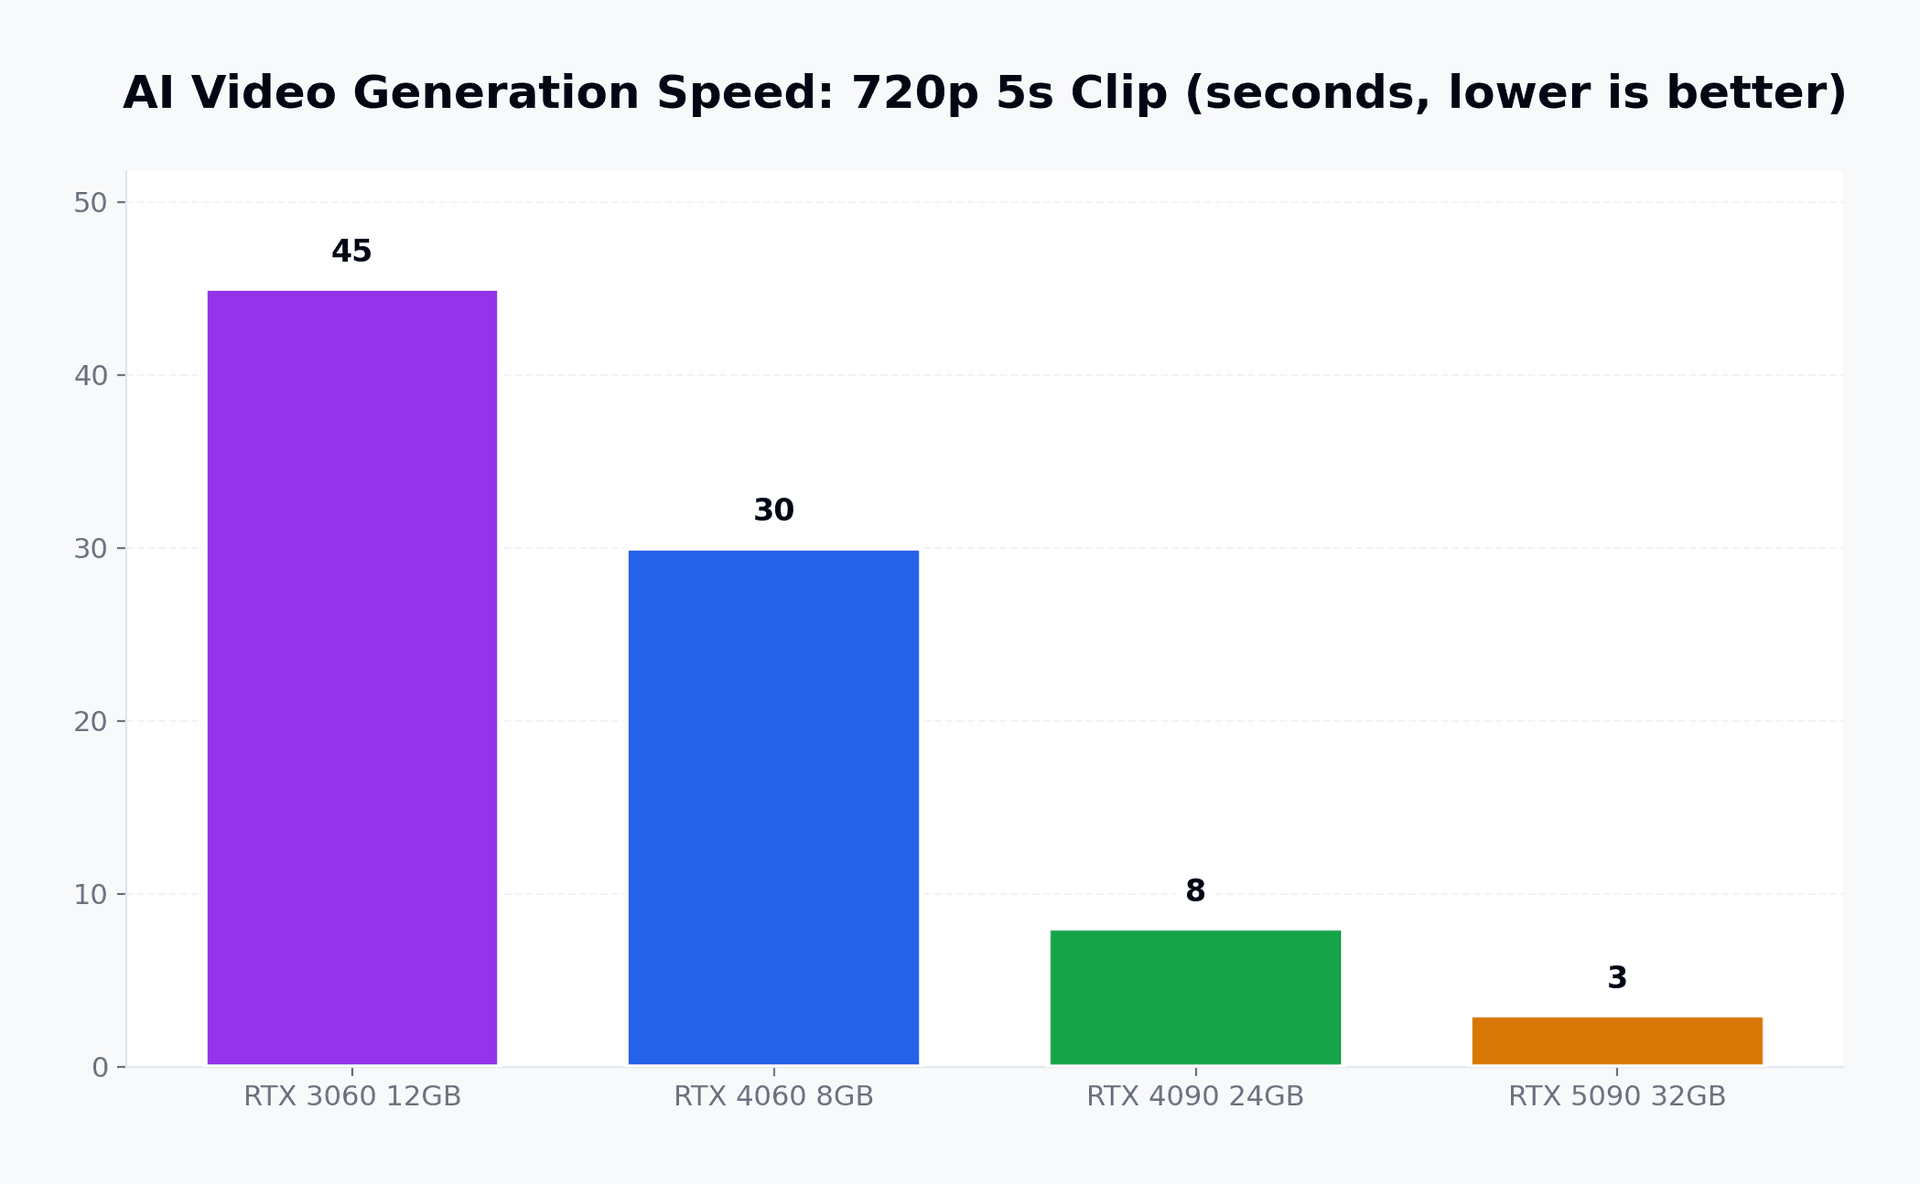
L'écart de performance entre les générations est impressionnant. Voici les chiffres montrés par NVIDIA au CES 2026 :
| GPU | 720p (clip de 5s) | 1080p (clip de 5s) | 4K (clip de 5s) | Consommation VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 secondes | ~90 secondes | Non pris en charge | 11 GB |
| RTX 4060 8 GB | ~30 secondes | ~60 secondes | Non pris en charge | 7.5 GB |
| RTX 4090 24 GB | ~8 secondes | ~15 secondes | ~45 secondes | 18 GB |
| RTX 5090 32 GB | ~3 secondes | ~6 secondes | ~15 secondes | 20 GB |
La gamme RTX 50 Series atteint cette accélération d'un facteur 3 grâce à la quantification native en NVFP4, qui divise par deux la précision des poids du modèle sans perte visible de qualité. C'est le principe qui a rendu les LLM viables sur du matériel grand public, désormais appliqué à la diffusion vidéo.
LTX-2 : ce qui fait sa spécificité
LTX-2 n'est pas juste « un modèle open source de plus ». Il marque un changement fondamental dans ce qu'il est possible de réaliser sur une machine grand public.
Jusqu'à 20 secondes en 4K 50 FPS
Génération audio intégrée
Contrôle par images clés multiples
Personnalisation par LoRA
Intégration ComfyUI
Comparaison avec les services cloud
Voici concrètement ce que la génération locale permet ou ne permet pas face aux grandes plateformes cloud.
| Fonctionnalité | LTX-2 (Local) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Résolution max | 4K | 1080p | 4K | 1080p |
| Durée max | 20 secondes | 20 secondes | 8 secondes | 10 secondes |
| Audio | Intégré | Séparé | Natif | Séparé |
| Confidentialité | Totale | Cloud | Cloud | Cloud |
| Coût mensuel | $0 | $20-200 | $20-50 | $15-100 |
| Personnalisation | Complète (LoRA) | Limitée | Limitée | Modérée |
| Vitesse (1080p, 5s) | 6-60s (selon GPU) | 30-120s | 15-60s | 20-90s |
Le compromis est net : les services cloud offrent un rendu plus soigné avec moins de réglages, tandis que la génération locale apporte le contrôle, la confidentialité et un coût marginal nul par génération. Pour un examen détaillé de ces services cloud, consultez notre comparatif Sora 2 vs Runway vs Veo 3.
Installer LTX-2 avec ComfyUI : étape par étape
Voici le guide pratique. Ce tutoriel part du principe que vous disposez d'un GPU NVIDIA doté d'au moins 8 GB de VRAM avec un pilote récent à jour.
Étape 1 : Installer ComfyUI
ComfyUI est une interface visuelle par nœuds pour les modèles de diffusion. Imaginez le système de Blueprints d'Unreal Engine, appliqué aux flux de génération par IA.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Étape 2 : Télécharger le modèle LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Étape 3 : Installer l'extension LTX-2 pour ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Étape 4 : Lancer et générer
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Ouvrez http://127.0.0.1:8188 dans votre navigateur. Chargez le flux de travail LTX-2 depuis le dossier d'exemples de l'extension, saisissez votre prompt et cliquez sur « Queue Prompt ».
Optimiser votre configuration
Une fois l'installation de base fonctionnelle, voici quelques réglages qui font une vraie différence.
Gestion de la VRAM
Le principal goulot d'étranglement en local reste la mémoire vidéo. Voici comment en tirer le maximum :
- ✓Activer le délestage du modèle (bascule les couches inactives vers la RAM système)
- ✓Utiliser la quantification NVFP8/NVFP4 adaptée à votre génération de GPU
- ✓Fermer les onglets de navigateur et les applications gourmandes en ressources graphiques
- ✓Activer l'option « Planification de processeur graphique à accélération matérielle » dans les paramètres d'affichage de Windows
- ✓Envisager un double démarrage sous Linux (5 à 10% d'efficacité en plus pour le GPU comparé à Windows)
Traitement par lots
Pour les créateurs qui doivent produire beaucoup de séquences, ComfyUI prend en charge la mise en file d'attente par lots. Préparez vos prompts dans un fichier JSON, reliez-les à un nœud de chargement par lots et laissez votre machine travailler la nuit.
Entraînement LoRA pour styles personnalisés
C'est ici que la génération locale prend tout son sens. Il est possible d'entraîner un adaptateur LoRA à partir de 50 à 100 images de référence en environ 30 minutes sur une RTX 4090. Le résultat tient dans un fichier compact (habituellement de 100 à 300 MB) qui guide le modèle vers votre univers visuel, des visages précis ou des ambiances de décor prédéfinies.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Le calcul de rentabilité
Posons des chiffres concrets. Prenons l'exemple d'un créateur vidéo indépendant générant 100 clips de 5 secondes par mois.
| Approche | Coût mensuel | Coût annuel | Confidentialité |
|---|---|---|---|
| Sora 2 Pro | $100/mois | $1,200/an | Cloud |
| Runway Standard | $76/mois | $912/an | Cloud |
| Veo (Google AI Pro) | $50/mois | $600/an | Cloud |
| LTX-2 + RTX 4090 | ~$15/mois (électricité) | ~$180/an | Totale |
Une RTX 4090 a un prix conseillé avoisinant les $1,600, bien que le marché tourne plutôt autour de $2,500-2,800 suite à l'arrêt de sa fabrication. À raison de 100 clips mensuels sur des plateformes payantes, le GPU est amorti en 18 à 24 mois même à ce tarif de marché. Ensuite, chaque génération ne coûte plus que l'électricité consommée.
Les évolutions à venir
La progression de la vidéo IA en local s'accélère. Trois chantiers méritent d'être suivis :
Sortie de LTX-2.1
Plateforme NVIDIA Rubin
Meta Mango (potentiellement open source)
En résumé
Les plateformes cloud de vidéo IA restent d'excellents outils. Sora, Veo ou Runway produisent tous des résultats remarquables avec une mise en route minimale. En contrepartie, ils imposent des contraintes que beaucoup de créateurs jugent désormais pesantes : coûts récurrents, doutes sur la confidentialité, dépendance au réseau et liberté de personnalisation restreinte.
Associer LTX-2, ComfyUI et une carte NVIDIA RTX ne relève pas du compromis. C'est un autre paradigme. Vous y maîtrisez la chaîne de bout en bout, des poids du modèle au rendu final. L'installation demande un après-midi. La prise en main exige un temps d'apprentissage réel mais accessible. Et les résultats, surtout en 4K avec les dernières optimisations, rivalisent directement avec les alternatives cloud.
Si vous avez une carte RTX inutilisée entre deux sessions de jeu, confiez-lui une nouvelle mission. Ses capacités pourraient bien vous surprendre.
Lectures complémentaires : Pour en savoir plus sur l'écosystème open source de la vidéo IA, lisez La révolution de la vidéo IA open source ainsi que notre analyse détaillée sur la génération native 4K avec LTX-2. Vous voulez explorer le paysage global ? Découvrez La révolution à $10 de la vidéo IA : comment les outils abordables bousculent les géants.