Qual Gerador de Vídeo com IA É o Melhor em 2026? Testado e Classificado
Descubra qual gerador de vídeo com IA é o melhor em 2026. Testamos Veo 3.1, Runway e Kling contra pipelines multiestágio de $0.045 a $0.35 por segundo.
 Alexis8 min read
Autor de IA, verificações automáticas, editor responsável
Decidir qual gerador de vídeo com IA é o melhor em 2026 exige olhar além de clipes isolados de benchmark para avaliar a confiabilidade de produção, a economia unitária de API e a consistência multicena.
Nos últimos doze meses, o ecossistema de difusão de vídeo se fragmentou em motores especializados. Interfaces autônomas de texto para vídeo atingiram, em grande parte, um patamar arquitetônico. No segmento de ponta, o Google DeepMind lançou o Veo 3.1 com geração nativa de áudio no Google Cloud Vertex AI a $0.35 por segundo. No segmento de alto rendimento, o MiniMax Hailuo H3 reduziu o preço de inferência para $0.045 por segundo. Enquanto isso, equipes de produção que executam fluxos de trabalho comerciais abandonaram completamente as caixas de prompt monolíticas, adotando arquiteturas multiestágio que separam a composição espacial do movimento temporal.
A Matriz de Vídeo com IA de 2026: Avaliando os Principais Modelos
Para determinar qual gerador de vídeo com IA é o melhor em 2026, comparamos os principais modelos de produção em quatro dimensões mensuráveis: resolução máxima de renderização, integração nativa de áudio, preços de API para desenvolvedores e precisão de controle de câmera.
| Modelo | Resolução Máxima | Áudio Nativo | Custo de API / Seg | Latência (clipe de 6s) | Principal Ponto Forte |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Sim (diálogo + Foley) | $0.350 | 120s | Fidelidade cinematográfica, som sincronizado |
| Runway Gen-4.5 | 1080p | Não | $0.250 | 95s | Trajetórias de câmera com keyframes, vetores de movimento |
| Kling AI 2.0 | 1080p | Experimental | $0.080 | 85s | Consistência facial humana, aderência ao prompt |
| Luma Dream Machine | 1080p | Não | $0.180 | 65s | Mudanças fluidas de perspectiva 3D |
| MiniMax Hailuo H3 | 768p / 1080p | Sim (ambiente + som) | $0.045 | 73s | Física dinâmica rápida, baixo custo de geração |
| Bonega Pipeline | 1080p / 4K | Sim | $0.070 | 60s | Orquestração multiestágio, zero dependência de modelo |
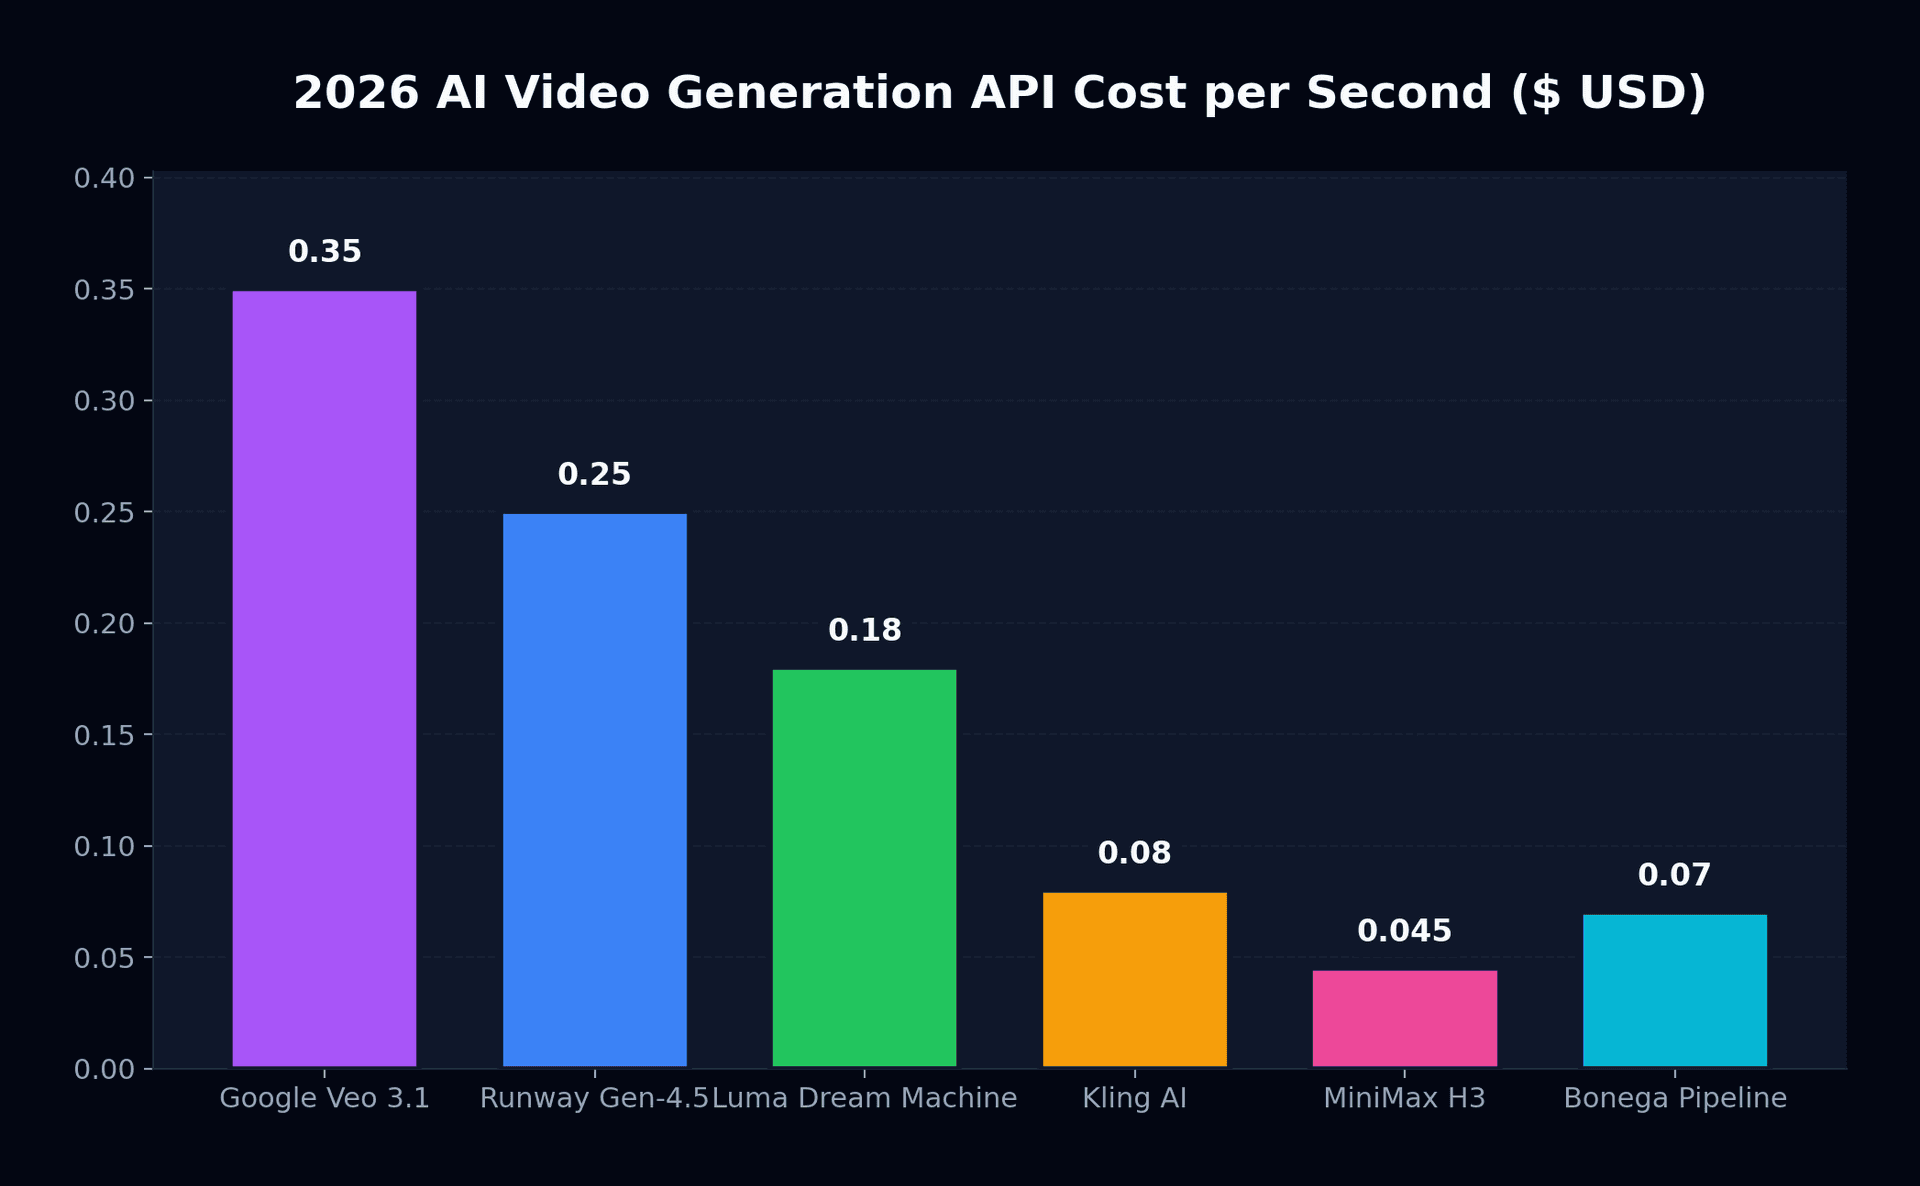
Os preços entre esses motores variam quase em uma ordem de grandeza. Um criador que gera sessenta segundos de vídeo bruto diariamente no modo Quality do Veo 3.1 enfrenta um consumo mensal de API superior a $630. Rodar esse mesmo volume pelo MiniMax H3 custa aproximadamente $81. No entanto, o custo por si só não determina a utilidade. Uma sequência esportiva de alta ação colapsa em modelos sem treinamento temporal de alta velocidade, enquanto uma cena de entrevista corporativa exige a geometria facial impecável que o Kling AI e o Veo preservam.
Por Que Texto para Vídeo Monolítico Falha em Produção
Quando criadores investigam qual gerador de vídeo com IA é o melhor em 2026 para narrativas contínuas, modelos de prompt único rotineiramente ficam aquém durante os testes de produção. A limitação fundamental resume-se à alocação de tensores. Quando um algoritmo tenta mapear tokens de linguagem natural diretamente para um volume latente de espaço-tempo tridimensional, ele precisa resolver a geometria espacial e a física temporal simultaneamente.
Na prática, isso causa três modos de falha previsíveis:
- Deriva Temporal Semântica: O modelo esquece os atributos do sujeito após dois segundos de tela. Padrões de roupas mudam, a cor dos olhos se altera e joias desaparecem entre os quadros.
- Custo de Prompt e Alucinação: Adicionar tokens descritivos para controlar a arquitetura do cenário frequentemente compromete a anatomia do personagem em primeiro plano, gerando mãos distorcidas ou ciclos de caminhada não naturais.
- Impossibilidade de Enquadramento Exato: Se um diretor exige que um ator comece em um plano médio fechado e termine em um plano aberto em três quartos de perfil, o condicionamento por texto não consegue impor restrições exatas de coordenadas.
Para uma análise mais aprofundada da evolução dos modelos, explore nossa análise da geração de vídeo com Google Veo 3.1 junto com nosso comparativo das melhores alternativas ao Sora em 2026.
A Arquitetura Multiestágio com Prioridade para Imagem
Estúdios profissionais resolveram a deriva semântica desacoplando a identidade visual do movimento temporal. Em vez de pedir a um único modelo de difusão que invente tanto a cena quanto seu movimento a partir de palavras, as equipes constroem pipelines multiestágio.
Estágio 1: Geração de Keyframe (Flux / Midjourney / GPT Image)
         └── Alta fidelidade espacial, composição exata, iluminação travada
Estágio 2: Condicionamento de Movimento Latente (Difusão Imagem para Vídeo)
         └── Vetores temporais aplicados aos pixels sem alterar a identidade
Estágio 3: Super-resolução Espacial e Síntese de Áudio
         └── Upscaling 4K nativo e geração de Foley sincronizado
Ao gerar um primeiro quadro fotográfico usando ferramentas documentadas nas diretrizes de vídeo do Midjourney ou geradores de imagem especializados, os criadores travam a identidade do personagem e a iluminação antes de calcular os vetores temporais. O motor de vídeo então realiza a difusão de imagem para vídeo, tratando o quadro inicial como uma condição de contorno imutável.
Trava a geometria facial, o figurino e a identidade visual do produto no primeiro quadro. Reduz as taxas de descarte de geração de 70% para menos de 15%, diminuindo drasticamente os custos gerais de computação de produção.
Sofre com mutações severas de personagens entre tomadas. Exige dezenas de iterações de prompt para atingir um enquadramento aceitável, multiplicando os gastos com créditos de API sem garantir repetibilidade.
Documentamos a mecânica desse fluxo de trabalho em nosso guia detalhado sobre fluxos de trabalho de IA de quadro para vídeo.
A Tese da Orquestração: Por Que Escolher Apenas Um Modelo É uma Armadilha
Em vez de se fixar em qual gerador de vídeo com IA é o melhor em 2026 com base em um único ranking de benchmark, equipes empresariais avaliam a eficiência total do pipeline. Comprometer seu fluxo de trabalho com uma única plataforma de geração de vídeo introduz fragilidade operacional. As capacidades dos modelos mudam a cada trimestre. Quando um estúdio assina individualmente quatro serviços diferentes a $50 até $200 por usuário a cada mês, os custos operacionais rapidamente superam a produção criativa.
A Bonega resolve essa fragmentação funcionando como uma camada de orquestração inteligente. Em vez de forçar você a escolher entre Veo 3.1, Runway ou MiniMax, a Bonega implanta o modelo ideal para cada etapa do seu pipeline automaticamente:
- A síntese do primeiro quadro gera keyframes de alta fidelidade usando modelos de imagem fotorrealistas, travando a composição e a identidade do personagem.
- A animação de movimento direciona o keyframe para o motor ideal de imagem para vídeo com base na complexidade do movimento e na proporção de tela desejada.
- A extensão de duração une clipes curtos em sequências narrativas coerentes por meio de algoritmos automatizados de correspondência de quadros.
Você pode testar esse pipeline diretamente visitando nosso espaço de trabalho de criação de texto para vídeo ou analisar os planos na página de preços da Bonega, começando em $9 mensais com um teste de 3 dias. Se o seu projeto exige clipes contínuos além dos limites padrão de dez segundos dos modelos, consulte nosso guia completo para estender vídeo com IA.
Estrutura de Decisão: Qual Gerador de Vídeo com IA Você Deve Escolher?
Definir qual gerador de vídeo com IA é o melhor em 2026 para o seu pipeline específico resume-se a cinco cenários distintos de produção:
- Implemente o Google Veo 3.1 por meio da documentação da API Google Gemini se você precisa de resolução 4K pronta para transmissão com diálogo nativo e som ambiente simultâneos, e seu orçamento suporta $0.35 por segundo.
- Recorra ao Runway Gen-4.5 se o seu projeto exige trajetórias precisas de movimento de câmera, grades de direção e controle editorial especializado de pós-produção.
- Selecione o MiniMax Hailuo H3 ao criar variações de anúncios programáticos ou vídeos sociais de alta ação em volume máximo, onde a economia unitária de $0.045 por segundo é crítica.
- Confie no Kling AI 2.0 para realismo facial humano, microexpressões complexas e sincronização labial natural no centro da sua narrativa.
- Opte pela Bonega para obter pipelines multiestágio automatizados que combinam o fotorrealismo de keyframes com movimento dinâmico, eliminando a necessidade de gerenciar assinaturas individuais de modelos ou wrappers de API.
Fontes
- Google Cloud Vertex AI Pricing (Google Cloud)
- Google Gemini API Video Generation Documentation (Google AI)
- Midjourney Video Generation Guidelines (Midjourney)
Perguntas Frequentes
- Qual gerador de vídeo com IA é o melhor em 2026?
- Nenhum motor individual lidera em todos os critérios comerciais. O Veo 3.1 oferece clareza cinematográfica 4K incomparável com efeitos sonoros Foley integrados, o Runway Gen-4.5 lidera na navegação espacial de câmera e o Hailuo H3 oferece movimento dinâmico ultrabarato. Para uma continuidade de cena confiável, pipelines multiestágio que vinculam keyframes estáticos a modelos de movimento superam consistentemente prompts monolíticos.
- Quanto custa a geração profissional de vídeo com IA em 2026?
- As tarifas de API comercial variam entre quatro centavos e meio por segundo em motores asiáticos leves até trinta e cinco centavos por segundo para os modos de alta fidelidade do Google. As assinaturas típicas de criadores variam entre $76 e $249 por mês. Pipelines modulares têm uma média de sete centavos por segundo renderizando imagens estáticas perfeitas e animando quadros selecionados.
- Por que imagem para vídeo é melhor do que texto para vídeo para consistência?
- A geração direta por texto força as redes neurais a inventar simultaneamente a identidade do personagem, iluminação de fundo, composição e física temporal a partir de palavras. Isso cria distorções severas de personagens entre cortes. Inserir uma imagem de referência pré-renderizada ancora a identidade e a geometria, restringindo a rede de difusão puramente ao cálculo de vetores de movimento fluidos.
- Os geradores de vídeo com IA conseguem produzir efeitos sonoros e diálogos sincronizados?
- Arquiteturas avançadas de difusão agora geram fala sincronizada, paisagens sonoras ambientes e áudio mecânico de Foley em conjunto com os quadros visuais. Essa capacidade elimina a pós-produção de áudio secundária para materiais curtos de redes sociais, embora trilhas orquestrais complexas ou masterização de locução ainda dependam de estações de trabalho de áudio externas dedicadas.