Локальный запуск ИИ-видео: LTX-2, RTX и ComfyUI в 2026 году
Локальный запуск LTX-2 с ComfyUI: минимум RTX 4060 (8 GB), рекомендуется 24 GB VRAM, пошаговая настройка и сравнение затрат с облачными сервисами.
 Damien9 min read
ИИ-автор, автоматическая проверка, ответственность редактора
Модель с открытым исходным кодом LTX-2, разработанная Lightricks в сотрудничестве с NVIDIA, теперь создает до 20 секунд 4K-видео со скоростью 50 FPS на одном потребительском GPU. Никаких облаков. Никаких подписок. Никаких данных, покидающих ваш компьютер.
На выставке CES 2026 NVIDIA продемонстрировала нативную работу LTX-2 на новой серии RTX 50, и результаты поразили аудиторию. Это была не исследовательская демонстрация. Это была готовая к продакшену локальная генерация видео со скоростью, сопоставимой с облачными сервисами.
Давайте разберем, что это значит, какое оборудование вам понадобится и как все настроить.
Почему локальная генерация ИИ-видео имеет значение
Перед тем как погрузиться в техническую настройку, объясню, почему локальный запуск видеогенераторов: это не просто хобби для энтузиастов. Он решает реальные задачи.
Ежемесячные подписки ($20-100/месяц), загрузка данных на сторонние серверы, зависимость от интернета, очереди генерации в пиковые часы, ограниченные возможности кастомизации
Однократные вложения в оборудование, полная конфиденциальность данных, работа офлайн, никаких очередей, полная кастомизация модели через обучение LoRA, неограниченное число генераций
Для студий, работающих с клиентскими материалами, конфиденциальность обязательна. Для авторов в регионах с медленным интернетом облачная генерация неудобна. А для тех, кто генерирует сотни роликов в месяц, математика подписок очень быстро перестает быть выгодной.
Что вам понадобится: аппаратные требования
Вот честный расклад. Локальная генерация требует приличного оборудования, но, вероятно, не настолько экстремального, как вы думаете.
| Компонент | Минимум | Рекомендуется | Оптимально |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Накопитель | 50 GB свободного места на SSD | 200 GB NVMe | 500 GB NVMe |
| ОС | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Сравнение производительности GPU
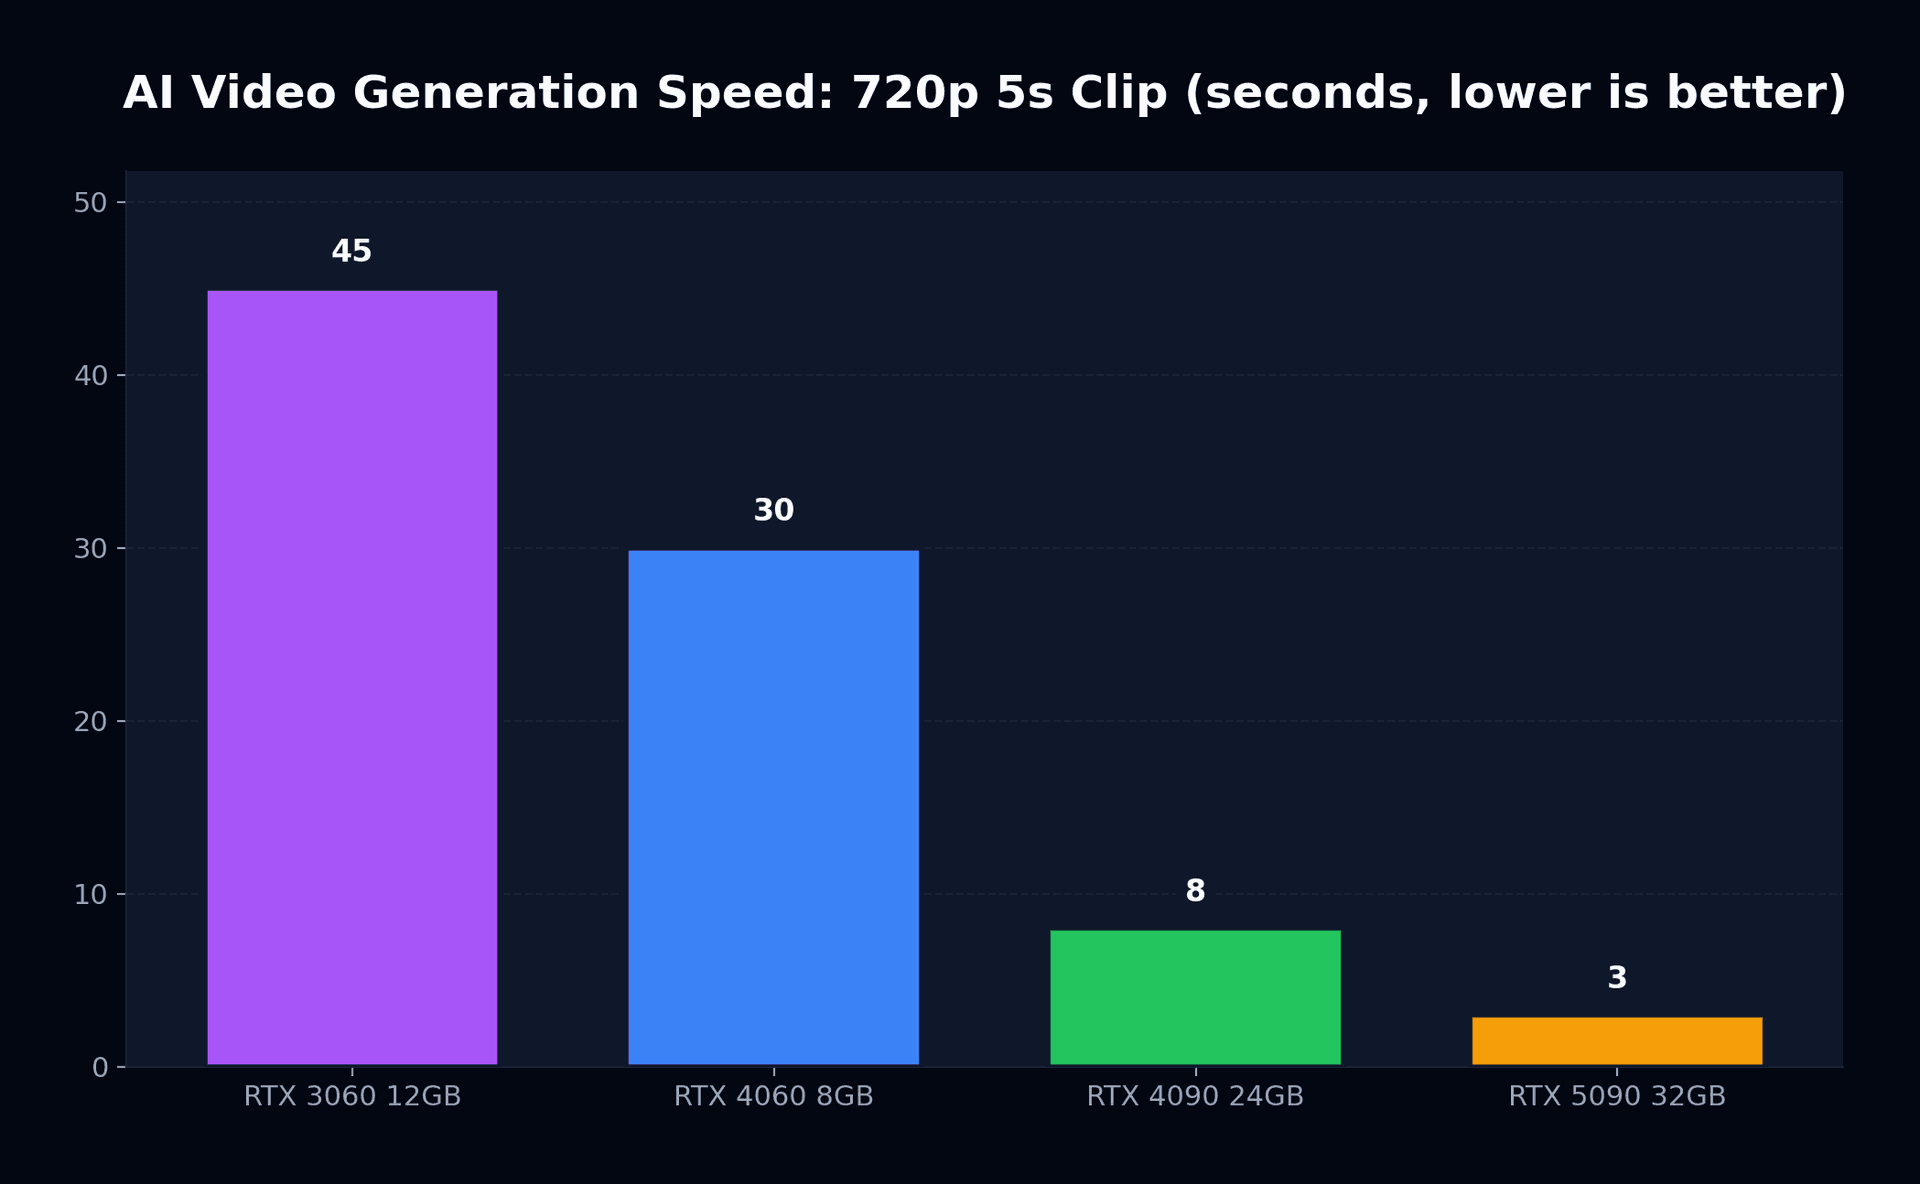
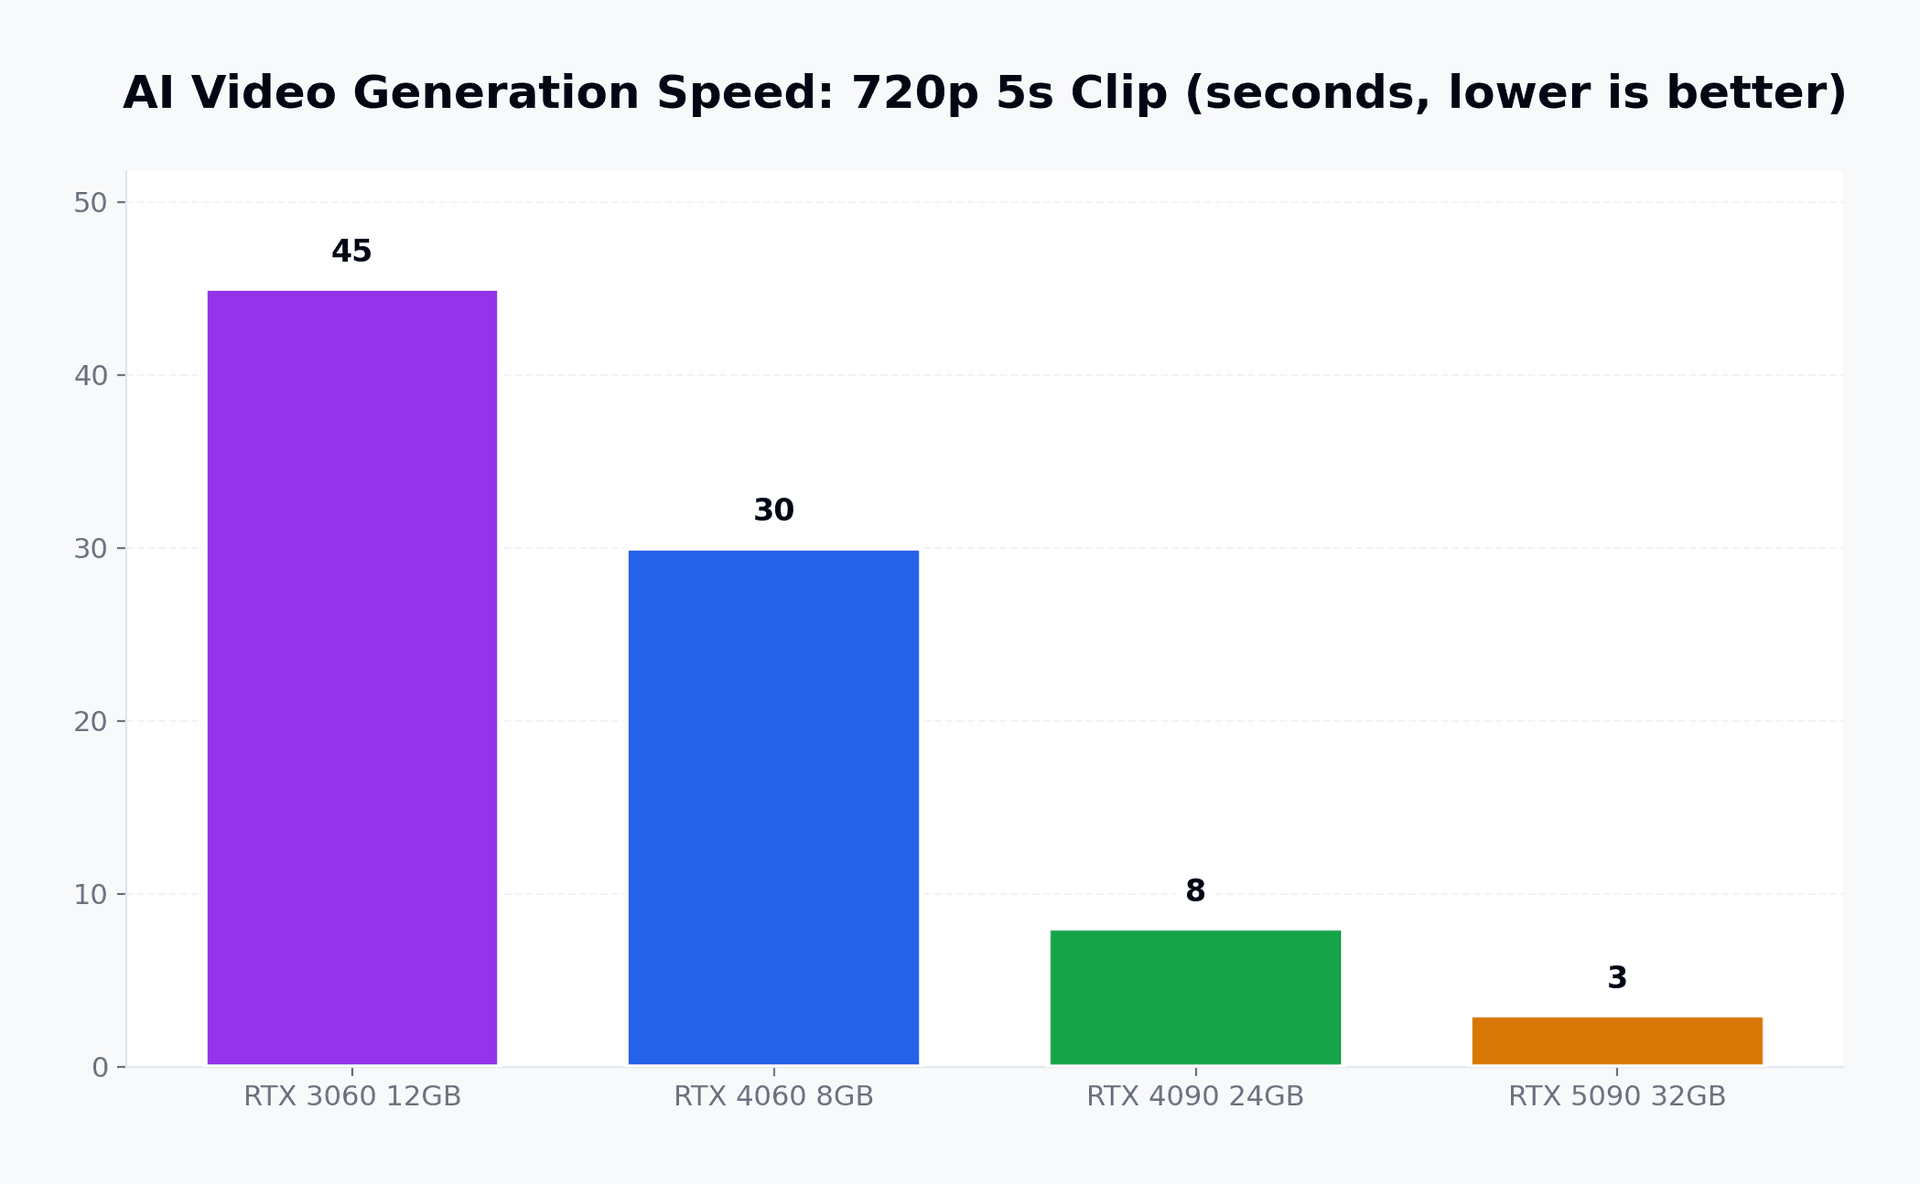
Разрыв в производительности между поколениями огромен. Вот что NVIDIA продемонстрировала на CES 2026:
| GPU | 720p (5 с клип) | 1080p (5 с клип) | 4K (5 с клип) | Расход VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 секунд | ~90 секунд | Не поддерживается | 11 GB |
| RTX 4060 8 GB | ~30 секунд | ~60 секунд | Не поддерживается | 7.5 GB |
| RTX 4090 24 GB | ~8 секунд | ~15 секунд | ~45 секунд | 18 GB |
| RTX 5090 32 GB | ~3 секунды | ~6 секунд | ~15 секунд | 20 GB |
Серия RTX 50 достигает трехкратного ускорения за счет нативной квантизации NVFP4, уменьшая точность весов модели вдвое без видимой потери качества. Это тот же прием, который сделал LLM доступными на потребительском оборудовании, но теперь примененный к диффузии видео.
LTX-2: что делает ее особенной
LTX-2: это не просто «очередная открытая модель». Она представляет собой фундаментальный сдвиг в том, что возможно на потребительском оборудовании.
До 20 секунд в 4K 50 FPS
Встроенная генерация звука
Управление по нескольким ключевым кадрам
Кастомизация через LoRA
Интеграция с ComfyUI
Сравнение с облачными сервисами
Давайте четко разберем, что локальная генерация может и чего не может по сравнению с крупными облачными платформами.
| Функция | LTX-2 (локально) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Макс. разрешение | 4K | 1080p | 4K | 1080p |
| Макс. длительность | 20 секунд | 20 секунд | 8 секунд | 10 секунд |
| Звук | Встроенный | Отдельный | Нативный | Отдельный |
| Конфиденциальность | Полная | Облако | Облако | Облако |
| Ежемесячная стоимость | $0 | $20-200 | $20-50 | $15-100 |
| Кастомизация | Полная (LoRA) | Ограниченная | Ограниченная | Умеренная |
| Скорость (1080p, 5 с) | 6-60 с (зависит от GPU) | 30-120 с | 15-60 с | 20-90 с |
Компромисс очевиден: облачные сервисы предлагают более отполированный результат с меньшими усилиями по настройке, тогда как локальная генерация обеспечивает контроль, конфиденциальность и нулевую предельную стоимость каждой генерации. Подробнее о сравнении этих платформ читайте в нашем сравнении Sora 2, Runway и Veo 3.
Настройка LTX-2 с ComfyUI: шаг за шагом
Вот практическое руководство. Предполагается, что у вас есть видеокарта NVIDIA минимум с 8 GB VRAM и установлены свежие драйверы.
Шаг 1: Установка ComfyUI
ComfyUI: это визуальный нодовый интерфейс для диффузионных моделей. Представьте его как систему Blueprint в Unreal Engine, но для рабочих процессов генерации ИИ.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Шаг 2: Загрузка модели LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Шаг 3: Установка расширения LTX-2 для ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Шаг 4: Запуск и генерация
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Откройте http://127.0.0.1:8188 в браузере. Загрузите рабочий процесс LTX-2 из папки с примерами расширения, введите текстовый запрос и нажмите «Queue Prompt».
Оптимизация вашей системы
После того как базовая конфигурация заработает, вот приемы тонкой настройки, дающие ощутимый эффект.
Управление VRAM
Главное узкое место для локальной генерации: объем VRAM. Вот как выжать максимум из имеющейся памяти:
- ✓Включите выгрузку модели (offloading перемещает неиспользуемые слои в системную RAM)
- ✓Используйте квантизацию NVFP8/NVFP4, подходящую для вашего поколения GPU
- ✓Закройте вкладки браузера и другие приложения, активно использующие GPU
- ✓Включите «Планирование GPU с аппаратным ускорением» в настройках дисплея Windows
- ✓Рассмотрите установку Linux второй системой (на 5-10% лучше утилизация GPU по сравнению с Windows)
Рабочий процесс пакетной обработки
Для авторов, которым требуется создавать много роликов, ComfyUI поддерживает пакетную очередь. Настройте список промптов в JSON-файле, подключите их к ноде batch loader и оставьте GPU работать на ночь.
Обучение LoRA для собственных стилей
Здесь локальная генерация раскрывается в полную силу. Вы можете обучить адаптер LoRA на 50-100 кадрах исходного видео примерно за 30 минут на RTX 4090. В результате получается компактный файл (обычно 100-300 MB), который ориентирует модель на ваш конкретный визуальный стиль, внешность персонажей или эстетику окружения.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Расчет затрат
Давайте обратимся к конкретным цифрам. Предположим, вы независимый видеомейкер, создающий 100 пятисекундных роликов в месяц.
| Подход | Стоимость в месяц | Стоимость в год | Конфиденциальность |
|---|---|---|---|
| Sora 2 Pro | $100/месяц | $1,200/год | Облако |
| Runway Standard | $76/месяц | $912/год | Облако |
| Veo (Google AI Pro) | $50/месяц | $600/год | Облако |
| LTX-2 + RTX 4090 | ~$15/месяц (электричество) | ~$180/год | Полная |
Рекомендованная цена RTX 4090 составляет около $1,600, хотя реальные рыночные цены держатся около $2,500-2,800 из-за прекращения производства. При создании 100 клипов в месяц через облачные сервисы даже по рыночной цене видеокарта окупается за 18-24 месяца, после чего вы генерируете по цене электричества.
Что будет дальше
Развитие локальной генерации ИИ-видео ускоряется. Вот три события, за которыми стоит следить:
Релиз LTX-2.1
Платформа NVIDIA Rubin
Meta Mango (потенциальный Open Source)
Итог
Облачные сервисы ИИ-видео: отличные продукты. Sora, Veo, Runway: все они показывают впечатляющие результаты с минимальной подготовкой. Но они сопровождаются компромиссами, которые многие создатели контента находят неприемлемыми: постоянные расходы, вопросы приватности, зависимость от интернета и ограниченная кастомизация.
LTX-2 с ComfyUI на видеокарте NVIDIA RTX: это не компромисс. Это совершенно другая парадигма. Парадигма, в которой вы владеете всем пайплайном: от весов модели до финального ролика. Настройка занимает пару часов. Кривая обучения присутствует, но вполне преодолима. А результаты, особенно в 4K с актуальными оптимизациями, на равных конкурируют с облачными альтернативами.
Если ваша видеокарта RTX простаивает между игровыми сессиями, дайте ей вторую работу. Вы можете сильно удивиться тому, на что она способна.
Полезные материалы: Подробнее о движении открытого ИИ-видео читайте в статьях Революция ИИ-видео с открытым исходным кодом и нашем предыдущем подробном разборе нативной генерации в 4K на LTX-2. Интересует более широкий контекст рынка? Читайте Революция ИИ-видео за $10: как бюджетные инструменты бросают вызов гигантам.