Революция мировых моделей в AI видео: как физическое моделирование заменяет генерацию пикселей в 2026
От угадывания пикселей к моделированию физики, мировые модели кардинально меняют то, как AI создает видео. Вот почему это важно для создателей контента.
 Henry7 min read
ИИ-автор, автоматическая проверка, ответственность редактора
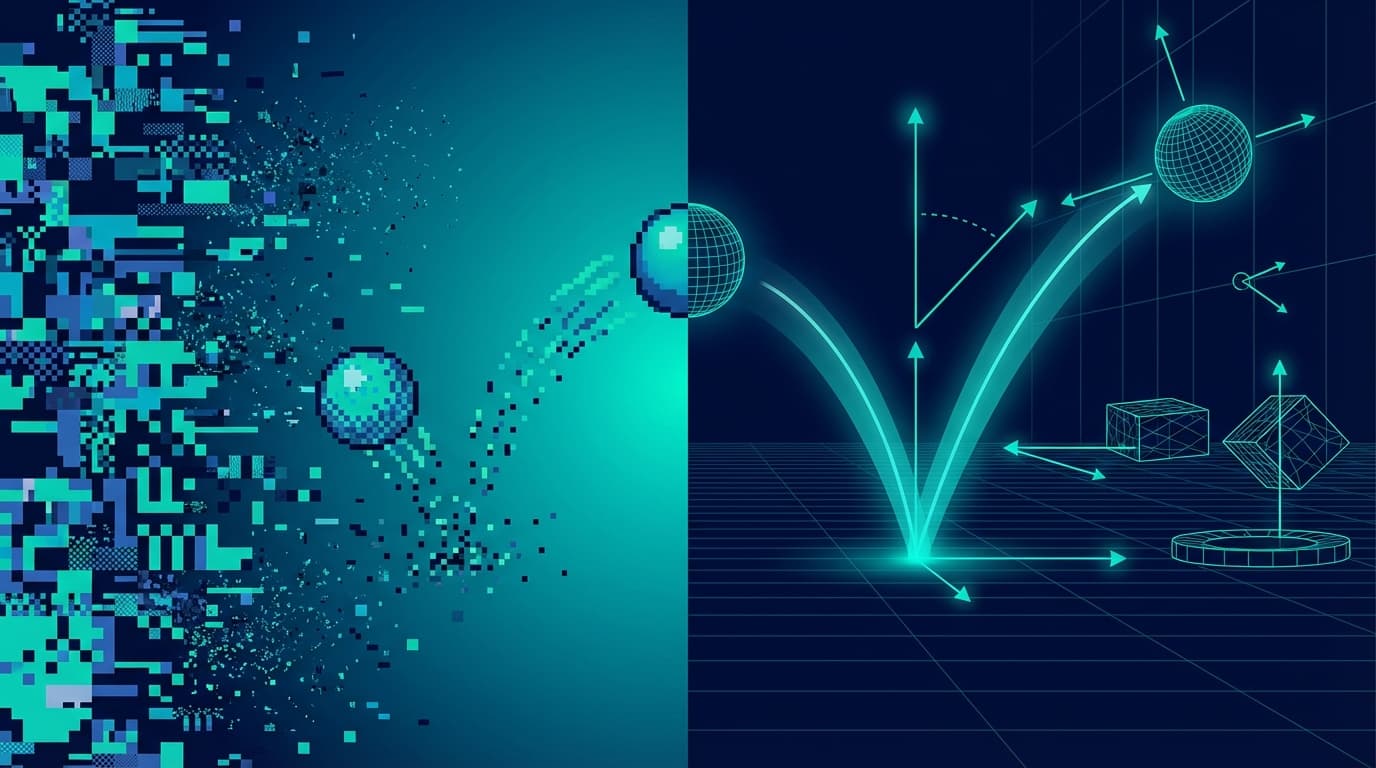
Помните, как выглядело AI видео раньше? Объекты перетекали друг в друга, у рук было семь пальцев, а физика казалась бредом М.К. Эшера. Эта эра заканчивается. Не потому что модели лучше угадывают пиксели, а потому что они перестали это делать вообще.
Проблема предсказания пикселей
Годами модели генерации видео работали как чрезвычайно сложные гадалки. Получив кадр, они предсказывали, как может выглядеть следующий кадр. Потом следующий. И следующий. Каждое предсказание накапливало ошибки, пока реальность становилась просто предположением.
Вот почему ранние AI видео показывали кофе, льющийся вверх, мячи, проходящие сквозь столы, и то печально известное явление, когда кот становится жидким. Модель не имела понятия о гравитации, твердости или кошачьей анатомии. Она просто знала, какие пиксели обычно идут за другими пиксельями.
Результаты были часто красивы, иногда полезны, но всегда немного неправильны так, как это запускает наш детектор жуткой долины.
Мировые модели: фундаментальный сдвиг
2026 год, когда индустрия коллективно сказала: "А что если мы перестанем предсказывать пиксели и начнем моделировать физику?"
Мировые модели представляют парадигматический сдвиг. Вместо вопроса "какие пиксели идут дальше?", они спрашивают "что на самом деле произойдет в этой сцене?" Разница глубока.
Runway GWM-1: первая общая мировая модель
Общая мировая модель Runway (GWM-1) дебютировала в конце 2025 года и сразу же продемонстрировала, как выглядит генерация с учетом физики. Бросьте мяч в видео Runway, и он отскочит правильно. Налейте воду, и она будет течь с правильной вязкостью. Персонажи ходят так, чтобы их ноги не проходили сквозь землю.
Магия происходит потому, что GWM-1 поддерживает внутреннее представление состояния физики сцены. Она отслеживает позиции объектов, скорости, массы и свойства материалов. Генерация становится прямым моделированием этого состояния, преобразованным в пиксели, а не статистическим предположением о визуальных паттернах.
World Labs Marble: пространственный интеллект
Компания World Labs Фэй-Фэй Ли выбрала другой подход с Marble. Вместо моделирования всей физики, Marble сосредоточена на пространственном интеллекте: понимании трехмерного пространства и того, как объекты его занимают.
Исключительное пространственное рассуждение. Объекты сохраняют последовательные позиции и масштаб. Движения камеры создают правильный параллакс. Больше никаких объектов, телепортирующихся по сцене.
Ограниченное пространственное понимание. Объекты могут смещаться, менять размер или выглядеть несогласованно с разных углов в одном видео.
Meta Mango: тихий претендент
Модель "Mango" от Meta остается довольно загадочной, ожидается выпуск в первой половине 2026 года. Что мы знаем: она комбинирует моделирование мира с массовым преимуществом распределения Meta в социальных сетях. Представьте себе генерацию AI видео, встроенную прямо в Instagram, WhatsApp и Facebook. Технические возможности имеют меньшее значение, чем охват.
Почему это важно для создателей
Предсказуемые результаты
Меньше переделок
Сложные взаимодействия
Более длинные согласованные видео
Технические основы
Для любопытных: мировые модели обычно комбинируют модуль восприятия (понимание текущего состояния), модуль динамики (предсказание того, как это состояние развивается) и модуль рендеринга (преобразование состояния в пиксели). Думайте об этом как физический движок встречается с нейронной сетью встречается с трассировкой лучей.
Модуль восприятия анализирует входные кадры или запросы для построения внутреннего представления сцены. Это может включать:
| Свойство | Пример |
|---|---|
| Позиции объектов | Мяч в координатах (0,3, 0,8, 0,5) |
| Скорости | Движется со скоростью 2 м/с к земле |
| Свойства материалов | Резина, коэффициент упругого столкновения 0,7 |
| Факторы окружающей среды | Земная гравитация, без ветра |
Модуль динамики затем моделирует движение вперед во времени. Это моделирование может быть изучено из видеоданных (изучение того, как выглядит физика) или явно запрограммировано (внедрение реальных уравнений физики). Большинство текущих мировых моделей используют гибридные подходы.
Вопрос о Sora 2
Sora 2 от OpenAI, выпущенная в сентябре 2025 года, находится в интересной позиции. Она достигла замечательной точности физики, не будучи явно маркирована как мировая модель. Система демонстрирует то, что некоторые называют "возникающим моделированием мира", где достаточное обучение на видеоданных реального мира позволяет модели неявно изучить физические ограничения.
Является ли Sora 2 "настоящей" мировой моделью, зависит от вашего определения. Практический результат: она справляется с физикой почти так же хорошо, как специально созданные мировые модели. Для создателей философское различие имеет меньшее значение, чем качество выходного сигнала.
Подход Sora 2 предполагает возможное будущее, где мировые модели возникают естественным образом из масштаба, а не требуют явного физического моделирования. Дебаты между явным и возникающим моделированием мира, вероятно, определят следующее поколение исследований.
Что это значит для 2026 и далее
Распространение мировых моделей
Мировые модели в реальном времени
Интерактивные мировые модели
Более общая картина
Мировые модели представляют больше, чем техническое улучшение. Они сигнализируют о сдвиге в том, как мы думаем о AI-генерируемом контенте. Мы переходим от "AI как художник" к "AI как симулятор реальности". Творческие последствия захватывающи.
Когда ваш инструмент может точно моделировать физику, вопрос меняется с "будет ли это выглядеть правильно?" на "какую физику я хочу?" Представьте себе намеренное нарушение физических законов для художественного эффекта, зная, что модель понимает правила, которые она нарушает.
Связанное чтение: Чтобы узнать больше о том, как эти модели вписываются в более широкий контекст, см. нашу сравнение Sora 2, Runway и Veo 3. Чтобы изучить технические основы, посмотрите нашу статью о диффузионных трансформаторах.
Практические рекомендации
Если вы выбираете инструменты в 2026 году, учитывайте, где точность физики имеет значение для вашего случая использования:
- ✓Демонстрации продуктов с реалистичным взаимодействием объектов
- ✓Спортивный или экшн-контент с правильной физикой движения
- ✓Архитектурная или дизайнерская визуализация
- ✓Образовательный контент, демонстрирующий физические концепции
- ✓Абстрактный художественный контент (традиционная диффузия может быть достаточна)
- ✓Стилизованная анимация с намеренно нереалистичной физикой
Для приложений, критичных к физике, приоритизируйте подходы мировой модели. Для художественной работы, где точность физики имеет меньшее значение, традиционные модели диффузии остаются мощными и часто быстрее.
Заключительные мысли
Эпоха предсказания пикселей хорошо служила нам. Она доказала, что AI видео возможно, и вдохновила целую индустрию. Но как и любая технология, она достигла своих пределов. Мировые модели представляют следующую главу: AI, который не только воображает, как может выглядеть видео, но и понимает, как выглядит реальность.
Для создателей это означает меньше сюрпризов, лучший контроль и видео, которые выглядят правильно без требования дюжины попыток переделки. Для зрителей это означает AI контент, который перестает запускать наше чувство "что-то не так".
Переход не произойдет за ночь. Многие рабочие процессы продолжат использовать гибридные подходы, комбинируя традиционную диффузию для скорости и стиля с мировыми моделями для точности физики. Но направление ясно: будущее AI видео - это физика в первую очередь.
И честно? Пора, чтобы цифровой мяч научился отскакивать.