Kör AI-video lokalt: LTX-2, RTX och ComfyUI under 2026
Kör LTX-2 lokalt med ComfyUI: RTX 4060 (8 GB) som minimum, 24 GB VRAM rekommenderas, stegvis installation och hur kostnaden står sig mot molnverktyg.
 Damien9 min read
AI-författare, automatiserade kontroller, ansvarig redaktör
Modellen med öppen källkod LTX-2, utvecklad av Lightricks i samarbete med NVIDIA, genererar nu upp till 20 sekunders 4K-video i 50 FPS på ett enda konsumentgrafikkort. Inget moln. Ingen prenumeration. Ingen data som lämnar din dator.
På CES 2026 visade NVIDIA hur LTX-2 körs nativt på den nya RTX 50-serien, och resultaten gjorde publiken mållös. Detta var ingen forskningsdemo. Det var produktionsredo lokal videogenerering som körs i hastigheter som kan mäta sig med molntjänster.
Låt mig gå igenom vad detta innebär, vad du behöver och hur du installerar det.
Varför lokal AI-videogenerering spelar roll
Innan vi går in på den tekniska installationen vill jag förklara varför lokal körning av AI-video inte bara handlar om personliga preferenser hos entusiaster. Det löser verkliga problem.
Månatliga prenumerationer ($20-100/månad), data laddas upp till servrar hos tredje part, internetberoende, genereringsköer under belastningstoppar, begränsade anpassningsmöjligheter
Engångsinvestering i hårdvara, fullständig datasekretess, fungerar offline, inga kötider, full modellanpassning med LoRA-träning, obegränsat antal genereringar
För produktionsbolag som hanterar klientmaterial är sekretess inte valfritt. För kreatörer i regioner med långsamt internet är molngenerering opraktiskt. Och för alla som genererar hundratals klipp per månad slutar prenumerationskalkylen mycket snabbt att gå ihop.
Vad du behöver: Hårdvarukrav
Här är den ärliga sammanställningen. Lokal generering kräver hyfsad hårdvara, men den är förmodligen inte så extrem som du tror.
| Komponent | Minimum | Rekommenderat | Optimalt |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Lagring | 50 GB ledig SSD | 200 GB NVMe | 500 GB NVMe |
| Operativsystem | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Prestandajämförelse mellan grafikkort
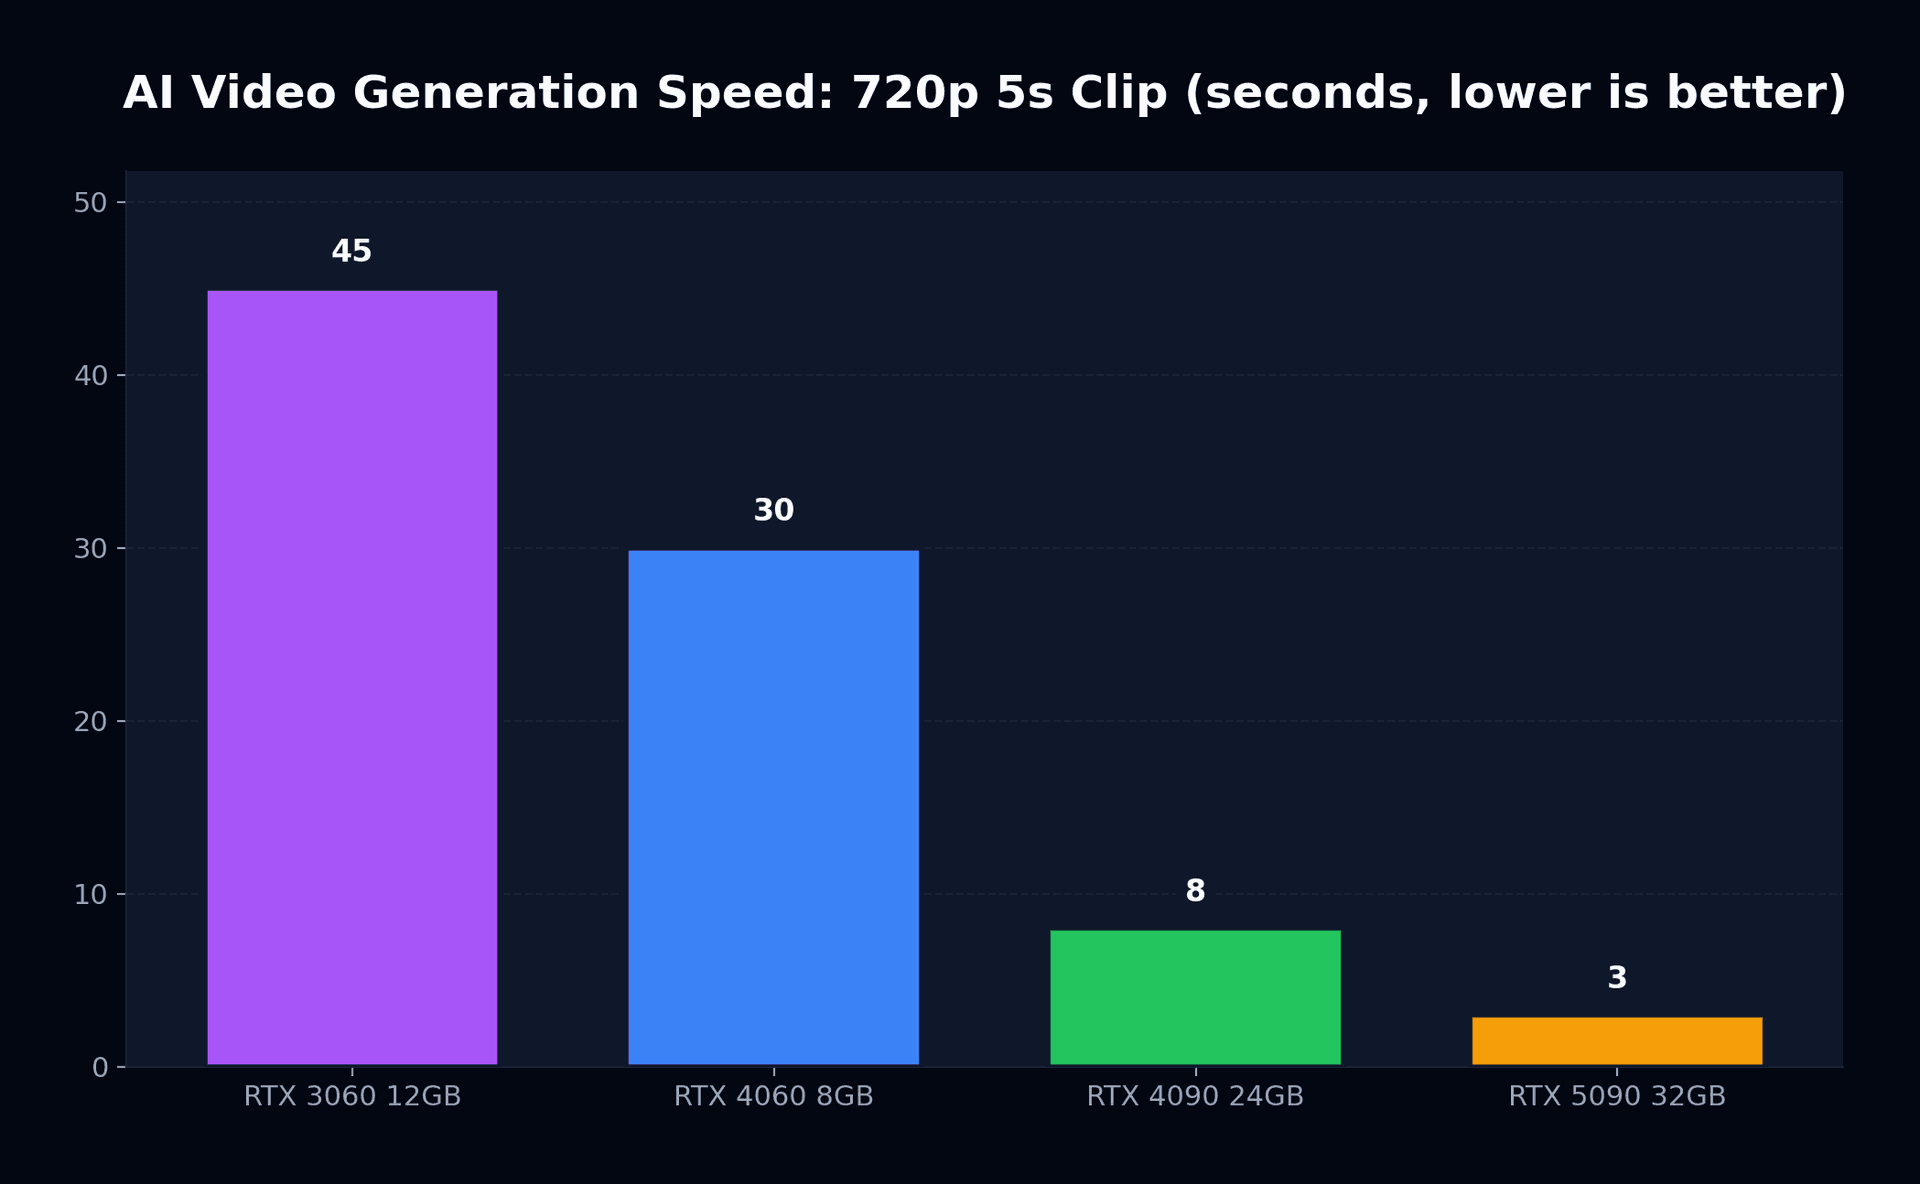
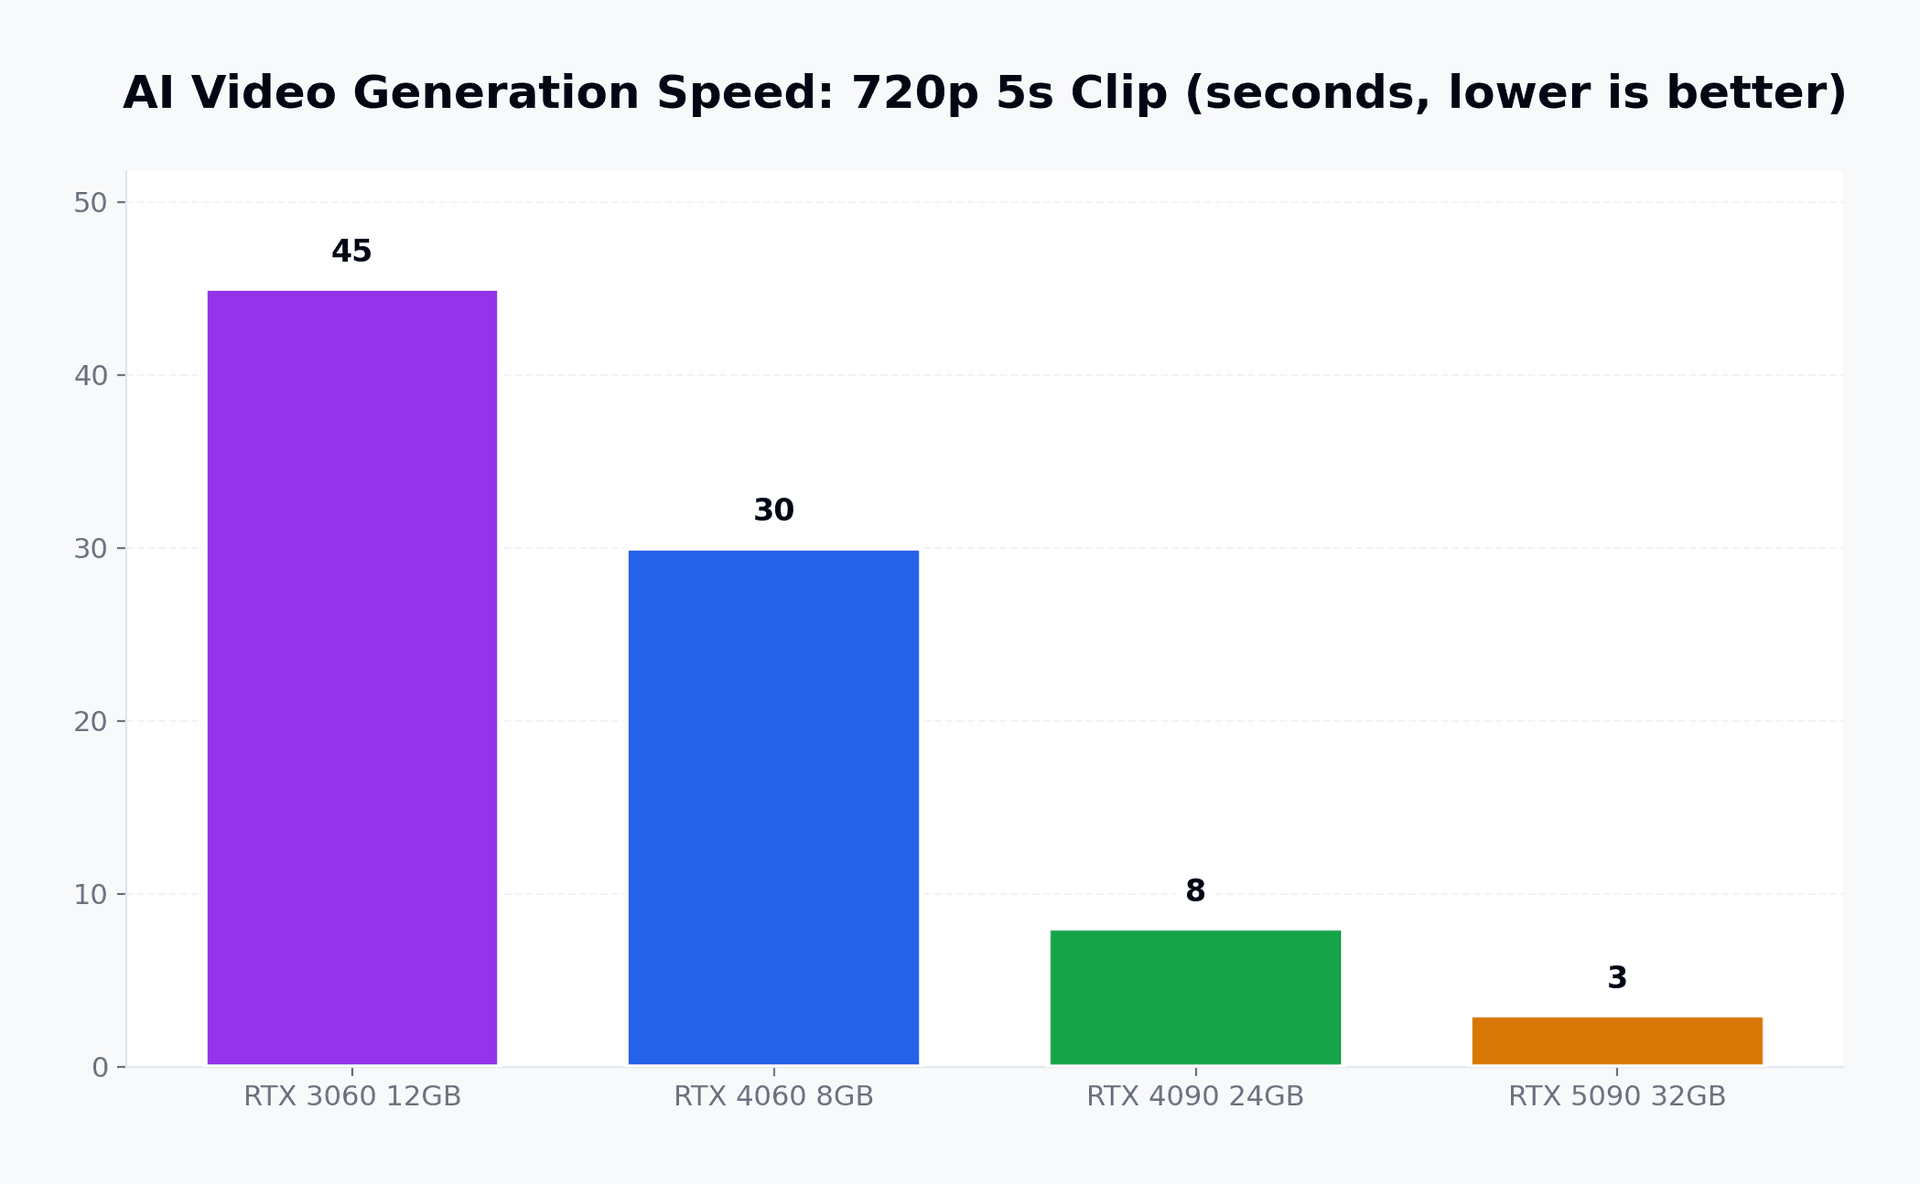
Prestandaskillnaden mellan generationerna är dramatisk. Här är vad NVIDIA demonstrerade på CES 2026:
| GPU | 720p (5s-klipp) | 1080p (5s-klipp) | 4K (5s-klipp) | VRAM-användning |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 sekunder | ~90 sekunder | Stöds inte | 11 GB |
| RTX 4060 8 GB | ~30 sekunder | ~60 sekunder | Stöds inte | 7,5 GB |
| RTX 4090 24 GB | ~8 sekunder | ~15 sekunder | ~45 sekunder | 18 GB |
| RTX 5090 32 GB | ~3 sekunder | ~6 sekunder | ~15 sekunder | 20 GB |
RTX 50-serien når sin tredubbla hastighetsökning genom nativ NVFP4-kvantisering, vilket halverar precisionen hos modellvikterna utan synlig kvalitetsförlust. Det är samma metod som gjorde LLM-modeller praktiskt användbara på konsumenthårdvara, nu applicerad på videodiffusion.
LTX-2: Vad som gör den speciell
LTX-2 är inte bara "ytterligare en modell med öppen källkod". Den innebär ett grundläggande skifte i vad som är möjligt på konsumenthårdvara.
Upp till 20 sekunder i 4K 50 FPS
Inbyggd ljudgenerering
Kontroll med flera nyckelbildrutor
LoRA-baserad anpassning
ComfyUI-integrering
Jämförelse med molntjänster
Låt mig vara konkret kring vad lokal generering kan och inte kan göra jämfört med de stora molnplattformarna.
| Funktion | LTX-2 (Lokalt) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Max upplösning | 4K | 1080p | 4K | 1080p |
| Max längd | 20 sekunder | 20 sekunder | 8 sekunder | 10 sekunder |
| Ljud | Inbyggt | Separat | Nativt | Separat |
| Sekretess | Fullständig | Moln | Moln | Moln |
| Månadskostnad | $0 | $20-200 | $20-50 | $15-100 |
| Anpassning | Full (LoRA) | Begränsad | Begränsad | Måttlig |
| Hastighet (1080p, 5s) | 6-60s (GPU-beroende) | 30-120s | 15-60s | 20-90s |
Avvägningen är tydlig: molntjänster erbjuder mer polerade resultat med mindre installation, medan lokal generering ger dig kontroll, sekretess och noll marginalkostnad per generering. För en djupare titt på hur dessa molnplattformar står sig mot varandra, se vår jämförelse mellan Sora 2, Runway och Veo 3.
Installera LTX-2 med ComfyUI: Steg för steg
Här är den praktiska genomgången. Jag förutsätter att du har ett NVIDIA-grafikkort med minst 8 GB VRAM och en aktuell drivrutin installerad.
Steg 1: Installera ComfyUI
ComfyUI är ett nodbaserat visuellt gränssnitt för diffusionsmodeller. Tänk på det som Blueprint-systemet i Unreal Engine, men för arbetsflöden med AI-generering.
# Klona ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Skapa en virtuell miljö
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Installera beroenden
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Steg 2: Ladda ner LTX-2-modellen
# Navigera till modellkatalogen
cd models/checkpoints

# Modellvikterna finns i Lightricks gated repo på Hugging Face. Godkänn villkoren på
# modellsidan först, autentisera sedan, annars ger varje nedladdning 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verifierat 2026-08-31: repot är gated (API rapporterar gated=auto, 17 filer). Välj den
# transformer som matchar ditt VRAM från diffusion_models/ och video-VAE från vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Steg 3: Installera ComfyUI-tillägget för LTX-2
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Steg 4: Starta och generera
# Återvänd till roten för ComfyUI
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Öppna http://127.0.0.1:8188 i din webbläsare. Läs in arbetsflödet för LTX-2 från tilläggets exempelmapp, skriv din prompt och klicka på "Queue Prompt".
Optimera din konfiguration
När grundinstallationen fungerar finns här de optimeringstrick som gör verklig skillnad.
VRAM-hantering
Den absolut största flaskhalsen för lokal generering är VRAM. Så här maximerar du det du har:
- ✓Aktivera modell-offloading (flyttar oanvända lager till systemets RAM-minne)
- ✓Använd NVFP8/NVFP4-kvantisering för din GPU-generering
- ✓Stäng webbläsarflikar och andra GPU-krävande program
- ✓Ställ in Windows på "Maskinvaruaccelererad GPU-schemaläggning" under skärminställningar
- ✓Överväg dual-boot med Linux (5-10 % bättre GPU-utnyttjande jämfört med Windows)
Arbetsflöde för batchbearbetning
För kreatörer som behöver generera många klipp stöder ComfyUI batchköer. Skapa dina promptar i en JSON-fil, anslut dem till en batch-inläsarnod och låt ditt grafikkort arbeta över natten.
LoRA-träning för anpassade stilar
Det är här lokal generering verkligen briljerar. Du kan träna en LoRA-adapter på 50-100 bildrutor med referensmaterial på cirka 30 minuter på ett RTX 4090. Resultatet är en lätt fil (vanligtvis 100-300 MB) som styr modellen mot din specifika visuella stil, karaktärsdrag eller miljöestetik.
# Exempel på LoRA-träningskommando
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Kostnadskalkylen
Låt mig sätta konkreta siffror på detta. Anta att du är en frilansande videoskapare som genererar 100 femsekundersklipp per månad.
| Tillvägagångssätt | Månadskostnad | Årskostnad | Sekretess |
|---|---|---|---|
| Sora 2 Pro | $100/månad | $1,200/år | Moln |
| Runway Standard | $76/månad | $912/år | Moln |
| Veo (Google AI Pro) | $50/månad | $600/år | Moln |
| LTX-2 + RTX 4090 | ~$15/månad (el) | ~$180/år | Fullständig |
Ett RTX 4090 kostar runt $1,600 enligt rekommenderat cirkapris, även om rådande marknadspriser ligger närmare $2,500-2,800 på grund av nedlagd produktion. Vid 100 klipp per månad med molntjänster betalar grafikkortet sig självt inom 18-24 månader även till marknadspris, och därefter genererar du till kostnaden för elen.
Vad som händer härnäst
Utvecklingstakten för lokal AI-videogenerering accelererar. Tre trender att hålla koll på:
Lansering av LTX-2.1
NVIDIA Rubin-plattformen
Meta Mango (potentiell öppen källkod)
Sammanfattning
Molnbaserade AI-videotjänster är utmärkta produkter. Sora, Veo, Runway, de levererar alla imponerande resultat med minimal installation. Men de medför kompromisser som många kreatörer börjar finna oacceptabla: återkommande kostnader, integritetsfrågor, internetberoende och begränsade anpassningsmöjligheter.
LTX-2 med ComfyUI på ett NVIDIA RTX-grafikkort är ingen kompromiss. Det är ett annat paradigm. Ett där du äger hela kedjan, från modellvikter till slutligt resultat. Installationen tar en eftermiddag. Inlärningskurvan finns där men är hanterbar. Och resultaten, särskilt i 4K med de senaste optimeringarna, är genuint konkurrenskraftiga gentemot molnalternativen.
Om du har ett RTX-grafikkort som står och samlar damm mellan spelsessionerna, ge det ett extrajobb. Du kan bli överraskad av vad det klarar av.
Relaterad läsning: För mer information om rörelsen kring AI-video med öppen källkod, se Revolutionen för AI-video med öppen källkod och vår tidigare djupdykning i nativ 4K-generering med LTX-2. Intresserad av det bredare landskapet? Se Prisrevolutionen för AI-video: Hur budgetverktyg utmanar jättarna.