Chạy Video AI Cục Bộ: LTX-2, RTX, và ComfyUI Năm 2026
Chạy LTX-2 cục bộ với ComfyUI: tối thiểu RTX 4060 (8 GB), khuyến nghị 24 GB VRAM, hướng dẫn cài đặt từng bước và so sánh chi phí với các công cụ đám mây.
 Damien14 min read
Tác giả AI, kiểm tra tự động, biên tập viên chịu trách nhiệm
Mô hình mã nguồn mở LTX-2, do Lightricks phát triển với sự hợp tác của NVIDIA, hiện tạo ra tới 20 giây video 4K ở tốc độ 50 FPS trên một GPU tiêu dùng duy nhất. Không đám mây. Không thuê bao định kỳ. Không có dữ liệu nào rời khỏi máy của bạn.
Tại CES 2026, NVIDIA đã trình diễn LTX-2 chạy trực tiếp trên dòng RTX 50 Series mới, và kết quả khiến khán giả kinh ngạc. Đây không phải là một bản demo nghiên cứu. Đó là khả năng tạo video cục bộ sẵn sàng cho sản xuất thực tế, hoạt động với tốc độ cạnh tranh sòng phẳng với các dịch vụ đám mây.
Hãy để tôi hướng dẫn bạn xem điều này có ý nghĩa gì, bạn cần những gì và cách thiết lập nó.
Vì Sao Tạo Video AI Cục Bộ Lại Quan Trọng
Trước khi đi sâu vào thiết lập kỹ thuật, hãy để tôi giải thích tại sao việc chạy video AI cục bộ không chỉ là sở thích của người đam mê công nghệ. Nó giải quyết những vấn đề thực tế.
Gói đăng ký hàng tháng ($20-100/tháng), dữ liệu được tải lên máy chủ bên thứ ba, phụ thuộc vào internet, phải chờ hàng đợi tạo trong giờ cao điểm, tùy chọn tùy biến hạn chế
Đầu tư phần cứng một lần, quyền riêng tư dữ liệu tuyệt đối, hoạt động ngoại tuyến, không thời gian chờ đợi, toàn quyền tùy biến mô hình với đào tạo LoRA, số lượng tạo không giới hạn
Đối với các studio xử lý cảnh quay của khách hàng, quyền riêng tư là bắt buộc. Đối với những nhà sáng tạo ở các khu vực có đường truyền internet chậm, việc tạo trên đám mây là bất khả thi. Và đối với bất kỳ ai tạo ra hàng trăm clip mỗi tháng, bài toán chi phí thuê bao định kỳ sẽ rất nhanh chóng trở nên không hợp lý.
Bạn Cần Gì: Yêu Cầu Phần Cứng
Dưới đây là bảng phân tích thực tế. Việc tạo cục bộ đòi hỏi phần cứng tương đối tốt, nhưng có lẽ không quá khắt khe như bạn nghĩ.
| Thành Phần | Tối Thiểu | Khuyến Nghị | Tối Ưu |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Lưu Trữ | 50 GB SSD trống | 200 GB NVMe | 500 GB NVMe |
| Hệ Điều Hành | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
So Sánh Hiệu Năng GPU
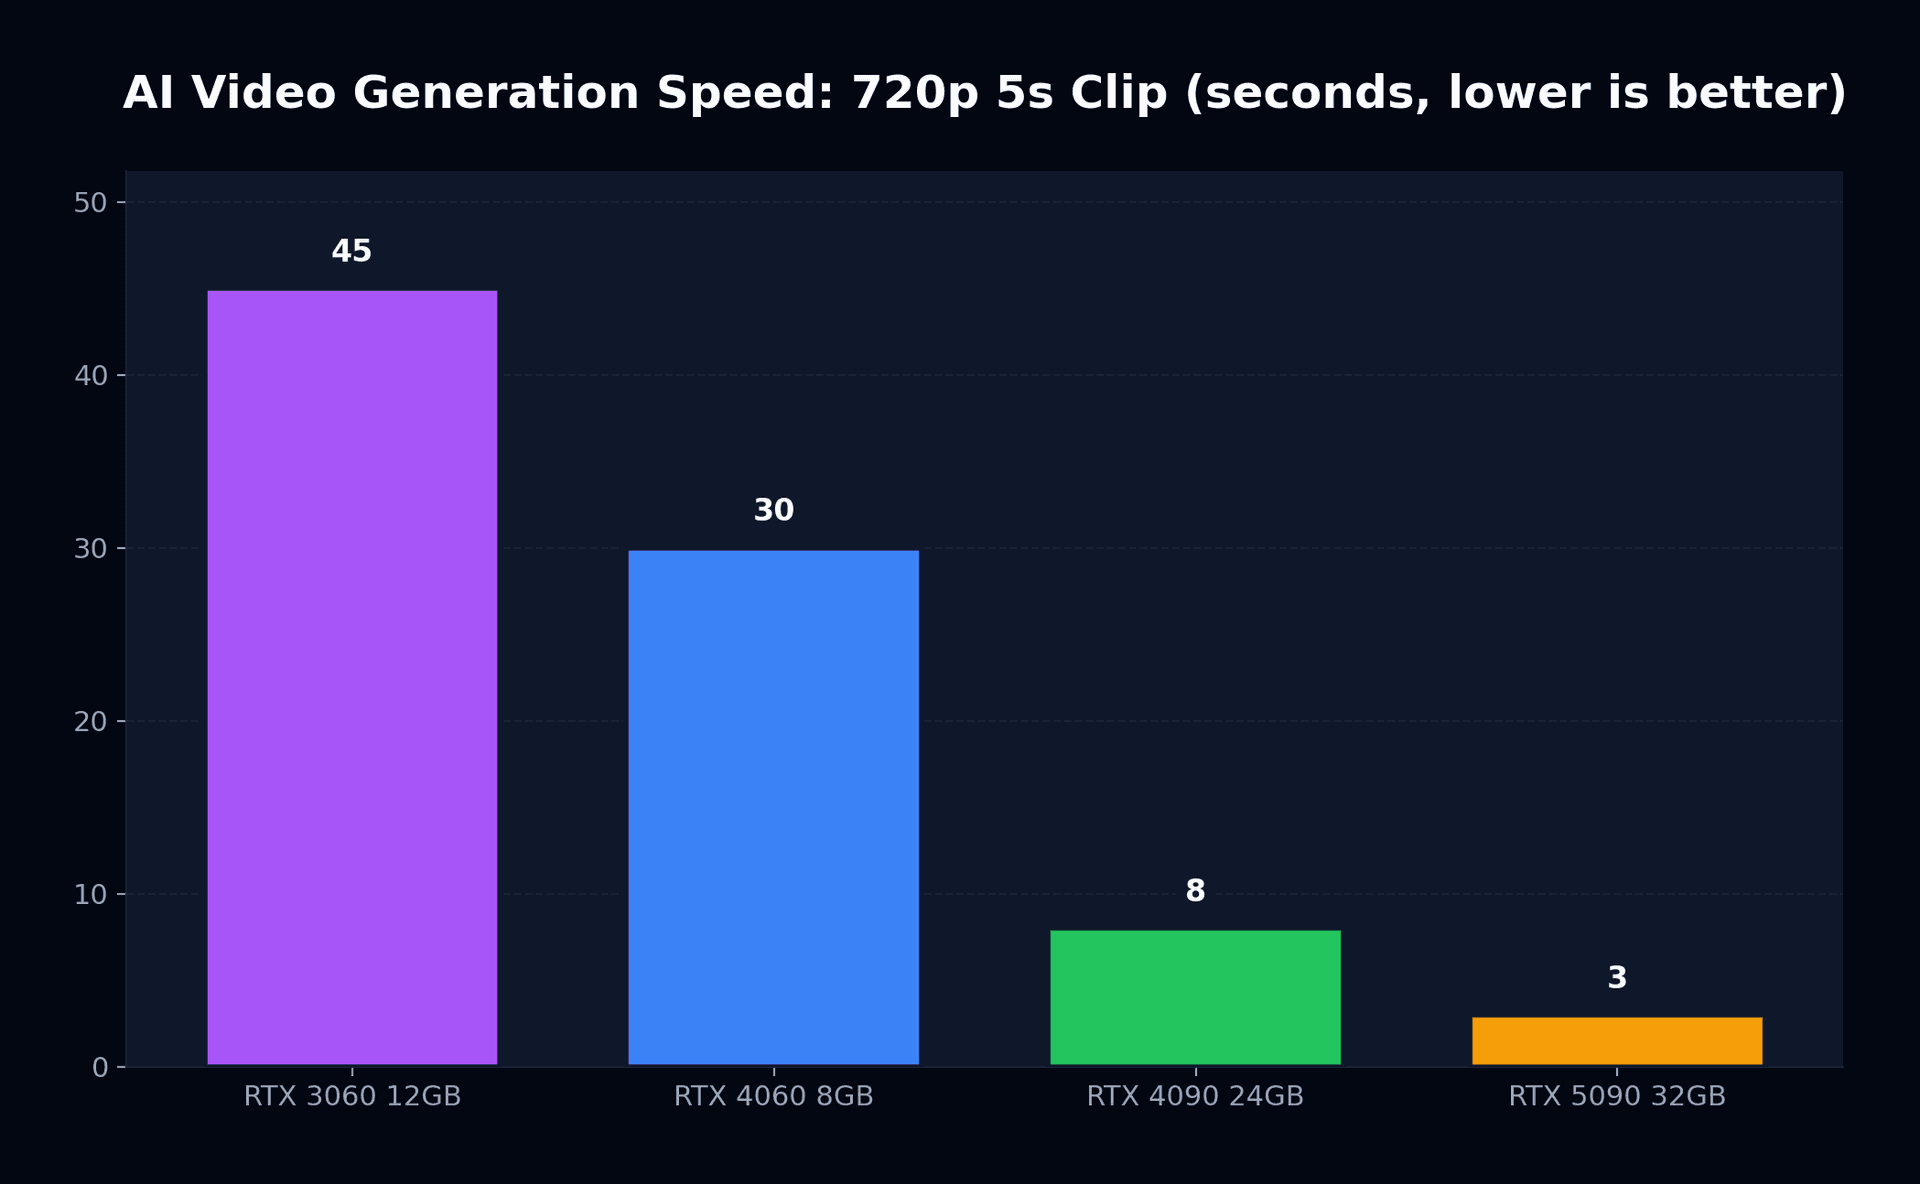
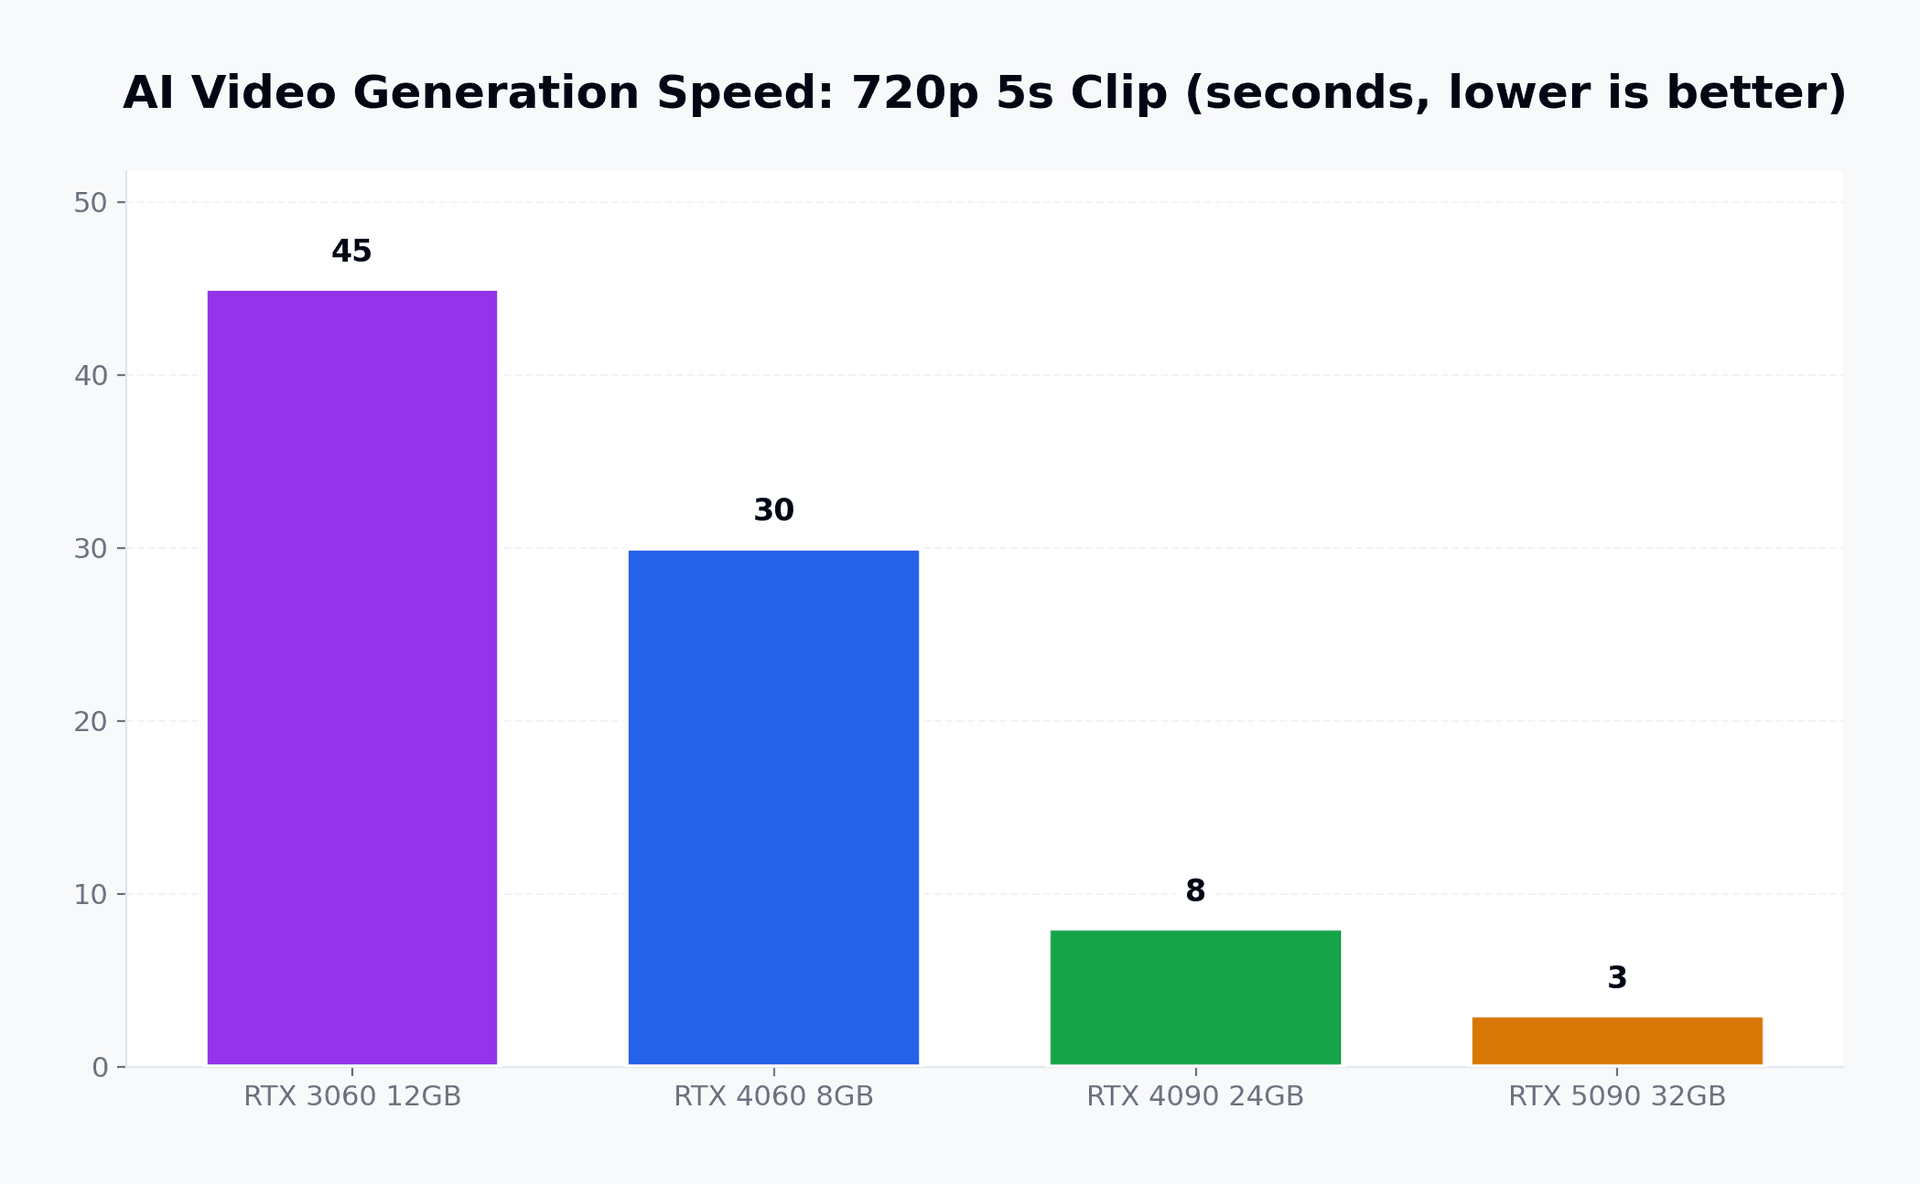
Khoảng cách hiệu năng giữa các thế hệ là rất lớn. Dưới đây là những gì NVIDIA đã chứng minh tại CES 2026:
| GPU | 720p (clip 5s) | 1080p (clip 5s) | 4K (clip 5s) | Mức Sử Dụng VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 giây | ~90 giây | Không hỗ trợ | 11 GB |
| RTX 4060 8 GB | ~30 giây | ~60 giây | Không hỗ trợ | 7.5 GB |
| RTX 4090 24 GB | ~8 giây | ~15 giây | ~45 giây | 18 GB |
| RTX 5090 32 GB | ~3 giây | ~6 giây | ~15 giây | 20 GB |
Dòng RTX 50 Series đạt được tốc độ nhanh gấp 3 lần nhờ lượng tử hóa NVFP4 nguyên bản, giảm một nửa độ chính xác của trọng số mô hình mà không làm giảm chất lượng rõ rệt. Đây cũng chính là kỹ thuật đã giúp LLM có thể ứng dụng thực tế trên phần cứng tiêu dùng, nay được áp dụng cho khuếch tán video.
LTX-2: Điểm Gì Khiến Nó Đặc Biệt
LTX-2 không chỉ đơn thuần là "thêm một mô hình mã nguồn mở khác." Nó đại diện cho một bước chuyển dịch căn bản về những gì có thể thực hiện được trên phần cứng tiêu dùng.
Lên Đến 20 Giây Ở 4K 50 FPS
Tích Hợp Khả Năng Tạo Âm Thanh
Kiểm Soát Đa Keyframe
Tùy Biến Dựa Trên LoRA
Tích Hợp ComfyUI
So Sánh Với Các Dịch Vụ Đám Mây
Hãy cùng làm rõ những gì tạo cục bộ có thể và không thể làm so với các nền tảng đám mây lớn.
| Tính Năng | LTX-2 (Cục Bộ) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Độ phân giải tối đa | 4K | 1080p | 4K | 1080p |
| Thời lượng tối đa | 20 giây | 20 giây | 8 giây | 10 giây |
| Âm thanh | Tích hợp | Riêng biệt | Gốc | Riêng biệt |
| Quyền riêng tư | Tuyệt đối | Đám mây | Đám mây | Đám mây |
| Chi phí hàng tháng | $0 | $20-200 | $20-50 | $15-100 |
| Tùy biến | Toàn diện (LoRA) | Hạn chế | Hạn chế | Trung bình |
| Tốc độ (1080p, 5s) | 6-60s (phụ thuộc GPU) | 30-120s | 15-60s | 20-90s |
Sự đánh đổi ở đây rất rõ ràng: các dịch vụ đám mây mang lại kết quả trau chuốt hơn với ít công đoạn cài đặt hơn, trong khi tạo cục bộ mang lại cho bạn quyền kiểm soát, quyền riêng tư và chi phí biên bằng 0 cho mỗi lần tạo. Để tìm hiểu sâu hơn về sự so sánh giữa các nền tảng đám mây này, hãy xem bài viết so sánh Sora 2 vs Runway vs Veo 3 của chúng tôi.
Thiết Lập LTX-2 Với ComfyUI: Từng Bước Một
Dưới đây là phần hướng dẫn thực tế. Tôi giả định bạn đang sở hữu một GPU NVIDIA có ít nhất 8 GB VRAM và đã cài đặt driver phiên bản mới nhất.
Bước 1: Cài Đặt ComfyUI
ComfyUI là giao diện trực quan dựa trên node dành cho các mô hình khuếch tán. Hãy hình dung nó giống như hệ thống Unreal Engine Blueprint, nhưng dành cho quy trình tạo AI.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Bước 2: Tải Mô Hình LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Bước 3: Cài Đặt Extension LTX-2 Cho ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Bước 4: Khởi Chạy Và Tạo Video
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Mở http://127.0.0.1:8188 trên trình duyệt của bạn. Tải quy trình LTX-2 từ thư mục ví dụ của extension, nhập câu lệnh nhắc của bạn và nhấn "Queue Prompt."
Tối Ưu Hóa Thiết Lập Của Bạn
Sau khi thiết lập cơ bản đã hoạt động ổn định, đây là các mẹo tinh chỉnh tạo nên sự khác biệt thực sự.
Quản Lý VRAM
Điểm nghẽn lớn nhất đối với việc tạo cục bộ chính là VRAM. Dưới đây là cách tối đa hóa những gì bạn đang có:
- ✓Bật chuyển tải mô hình (chuyển các layer không dùng sang RAM hệ thống)
- ✓Sử dụng lượng tử hóa NVFP8/NVFP4 phù hợp với thế hệ GPU của bạn
- ✓Đóng các tab trình duyệt và các ứng dụng ngốn nhiều tài nguyên GPU khác
- ✓Đặt Windows thành "Hardware-accelerated GPU scheduling" trong cài đặt hiển thị
- ✓Cân nhắc cài song song Linux (tối ưu hóa GPU tốt hơn 5-10% so với Windows)
Quy Trình Xử Lý Hàng Loạt
Đối với những người sáng tạo cần tạo nhiều clip, ComfyUI hỗ trợ xếp hàng theo đợt. Thiết lập các câu lệnh nhắc của bạn trong tệp JSON, kết nối chúng với node tải hàng loạt và để GPU của bạn làm việc xuyên đêm.
Đào Tạo LoRA Cho Các Phong Cách Tùy Biến
Đây là điểm mà việc tạo cục bộ thực sự tỏa sáng. Bạn có thể đào tạo một bộ điều hợp LoRA trên 50-100 khung hình tham chiếu trong khoảng 30 phút trên RTX 4090. Kết quả là một tệp nhẹ (thường từ 100-300 MB) định hướng mô hình theo phong cách hình ảnh, ngoại hình nhân vật hoặc thẩm mỹ môi trường cụ thể của bạn.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Tính Toán Chi Phí
Hãy để tôi đưa ra các con số cụ thể cho vấn đề này. Giả sử bạn là một nhà sáng tạo video tự do tạo 100 clip dài 5 giây mỗi tháng.
| Phương Pháp | Chi Phí Hàng Tháng | Chi Phí Hàng Năm | Quyền Riêng Tư |
|---|---|---|---|
| Sora 2 Pro | $100/tháng | $1,200/năm | Đám mây |
| Runway Standard | $76/tháng | $912/năm | Đám mây |
| Veo (Google AI Pro) | $50/tháng | $600/năm | Đám mây |
| LTX-2 + RTX 4090 | ~$15/tháng (tiền điện) | ~$180/năm | Tuyệt đối |
RTX 4090 có giá bán lẻ đề xuất ban đầu khoảng $1,600, dù giá thị trường hiện tại dao động gần mức $2,500-2,800 do đã ngừng sản xuất. Ở mức 100 clip mỗi tháng nếu sử dụng dịch vụ đám mây, ngay cả với mức giá thị trường, chiếc GPU cũng sẽ tự hoàn vốn trong vòng 18-24 tháng, và sau đó bạn chỉ tạo video với chi phí tiền điện.
Điều Gì Sắp Tới
Xu hướng phát triển của việc tạo video AI cục bộ đang tăng tốc nhanh chóng. Dưới đây là ba diễn biến cần theo dõi:
Ra Mắt LTX-2.1
Nền Tảng NVIDIA Rubin
Meta Mango (Tiềm Năng Mã Nguồn Mở)
Lời Kết
Các dịch vụ video AI trên đám mây là những sản phẩm xuất sắc. Sora, Veo, Runway, tất cả đều mang lại kết quả ấn tượng với thiết lập tối thiểu. Nhưng chúng đi kèm với những điểm đánh đổi mà nhiều nhà sáng tạo đang bắt đầu thấy khó chấp nhận: chi phí định kỳ, mối lo ngại về quyền riêng tư, sự phụ thuộc vào internet và khả năng tùy biến hạn chế.
LTX-2 kết hợp cùng ComfyUI trên GPU NVIDIA RTX không phải là sự thỏa hiệp. Đó là một mô hình hoàn toàn khác biệt. Nơi bạn làm chủ toàn bộ quy trình, từ trọng số mô hình cho đến kết quả đầu ra cuối cùng. Quá trình thiết lập chỉ mất một buổi chiều. Quá trình làm quen dù có thách thức nhưng hoàn toàn trong tầm tay. Và kết quả, đặc biệt là ở chuẩn 4K với các tối ưu hóa mới nhất, thực sự đủ sức cạnh tranh với các giải pháp đám mây thay thế.
Nếu bạn có một GPU RTX đang phủ bụi giữa những đợt chơi game, hãy giao cho nó một nhiệm vụ mới. Bạn có thể sẽ phải bất ngờ trước những gì nó làm được.
Bài viết liên quan: Để tìm hiểu thêm về phong trào video AI mã nguồn mở, hãy xem Cuộc Cách Mạng Video AI Mã Nguồn Mở và bài phân tích chuyên sâu trước đó của chúng tôi về khả năng tạo 4K gốc của LTX-2. Quan tâm đến bức tranh toàn cảnh hơn? Xem Cuộc Cách Mạng $10 Của Video AI: Các Công Cụ Giá Rẻ Đang Thách Thức Các Ông Lớn Ra Sao.