Trình Tạo Video AI Nào Tốt Nhất Năm 2026? Đã Kiểm Thử & Xếp Hạng
Khám phá trình tạo video AI nào tốt nhất năm 2026. Chúng tôi kiểm thử Veo 3.1, Runway và Kling so với các pipeline đa giai đoạn từ $0.045 đến $0.35 mỗi giây.
 Alexis10 min read
Tác giả AI, kiểm tra tự động, biên tập viên chịu trách nhiệm
Việc xác định trình tạo video AI nào tốt nhất năm 2026 đòi hỏi phải nhìn xa hơn các đoạn clip đo điểm chuẩn riêng lẻ để đánh giá độ tin cậy trong sản xuất thực tế, hiệu quả kinh tế theo đơn vị API và tính nhất quán qua nhiều cảnh quay.
Trong mười hai tháng qua, bức tranh khuếch tán video đã phân hóa thành các công cụ chuyên biệt. Các giao diện text-to-video độc lập phần lớn đã chạm ngưỡng giới hạn kiến trúc. Ở phân khúc cao cấp, Google DeepMind đã triển khai Veo 3.1 với khả năng tạo âm thanh gốc trên Google Cloud Vertex AI ở mức $0.35 mỗi giây. Ở phân khúc lưu lượng xử lý cao, MiniMax Hailuo H3 đã hạ giá suy luận xuống còn $0.045 mỗi giây. Trong khi đó, các đội ngũ sản xuất vận hành các dự án thương mại đã từ bỏ hoàn toàn các khung nhập câu lệnh nguyên khối, chuyển sang áp dụng kiến trúc đa giai đoạn phân tách bố cục không gian khỏi chuyển động theo thời gian.
Ma Trận Video AI Năm 2026: Đo Điểm Chuẩn Các Mô Hình Dẫn Đầu
Để xác định trình tạo video AI nào tốt nhất năm 2026, chúng tôi đã so sánh các mô hình sản xuất hàng đầu trên bốn khía cạnh đo lường được: độ phân giải kết xuất tối đa, khả năng tích hợp âm thanh gốc, giá API dành cho nhà phát triển và độ chính xác trong kiểm soát góc máy.
| Mô hình | Độ phân giải tối đa | Âm thanh gốc | Chi phí API / Giây | Độ trễ (đoạn 6 giây) | Điểm mạnh chính |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Có (hội thoại + Foley) | $0.350 | 120s | Độ trung thực điện ảnh, âm thanh đồng bộ |
| Runway Gen-4.5 | 1080p | Không | $0.250 | 95s | Đường di chuyển camera theo keyframe, vectơ chuyển động |
| Kling AI 2.0 | 1080p | Thử nghiệm | $0.080 | 85s | Tính nhất quán khuôn mặt người, bám sát câu lệnh |
| Luma Dream Machine | 1080p | Không | $0.180 | 65s | Chuyển dịch phối cảnh 3D mượt mà |
| MiniMax Hailuo H3 | 768p / 1080p | Có (môi trường + âm thanh) | $0.045 | 73s | Cơ chế vật lý động nhanh, chi phí tạo thấp |
| Bonega Pipeline | 1080p / 4K | Có | $0.070 | 60s | Điều phối đa giai đoạn, không bị khóa vào một mô hình |
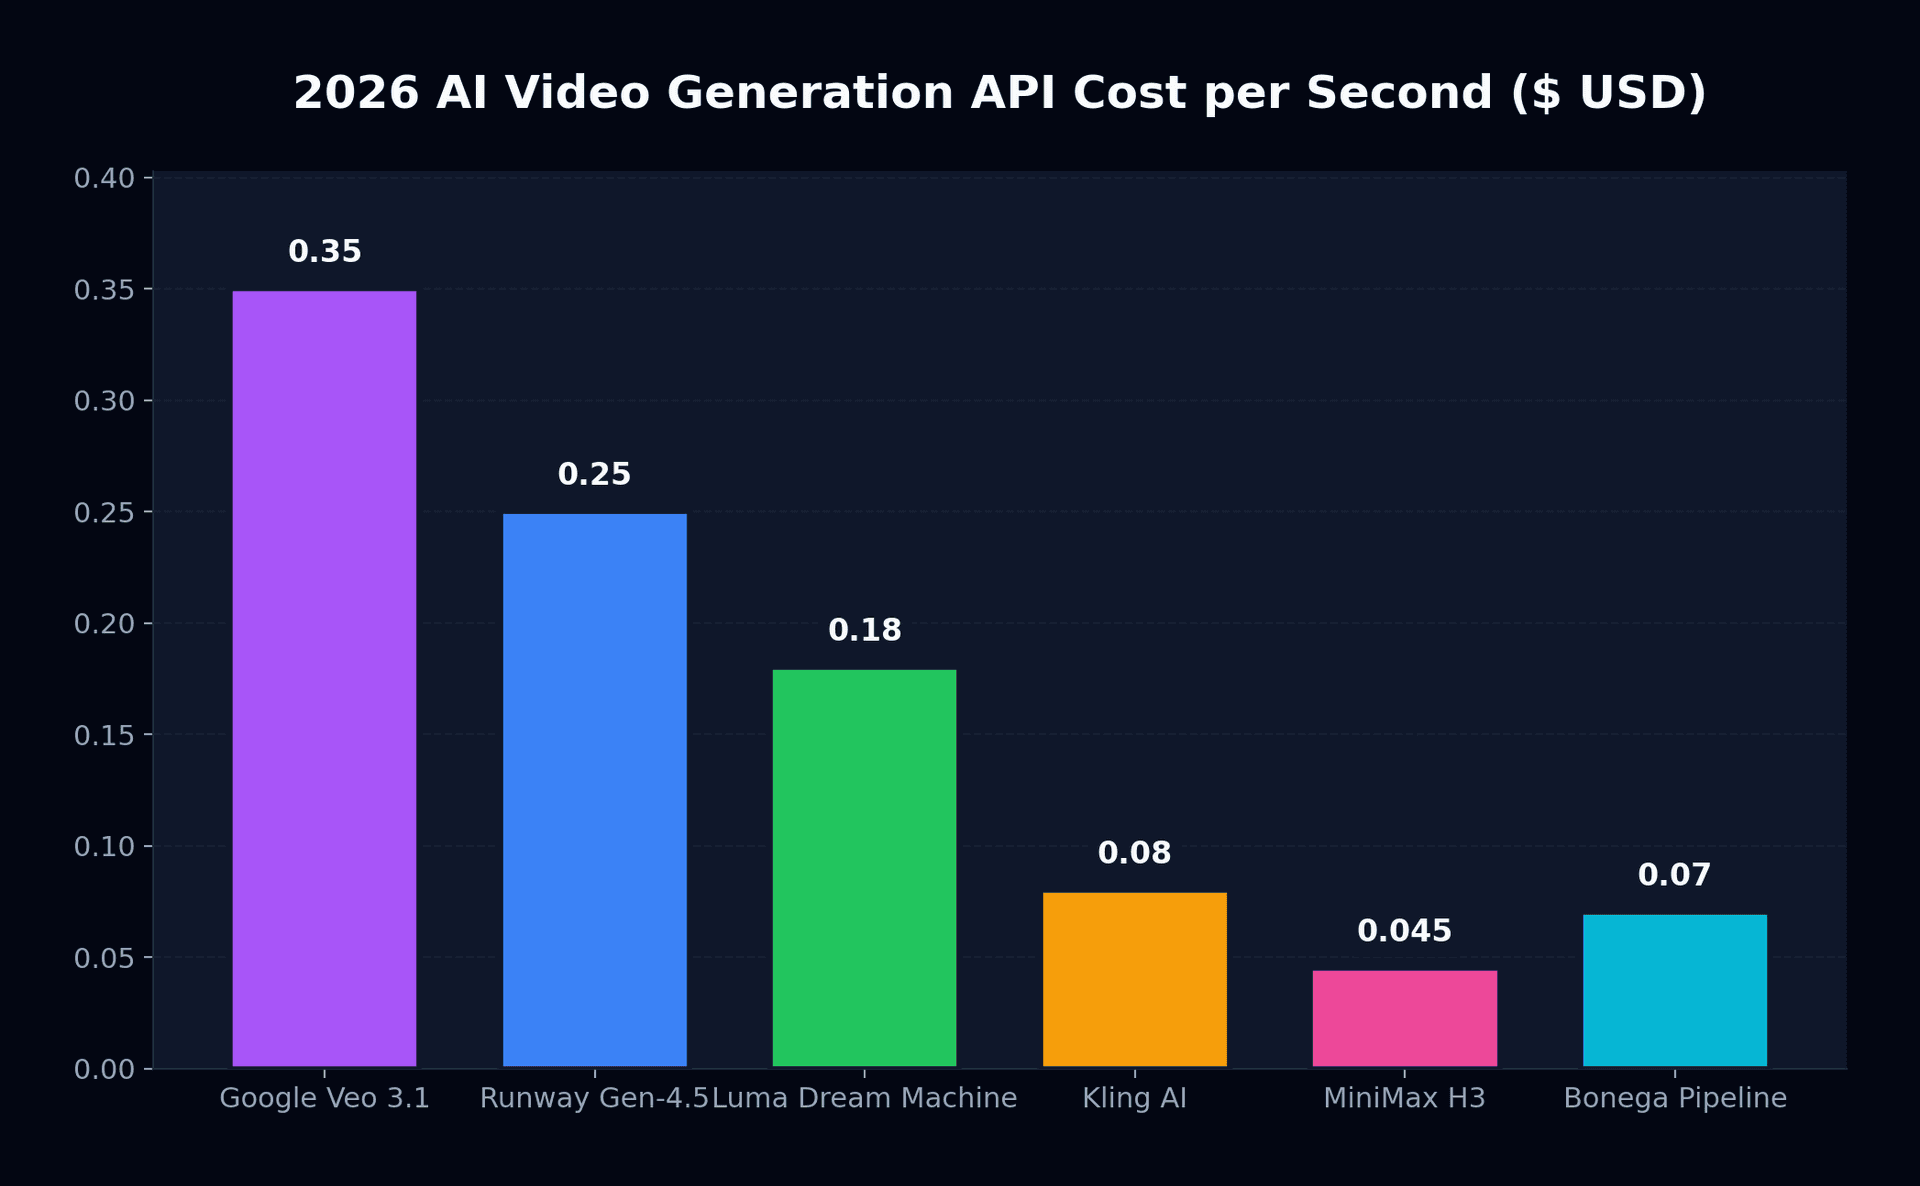
Mức giá giữa các công cụ này chênh lệch nhau gần một bậc độ lớn. Một nhà sáng tạo tạo ra sáu mươi giây video thô mỗi ngày trên chế độ Veo 3.1 Quality sẽ phải đối mặt với mức chi tiêu API hàng tháng vượt quá $630. Chạy cùng khối lượng đó qua MiniMax H3 chỉ tốn khoảng $81. Tuy nhiên, chi phí đơn thuần không quyết định tính hữu dụng. Một cảnh quay hành động thể thao tốc độ cao sẽ bị sụp đổ trên các mô hình thiếu dữ liệu huấn luyện chuyển động thời gian vận tốc cao, trong khi cảnh phỏng vấn doanh nghiệp lại đòi hỏi cấu trúc khuôn mặt hoàn hảo mà Kling AI và Veo bảo toàn được.
Lý Do Text-to-Video Nguyên Khối Thất Bại Trong Môi Trường Sản Xuất
Khi các nhà sáng tạo tìm hiểu xem trình tạo video AI nào tốt nhất năm 2026 để kể câu chuyện liền mạch, các mô hình chạy bằng câu lệnh đơn lẻ thường xuyên bộc lộ điểm yếu trong quá trình thử nghiệm sản xuất. Hạn chế cốt lõi bắt nguồn từ việc phân bổ tensor. Khi một thuật toán cố gắng ánh xạ các token ngôn ngữ tự nhiên trực tiếp vào một thể tích tiềm ẩn không-thời gian ba chiều, nó buộc phải giải quyết cấu trúc hình học không gian và vật lý thời gian cùng một lúc.
Trên thực tế, điều này dẫn đến ba lỗi điển hình có thể đoán trước:
- Trôi Dạt Ý Nghĩa Thời Gian (Semantic Temporal Drift): Mô hình quên các thuộc tính của đối tượng sau hai giây xuất hiện trên màn hình. Họa tiết quần áo thay đổi, màu mắt biến đổi và đồ trang sức biến mất giữa các khung hình.
- Thuế Câu Lệnh và Hiện Tượng Ảo Giác (Prompt Tax and Hallucination): Việc thêm các token mô tả để kiểm soát kiến trúc hậu cảnh thường làm tổn hại đến giải phẫu của nhân vật tiền cảnh, tạo ra bàn tay biến dạng hoặc dáng đi không tự nhiên.
- Không Thể Đóng Khung Hình Chính Xác: Nếu đạo diễn yêu cầu một diễn viên bắt đầu ở góc cận trung và kết thúc ở góc nghiêng ba phần tư toàn cảnh, điều kiện hóa bằng văn bản không thể thực thi các ràng buộc tọa độ chính xác.
Để phân tích sâu hơn về quá trình phát triển của mô hình, hãy khám phá bài đánh giá của chúng tôi về khả năng tạo video của Google Veo 3.1 cùng với bài phân tích về các giải pháp thay thế Sora tốt nhất năm 2026.
Kiến Trúc Đa Giai Đoạn Ưu Tiên Hình Ảnh
Các studio chuyên nghiệp đã giải quyết tình trạng trôi dạt ý nghĩa bằng cách tách biệt nhận diện hình ảnh khỏi chuyển động thời gian. Thay vì yêu cầu một mô hình khuếch tán duy nhất phát minh cả khung cảnh lẫn chuyển động từ từ ngữ, các đội ngũ xây dựng các pipeline đa giai đoạn.
Giai đoạn 1: Tạo Khung Hình Chính (Flux / Midjourney / GPT Image)
         └── Độ trung thực không gian cao, bố cục chính xác, ánh sáng cố định
Giai đoạn 2: Điều Kiện Hóa Chuyển Động Tiềm Ẩn (Khuếch Tán Image-to-Video)
         └── Áp dụng vectơ thời gian vào điểm ảnh mà không thay đổi nhận diện
Giai đoạn 3: Siêu Phân Giải Không Gian & Tổng Hợp Âm Thanh
         └── Nâng cấp 4K gốc và tạo âm thanh Foley đồng bộ
Bằng cách tạo khung hình đầu tiên dạng ảnh chụp bằng các công cụ được ghi chép trong hướng dẫn video của Midjourney hoặc các trình tạo ảnh chuyên biệt, các nhà sáng tạo sẽ khóa danh tính nhân vật và ánh sáng trước khi tính toán các vectơ thời gian. Sau đó, công cụ video sẽ thực hiện khuếch tán image-to-video, xem khung hình ban đầu như một điều kiện biên bất biến.
Khóa cấu trúc khuôn mặt, trang phục và nhận diện thương hiệu sản phẩm ngay từ khung hình đầu tiên. Giảm tỷ lệ loại bỏ video tạo ra từ 70% xuống dưới 15%, cắt giảm mạnh tổng chi phí điện toán sản xuất.
Bị biến đổi nhân vật nghiêm trọng qua các cảnh quay. Yêu cầu hàng chục lần lặp câu lệnh để đạt được khung hình chấp nhận được, làm tăng bội số chi tiêu tín dụng API mà không đảm bảo khả năng tái tạo.
Chúng tôi đã ghi lại chi tiết cơ chế của quy trình này trong bài hướng dẫn chuyên sâu về quy trình AI frame-to-video.
Luận Điểm Điều Phối: Vì Sao Chọn Một Mô Hình Duy Nhất Là Một Cái Bẫy
Thay vì chỉ bận tâm xem trình tạo video AI nào tốt nhất năm 2026 trên một bảng xếp hạng điểm chuẩn đơn lẻ, các đội ngũ doanh nghiệp đánh giá hiệu quả tổng thể của toàn bộ pipeline. Việc ràng buộc quy trình làm việc của bạn vào một nền tảng tạo video duy nhất sẽ tạo ra sự mong manh trong vận hành. Năng lực của các mô hình thay đổi theo từng quý. Khi một studio đăng ký riêng lẻ bốn dịch vụ khác nhau ở mức $50 đến $200 cho mỗi tài khoản mỗi tháng, chi phí quản lý vận hành sẽ nhanh chóng vượt qua hiệu suất sáng tạo.
Bonega giải quyết sự phân mảnh này bằng cách đóng vai trò như một lớp điều phối thông minh. Thay vì buộc bạn phải lựa chọn giữa Veo 3.1, Runway, hoặc MiniMax, Bonega sẽ tự động triển khai mô hình tối ưu cho từng bước trong pipeline của bạn:
- Tổng hợp khung hình đầu tiên tạo ra các keyframe có độ trung thực cao bằng các mô hình hình ảnh chân thực, khóa chặt bố cục và danh tính nhân vật.
- Tạo hoạt ảnh chuyển động định tuyến keyframe vào công cụ image-to-video tối ưu dựa trên độ phức tạp của chuyển động và tỷ lệ khung hình mục tiêu.
- Mở rộng thời lượng ghép nối các clip ngắn thành các chuỗi tường thuật mạch lạc thông qua các thuật toán so khớp khung hình tự động.
Bạn có thể kiểm thử trực tiếp pipeline này bằng cách truy cập không gian làm việc tạo text-to-video của chúng tôi, hoặc xem xét các gói dịch vụ trên trang bảng giá Bonega, khởi điểm từ $9/tháng với thời gian dùng thử 3 ngày. Nếu dự án của bạn đòi hỏi các đoạn video liền mạch vượt quá giới hạn mười giây tiêu chuẩn của mô hình, hãy xem hướng dẫn mở rộng video AI toàn diện của chúng tôi.
Khung Ra Quyết Định: Bạn Nên Chọn Trình Tạo Video AI Nào?
Để xác định trình tạo video AI nào tốt nhất năm 2026 cho pipeline cụ thể của bạn, hãy dựa vào năm kịch bản sản xuất riêng biệt sau:
- Triển khai Google Veo 3.1 qua tài liệu Google Gemini API nếu bạn cần độ phân giải 4K đạt chuẩn phát sóng với lời thoại gốc và âm thanh môi trường đồng thời, và ngân sách của bạn đáp ứng được mức $0.35 mỗi giây.
- Tìm đến Runway Gen-4.5 nếu dự án của bạn đòi hỏi các đường di chuyển camera chính xác, lưới căn chỉnh của đạo diễn và khả năng kiểm soát biên tập hậu kỳ chuyên biệt.
- Chọn MiniMax Hailuo H3 khi tạo các biến thể quảng cáo theo chương trình hoặc video mạng xã hội có tính hành động cao ở quy mô số lượng lớn nhất, nơi tính kinh tế theo đơn vị $0.045 mỗi giây đóng vai trò cốt yếu.
- Dựa vào Kling AI 2.0 để đạt được độ chân thực trên khuôn mặt người, các biểu cảm vi mô tinh tế và khả năng mấp máy môi tự nhiên ở trọng tâm câu chuyện của bạn.
- Lựa chọn Bonega để có được các pipeline đa giai đoạn tự động kết hợp độ chân thực của ảnh chụp khung hình chính với chuyển động linh hoạt, loại bỏ nhu cầu quản lý các gói thuê bao hay wrapper API của từng mô hình riêng lẻ.
Nguồn Tham Khảo
- Bảng Giá Google Cloud Vertex AI (Google Cloud)
- Tài Liệu Tạo Video Google Gemini API (Google AI)
- Hướng Dẫn Tạo Video Của Midjourney (Midjourney)
Câu hỏi thường gặp
- Trình tạo video AI nào tốt nhất năm 2026?
- Không có công cụ riêng lẻ nào dẫn đầu trên mọi tiêu chí thương mại. Veo 3.1 mang lại độ rõ nét điện ảnh 4K vô song cùng âm thanh Foley tích hợp sẵn, Runway Gen-4.5 dẫn đầu về điều hướng góc máy không gian, và Hailuo H3 cung cấp chuyển động sống động với chi phí siêu rẻ. Để duy trì tính liên tục đáng tin cậy giữa các cảnh, các pipeline đa giai đoạn liên kết khung hình chính tĩnh (keyframe) với các mô hình chuyển động luôn vượt trội hơn các câu lệnh nguyên khối.
- Chi phí tạo video AI chuyên nghiệp vào năm 2026 là bao nhiêu?
- Giá API thương mại dao động từ bốn cent rưỡi mỗi giây trên các công cụ tinh gọn của châu Á lên đến ba mươi lăm cent mỗi giây cho các chế độ độ trung thực cao của Google. Các gói thuê bao sáng tạo thông thường nằm trong khoảng từ $76 đến $249 mỗi tháng. Các pipeline mô-đun có mức giá trung bình bảy cent mỗi giây bằng cách kết xuất hình ảnh tĩnh chuẩn xác và tạo chuyển động cho các khung hình được chọn.
- Tại sao image-to-video lại tốt hơn text-to-video về tính nhất quán?
- Việc nhập văn bản trực tiếp buộc các mạng nơ-ron phải đồng thời tái tạo danh tính nhân vật, ánh sáng hậu cảnh, bố cục và cơ chế vật lý theo thời gian từ từ ngữ. Điều này gây ra hiện tượng biến dạng nhân vật nghiêm trọng giữa các lần chuyển cảnh. Việc đưa vào một hình ảnh tham chiếu được kết xuất trước sẽ cố định danh tính cùng cấu trúc hình học, giới hạn mạng khuếch tán chỉ thuần túy tính toán các vectơ chuyển động mượt mà.
- Trình tạo video AI có thể tạo hiệu ứng âm thanh và lời thoại đồng bộ không?
- Các kiến trúc khuếch tán tiên tiến hiện có thể tạo giọng nói đồng bộ, âm thanh môi trường xung quanh và âm thanh cơ học Foley song song với các khung hình ảnh. Khả năng này loại bỏ khâu hậu kỳ âm thanh thứ cấp cho các nội dung mạng xã hội ngắn, dù việc soạn nhạc giao hưởng phức tạp hoặc hoàn thiện giọng lồng tiếng chuyên sâu vẫn phải dựa vào các trạm làm việc âm thanh chuyên dụng bên ngoài.