ما هو أفضل مولد فيديو بالذكاء الاصطناعي في عام 2026؟ اختبار وتصنيف
اكتشف ما هو أفضل مولد فيديو بالذكاء الاصطناعي في عام 2026. نختبر Veo 3.1 وRunway وKling مقابل مسارات عمل متعددة المراحل تتراوح تكلفتها من $0.045 إلى $0.35 في الثانية.
 Alexis7 min read
كاتب ذكاء اصطناعي، فحوصات آلية، المسؤولية للمحرر
يتطلب تحديد أي مولد فيديو بالذكاء الاصطناعي هو الأفضل في عام 2026 النظر إلى ما هو أبعد من مقاطع الاختبار المعزولة لتقييم موثوقية الإنتاج، واقتصاديات وحدة واجهة برمجة التطبيقات (API)، والاتساق عبر اللقطات المتعددة.
خلال الاثني عشر شهراً الماضية، انقسم مشهد نماذج انتشار الفيديو إلى محركات متخصصة. ووصلت واجهات تحويل النص إلى فيديو المستقلة إلى مرحلة استقرار معماري إلى حد كبير. وفي الفئة المتقدمة، أطلقت Google DeepMind نموذج Veo 3.1 مع توليد صوتي أصلي على Google Cloud Vertex AI بسعر $0.35 في الثانية. ومن ناحية الإنتاجية العالية، خفض MiniMax Hailuo H3 تكلفة الاستدلال إلى $0.045 في الثانية. وفي الوقت نفسه، ابتعدت فرق الإنتاج التي تدير أعباء عمل تجارية تماماً عن مربعات التوجيه الأحادية، واعتمدت بنيات متعددة المراحل تفصل التكوين المكاني عن الحركة الزمنية.
مصفوفة فيديو الذكاء الاصطناعي لعام 2026: مقارنة أداء النماذج الرائدة
لتحديد أي مولد فيديو بالذكاء الاصطناعي هو الأفضل في عام 2026، قارنا نماذج الإنتاج الرائدة عبر أربعة أبعاد قابلة للقياس: أقصى دقة تصيير، وتكامل الصوت الأصلي، وتسعير واجهة برمجة التطبيقات (API) للمطورين، ودقة التحكم في الكاميرا.
| النموذج | أقصى دقة | صوت أصلي | تكلفة واجهة برمجة التطبيقات / ثانية | زمن الاستجابة (مقطع 6 ثوانٍ) | نقطة القوة الرئيسية |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | نعم (حوار + Foley) | $0.350 | 120s | دقة سينمائية، صوت متزامن |
| Runway Gen-4.5 | 1080p | لا | $0.250 | 95s | مسارات كاميرا بالإطارات المفتاحية، متجهات الحركة |
| Kling AI 2.0 | 1080p | تجريبي | $0.080 | 85s | اتساق تعابير الوجه البشري، التزام بالتوجيهات |
| Luma Dream Machine | 1080p | لا | $0.180 | 65s | تحولات سلسة في المنظور ثلاثي الأبعاد |
| MiniMax Hailuo H3 | 768p / 1080p | نعم (محيطي + صوت) | $0.045 | 73s | فيزياء ديناميكية سريعة، تكلفة توليد منخفضة |
| Bonega Pipeline | 1080p / 4K | نعم | $0.070 | 60s | تنظيم متعدد المراحل، بدون تقييد بنموذج واحد |
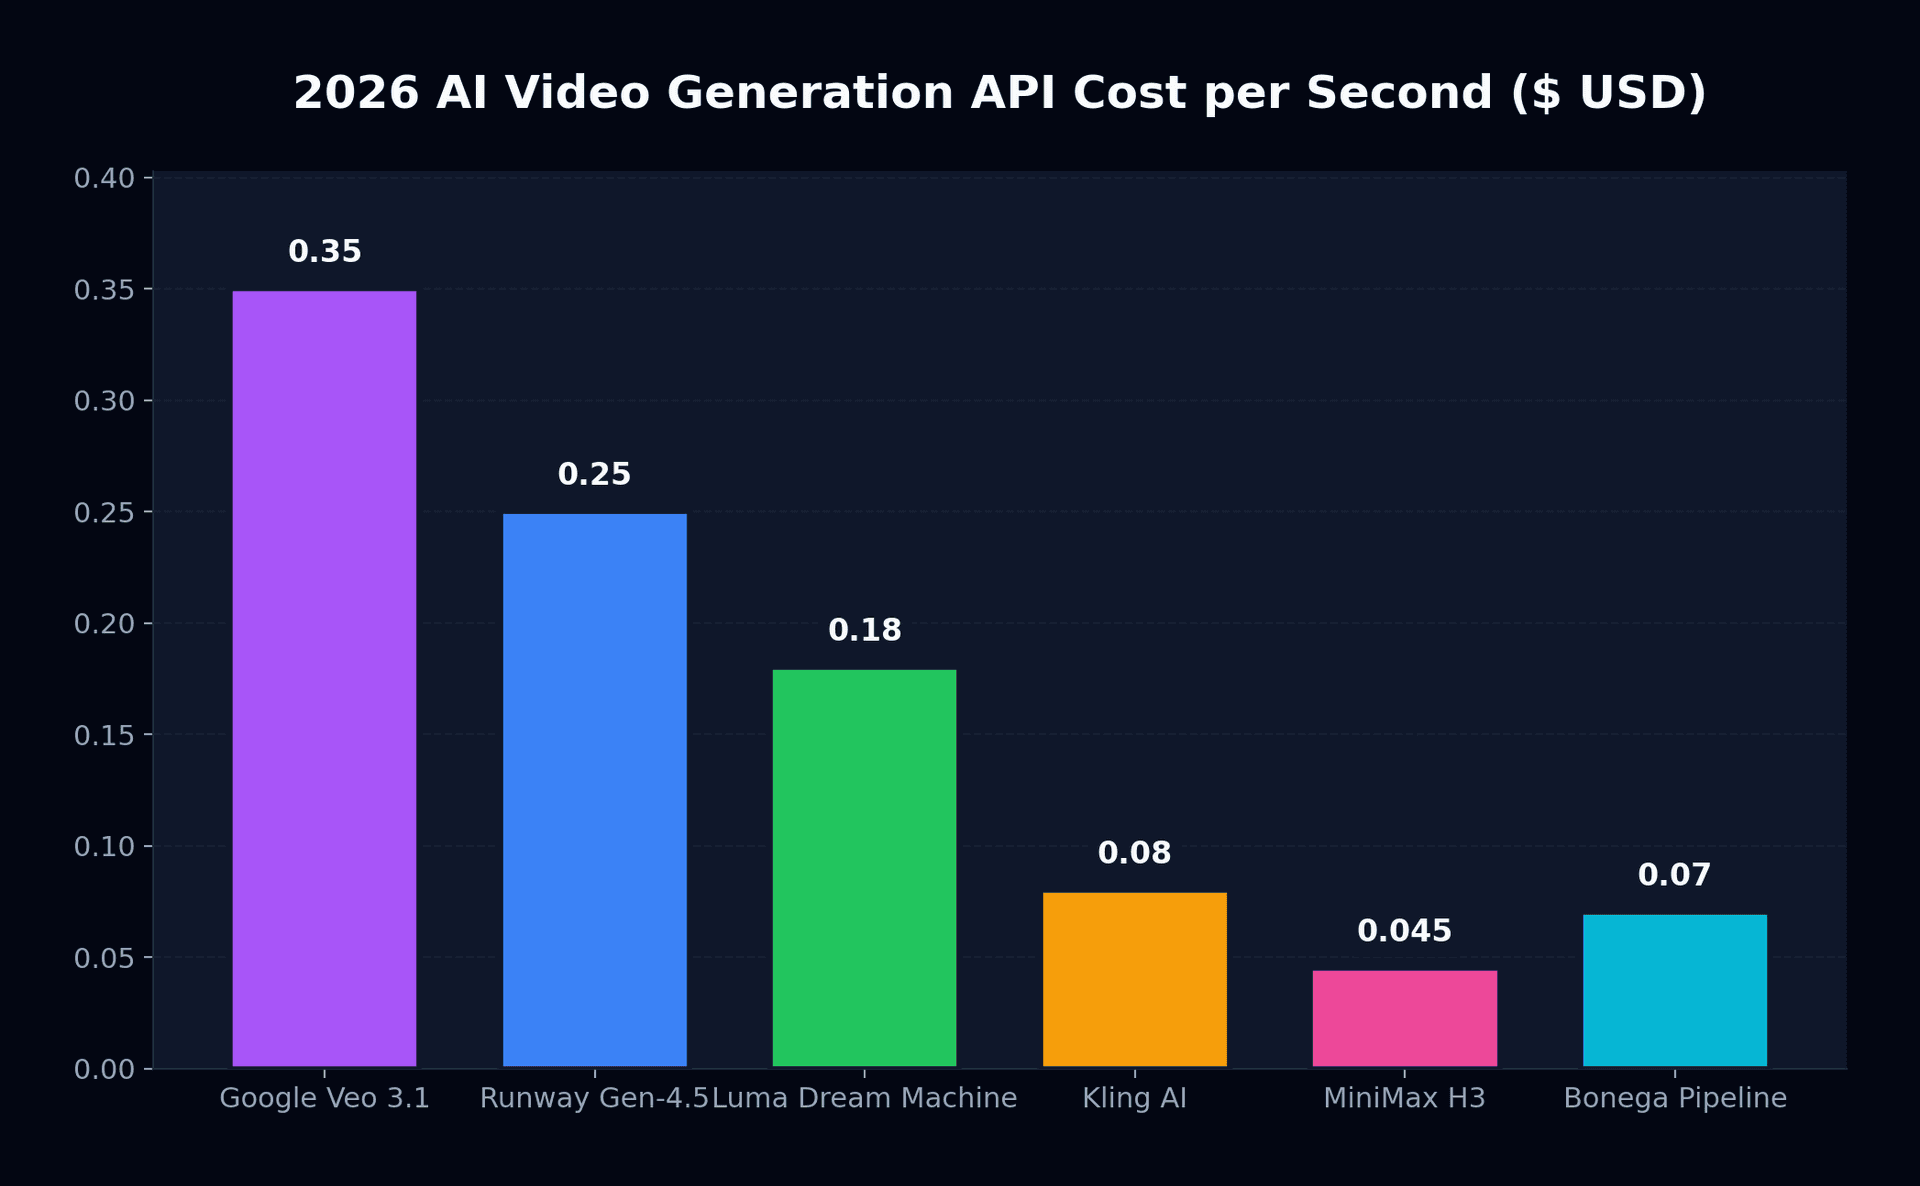
تتفاوت الأسعار عبر هذه المحركات بما يقارب رتبة مقدارية كاملة. فمنشئ المحتوى الذي يولد ستين ثانية من الفيديو الخام يومياً على وضع الجودة في Veo 3.1 يواجه استنزافاً شهرياً لميزانية واجهة برمجة التطبيقات يتجاوز $630. بينما يكلف تشغيل الحجم نفسه عبر MiniMax H3 حوالي $81. ومع ذلك، فإن التكلفة وحدها لا تحدد مدى الفائدة. إذ ينهار تسلسل رياضي سريع الحركة على النماذج التي تفتقر إلى التدريب الزمني عالي السرعة، بينما يتطلب مشهد مقابلة مؤسسية الهندسة الوجهية النقية التي يحافظ عليها Kling AI وVeo.
لماذا يفشل تحويل النص إلى فيديو الأحادي في مرحلة الإنتاج
عندما يبحث منشئو المحتوى عن أي مولد فيديو بالذكاء الاصطناعي هو الأفضل في عام 2026 للسرد القصصي المستمر، تفشل النماذج القائمة على موجه نصي واحد بانتظام أثناء اختبارات الإنتاج. ويعود القيد الجوهري إلى تخصيص الموترات (tensors). فعندما تحاول خوارزمية ربط رموز اللغة الطبيعية مباشرة بحجم كامن ثلاثي الأبعاد للزمكان، يجب عليها معالجة الهندسة المكانية والفيزياء الزمنية في آن واحد.
من الناحية العملية، يؤدي هذا إلى ثلاثة أنماط فشل متوقعة:
- الانجراف الدلالي الزمني: ينسى النموذج سمات العنصر بعد ثانيتين من وقت العرض. فتتغير أنماط الملابس، ويتبدل لون العينين، وتختفي المجوهرات بين الإطارات.
- ضريبة التوجيه والهلوسة: غالباً ما يؤدي إضافة رموز وصفية للتحكم في بنية الخلفية إلى الإضرار بتشريح الشخصية في المقدمة، مما يسفر عن أيادٍ مشوهة أو دورات مشي غير طبيعية.
- استحالة التأطير الدقيق: إذا طلب المخرج من ممثل أن يبدأ بلقطة مقربة متوسطة وينتهي بلقطة جانبية عريضة بزاوية ثلاثة أرباع، فإن التكييف النصي لا يمكنه فرض قيود إحداثيات دقيقة.
للحصول على تحليل أعمق لتطور النماذج، استكشف مراجعتنا حول توليد الفيديو عبر Google Veo 3.1 إلى جانب تفصيلنا حول أفضل بدائل Sora في عام 2026.
بنية العمل متعددة المراحل القائمة على الصورة أولاً
حلّت الاستوديوهات الاحترافية مشكلة الانجراف الدلالي من خلال فصل الهوية البصرية عن الحركة الزمنية. فبدلاً من مطالبة نموذج انتشار واحد بابتكار كل من المشهد وحركته من الكلمات، تبني الفرق مسارات عمل متعددة المراحل.
المرحلة 1: توليد الإطار المفتاحي (Flux / Midjourney / GPT Image)
         └── دقة مكانية عالية، وتكوين دقيق، وإضاءة ثابتة
المرحلة 2: تكييف الحركة الكامنة (انتشار من صورة إلى فيديو)
         └── متجهات زمنية مطبقة على البكسلات دون تغيير الهوية
المرحلة 3: الدقة المكانية الفائقة وتوليف الصوت
         └── ترقية أصلية إلى 4K وتوليد مؤثرات صوتية (Foley) متزامنة
من خلال إنشاء أول إطار فوتوغرافي باستخدام الأدوات الموثقة في إرشادات فيديو Midjourney أو مولدات الصور المتخصصة، يثبت المنشئون هوية الشخصية والإضاءة قبل حساب المتجهات الزمنية. ثم يقوم محرك الفيديو بعد ذلك بعملية انتشار من صورة إلى فيديو، معاملاً الإطار الأولي كشرط حدي غير قابل للتغيير.
يثبت هندسة الوجه، والملابس، والعلامة التجارية للمنتج في الإطار الأول. يخفض معدلات استبعاد التوليد من 70% إلى أقل من 15%، مما يقلل بشكل كبير من التكاليف الإجمالية للحوسبة الإنتاجية.
يعاني من طفرات وتشوهات شديدة في الشخصيات عبر اللقطات. يتطلب العشرات من محاولات صياغة الأوامر للوصول إلى تأطير مقبول، مما يضاعف استهلاك رصيد واجهة برمجة التطبيقات دون ضمان قابلية التكرار.
وثقنا آليات مسار العمل هذا في دليلنا المفصل حول مسارات عمل الذكاء الاصطناعي من الإطار إلى الفيديو.
أطروحة التنظيم والربط: لماذا يعتبر اختيار نموذج واحد فخاً
بدلاً من الهوس بتحديد أي مولد فيديو بالذكاء الاصطناعي هو الأفضل في عام 2026 على لوحة صدارة معيارية مفردة، تقيّم فرق المؤسسات كفاءة المسار بأكمله. إن تقييد مسار عملك بمنصة توليد فيديو واحدة يؤدي إلى هشاشة تشغيلية؛ حيث تتغير قدرات النماذج كل ربع سنة. وعندما يشترك الاستوديو بشكل فردي في أربع خدمات مختلفة بتكلفة تتراوح بين $50 و$200 لكل مقعد شهرياً، فإن النفقات التشغيلية تتجاوز الناتج الإبداعي بسرعة.
تحل Bonega هذا التشتت من خلال العمل كطبقة تنظيم ذكية. فبدلاً من إجبارك على الاختيار بين Veo 3.1 أو Runway أو MiniMax، تنشر Bonega النموذج الأمثل لكل خطوة في مسار عملك تلقائياً:
- توليف الإطار الأول يولد إطارات مفتاحية عالية الدقة باستخدام نماذج صور واقعية، مما يثبت التكوين وهوية الشخصية.
- تحريك المشهد يوجه الإطار المفتاحي إلى محرك تحويل الصورة إلى فيديو الأمثل بناءً على تعقيد الحركة ونسبة العرض إلى الارتفاع المستهدفة.
- تمديد المدة يدمج المقاطع القصيرة في تسلسلات سردية متماسكة عبر خوارزميات آلية لمطابقة الإطارات.
يمكنك اختبار هذا المسار مباشرة من خلال زيارة مساحة عمل إنشاء الفيديو من النص، أو مراجعة الخطط على صفحة أسعار Bonega، بدءاً من $9 شهرياً مع فترة تجريبية لمدة 3 أيام. وإذا كان مشروعك يتطلب مقاطع مستمرة تتجاوز الحدود القياسية للنماذج البالغة عشر ثوانٍ، فاطلع على دليلنا الشامل لتمديد الفيديو بالذكاء الاصطناعي.
إطار اتخاذ القرار: أي مولد فيديو بالذكاء الاصطناعي ينبغي لك اختياره؟
يعتمد حسم أي مولد فيديو بالذكاء الاصطناعي هو الأفضل في عام 2026 لمسار عملك المحدد على خمسة سيناريوهات إنتاج متميزة:
- استخدم Google Veo 3.1 عبر وثائق Google Gemini API إذا كنت بحاجة إلى دقة 4K جاهزة للبث مع حوار أصلي وصوت محيطي متزامنين في وقت واحد، وكانت ميزانيتك تدعم $0.35 في الثانية.
- اتجه إلى Runway Gen-4.5 إذا كان مشروعك يتطلب مسارات دقيقة لحركة الكاميرا، وشبكات توجيه إخراجية، وتحكماً تحريرياً متخصصاً لمرحلة ما بعد الإنتاج.
- اختر MiniMax Hailuo H3 عند إنشاء تنويعات إعلانية برمجية أو مقاطع فيديو اجتماعية سريعة الحركة بأقصى حجم، حيث تكون اقتصاديات الوحدة البالغة $0.045 في الثانية أمراً حاسماً.
- اعتمد على Kling AI 2.0 لتحقيق واقعية الوجه البشري، والتعبيرات الدقيقة المعقدة، ومزامنة الشفاه الطبيعية في صميم سردك القصصي.
- اختر Bonega للحصول على مسارات عمل مؤتمتة متعددة المراحل تجمع بين الواقعية الفوتوغرافية للإطار المفتاحي والحركة الديناميكية، مما يلغي الحاجة إلى إدارة اشتراكات النماذج الفردية أو أغلفة واجهات برمجة التطبيقات.
المصادر
- أسعار Google Cloud Vertex AI (Google Cloud)
- وثائق توليد الفيديو عبر Google Gemini API (Google AI)
- إرشادات توليد الفيديو في Midjourney (Midjourney)
الأسئلة الشائعة
- ما هو أفضل مولد فيديو بالذكاء الاصطناعي في عام 2026؟
- لا يوجد محرك فردي يتصدر جميع المعايير التجارية. يقدم Veo 3.1 وضوحاً سينمائياً بدقة 4K لا مثيل له مع مؤثرات صوتية (Foley) مدمجة، ويتصدر Runway Gen-4.5 في التوجيه المكاني للكاميرا، بينما يوفر Hailuo H3 حركة ديناميكية فائقة الانخفاض في التكلفة. ولتحقيق استمرارية موثوقة في المشاهد، تتفوق مسارات العمل متعددة المراحل التي تربط الإطارات المفتاحية الثابتة بنماذج الحركة باستمرار على التوجيهات النصية الأحادية.
- كم تبلغ تكلفة توليد الفيديو الاحترافي بالذكاء الاصطناعي في عام 2026؟
- تتراوح أسعار واجهات برمجة التطبيقات (API) التجارية بين أربعة سنتات ونصف لكل ثانية على المحركات الآسيوية الخفيفة وتصل إلى خمسة وثلاثين سنتاً لكل ثانية لأنماط الدقة العالية من Google. وتتراوح اشتراكات المنشئين النموذجية بين $76 و$249 شهرياً. بينما يبلغ متوسط مسارات العمل المعيارية سبعة سنتات في الثانية عبر إنشاء صور ثابتة نقية وتحريك إطارات مختارة.
- لماذا يعد تحويل الصورة إلى فيديو أفضل من تحويل النص إلى فيديو لتحقيق الاتساق؟
- يجبر التوجيه النصي المباشر الشبكات العصبية على ابتكار هوية الشخصية وإضاءة الخلفية والتكوين والفيزياء الزمنية في آن واحد وبشكل متزامن من الكلمات. ويؤدي ذلك إلى تشوه حاد في الشخصيات بين اللقطات. بينما يؤدي إدخال صورة مرجعية مسبقة الإنشاء إلى تثبيت الهوية والهندسة المكانية، مما يقصر عمل شبكة الانتشار حصرياً على حساب متجهات الحركة السلسة.
- هل يمكن لمولدات الفيديو بالذكاء الاصطناعي إنتاج مؤثرات صوتية وحوارات متزامنة؟
- تنتج بنيات الانتشار المتقدمة الآن كلاماً متزامناً ومشاهد صوتية محيطية ومؤثرات صوتية ميكانيكية بالتوازي مع الإطارات المرئية. تلغي هذه القدرة الحاجة إلى مرحلة ما بعد الإنتاج الصوتي الإضافية للمحتوى القصير لشبكات التواصل، على الرغم من أن الموسيقى التصويرية الأوركسترالية المعقدة أو إتقان التعليق الصوتي لا يزالان يعتمدان على محطات عمل صوتية خارجية مخصصة.