Spouštějte AI video lokálně: LTX-2, RTX a ComfyUI v roce 2026
Spouštějte LTX-2 lokálně pomocí ComfyUI: minimum je RTX 4060 (8 GB), doporučeno 24 GB VRAM, návod krok za krokem a srovnání nákladů s cloudovými nástroji.
 Damien10 min read
AI autor, automatizované kontroly, odpovědný editor
Open source model LTX-2, vyvinutý společností Lightricks ve spolupráci s NVIDIA, dnes dokáže vygenerovat až 20 sekund 4K videa při 50 FPS na jediné spotřebitelské grafické kartě. Žádný cloud. Žádné předplatné. Žádná data neopouštějí váš počítač.
Na veletrhu CES 2026 společnost NVIDIA předvedla nativní běh LTX-2 na nové řadě RTX 50 a výsledky publikum ohromily. Nešlo o žádné výzkumné demo. Byla to lokální tvorba videa připravená pro produkční nasazení, běžící rychlostmi srovnatelnými s cloudovými službami.
Pojďme se podívat, co to v praxi znamená, co budete potřebovat a jak vše nastavit.
Proč na lokálním generování AI videa záleží
Než se pustíme do technického nastavení, vysvětleme si, proč lokální běh AI videa není jen výsadou nadšenců. Řeší totiž skutečné problémy.
Měsíční předplatná ($20-100/měsíc), data nahrávaná na cizí servery, závislost na internetu, fronty na generování ve špičce, omezené možnosti přizpůsobení
Jednorázová investice do hardwaru, naprosté soukromí dat, funguje offline, žádné čekání ve frontách, plné přizpůsobení modelu pomocí trénování LoRA, neomezené generování
Pro studia zpracovávající klientské záběry je ochrana soukromí nutností. Pro tvůrce v regionech s pomalým připojením je cloudové generování nepraktické. A pro každého, kdo generuje stovky klipů měsíčně, přestávají počty kolem předplatného velmi rychle dávat smysl.
Co budete potřebovat: Hardwarové požadavky
Zde je upřímný přehled. Lokální generování vyžaduje slušný hardware, ale pravděpodobně ne tak extrémní, jak si myslíte.
| Komponenta | Minimum | Doporučeno | Optimální |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Úložiště | 50 GB volného místa na SSD | 200 GB NVMe | 500 GB NVMe |
| OS | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Porovnání výkonu GPU
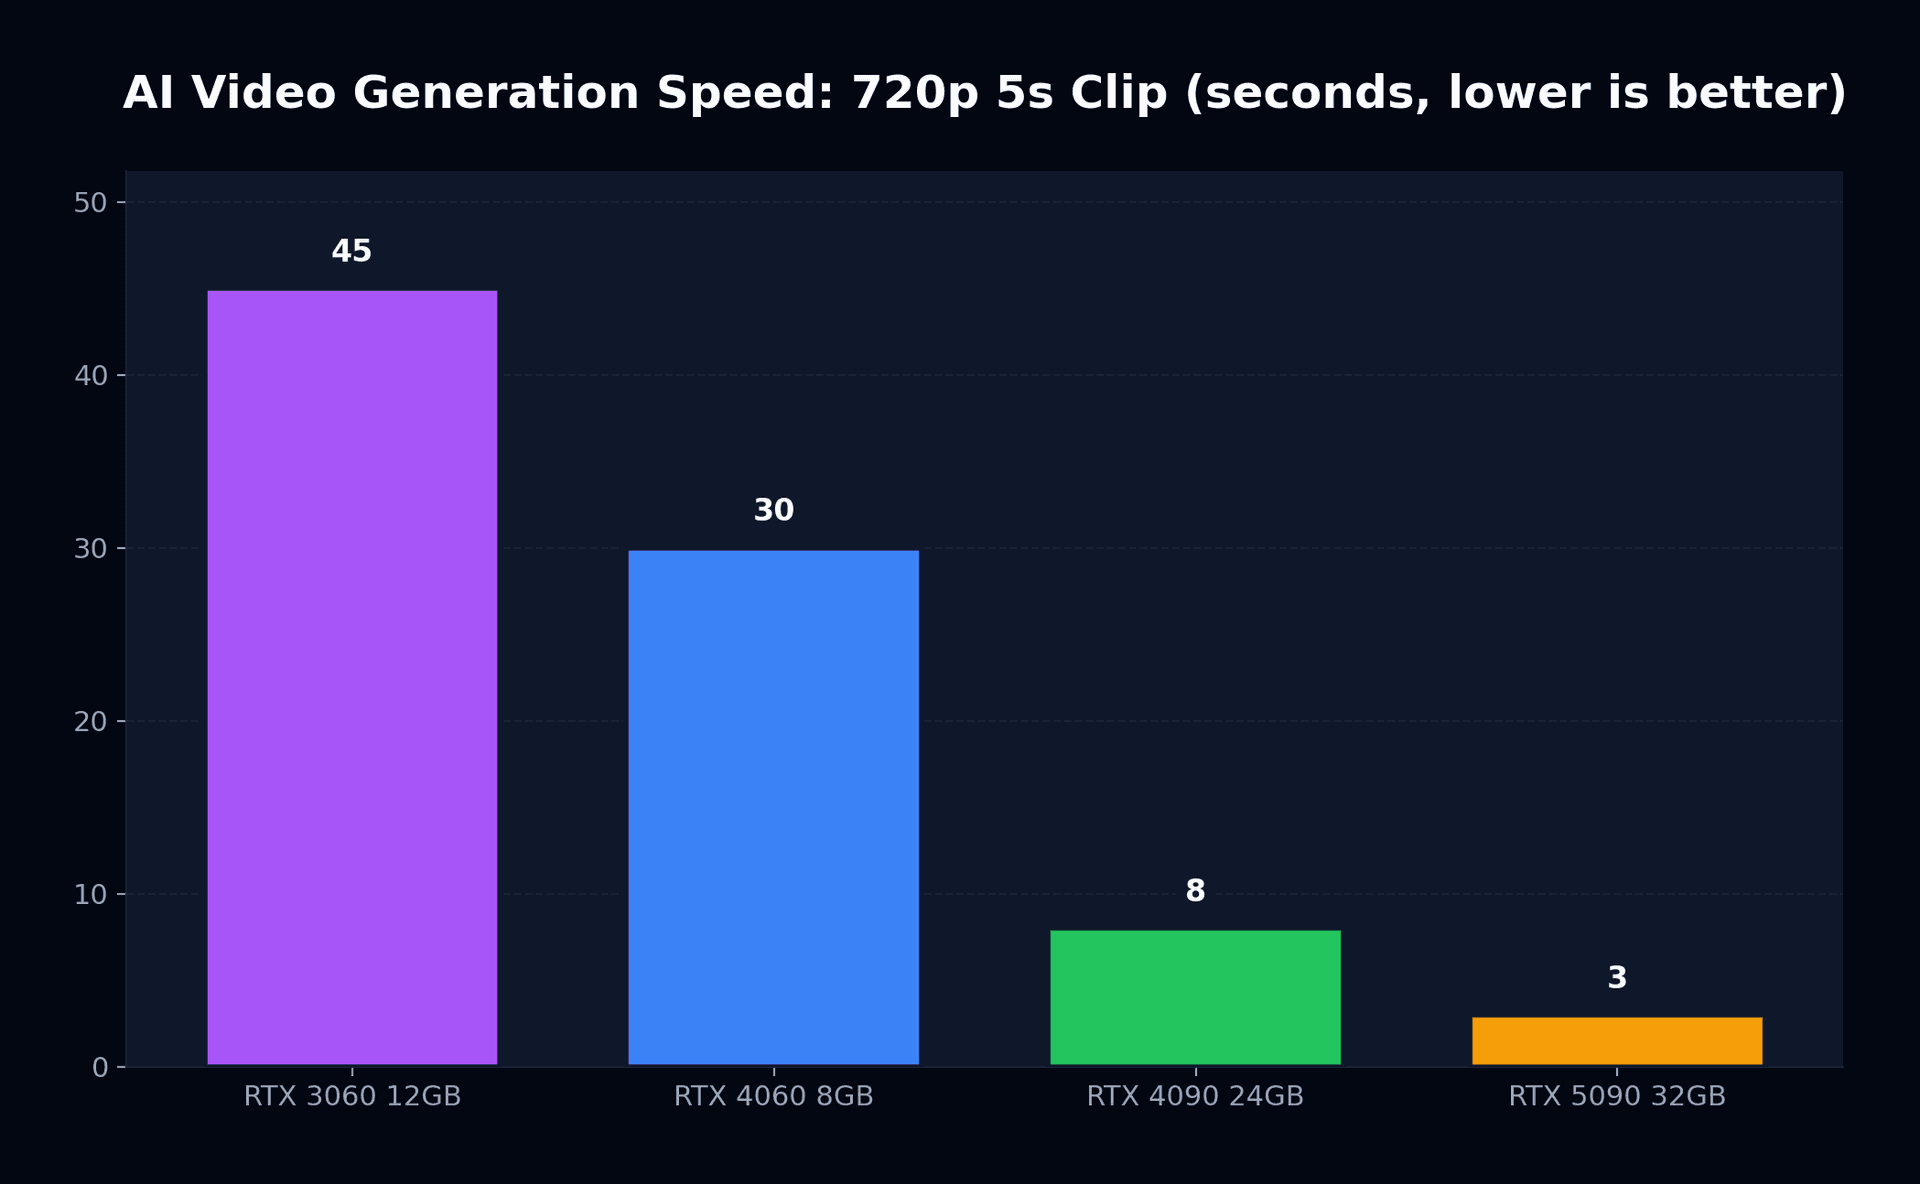
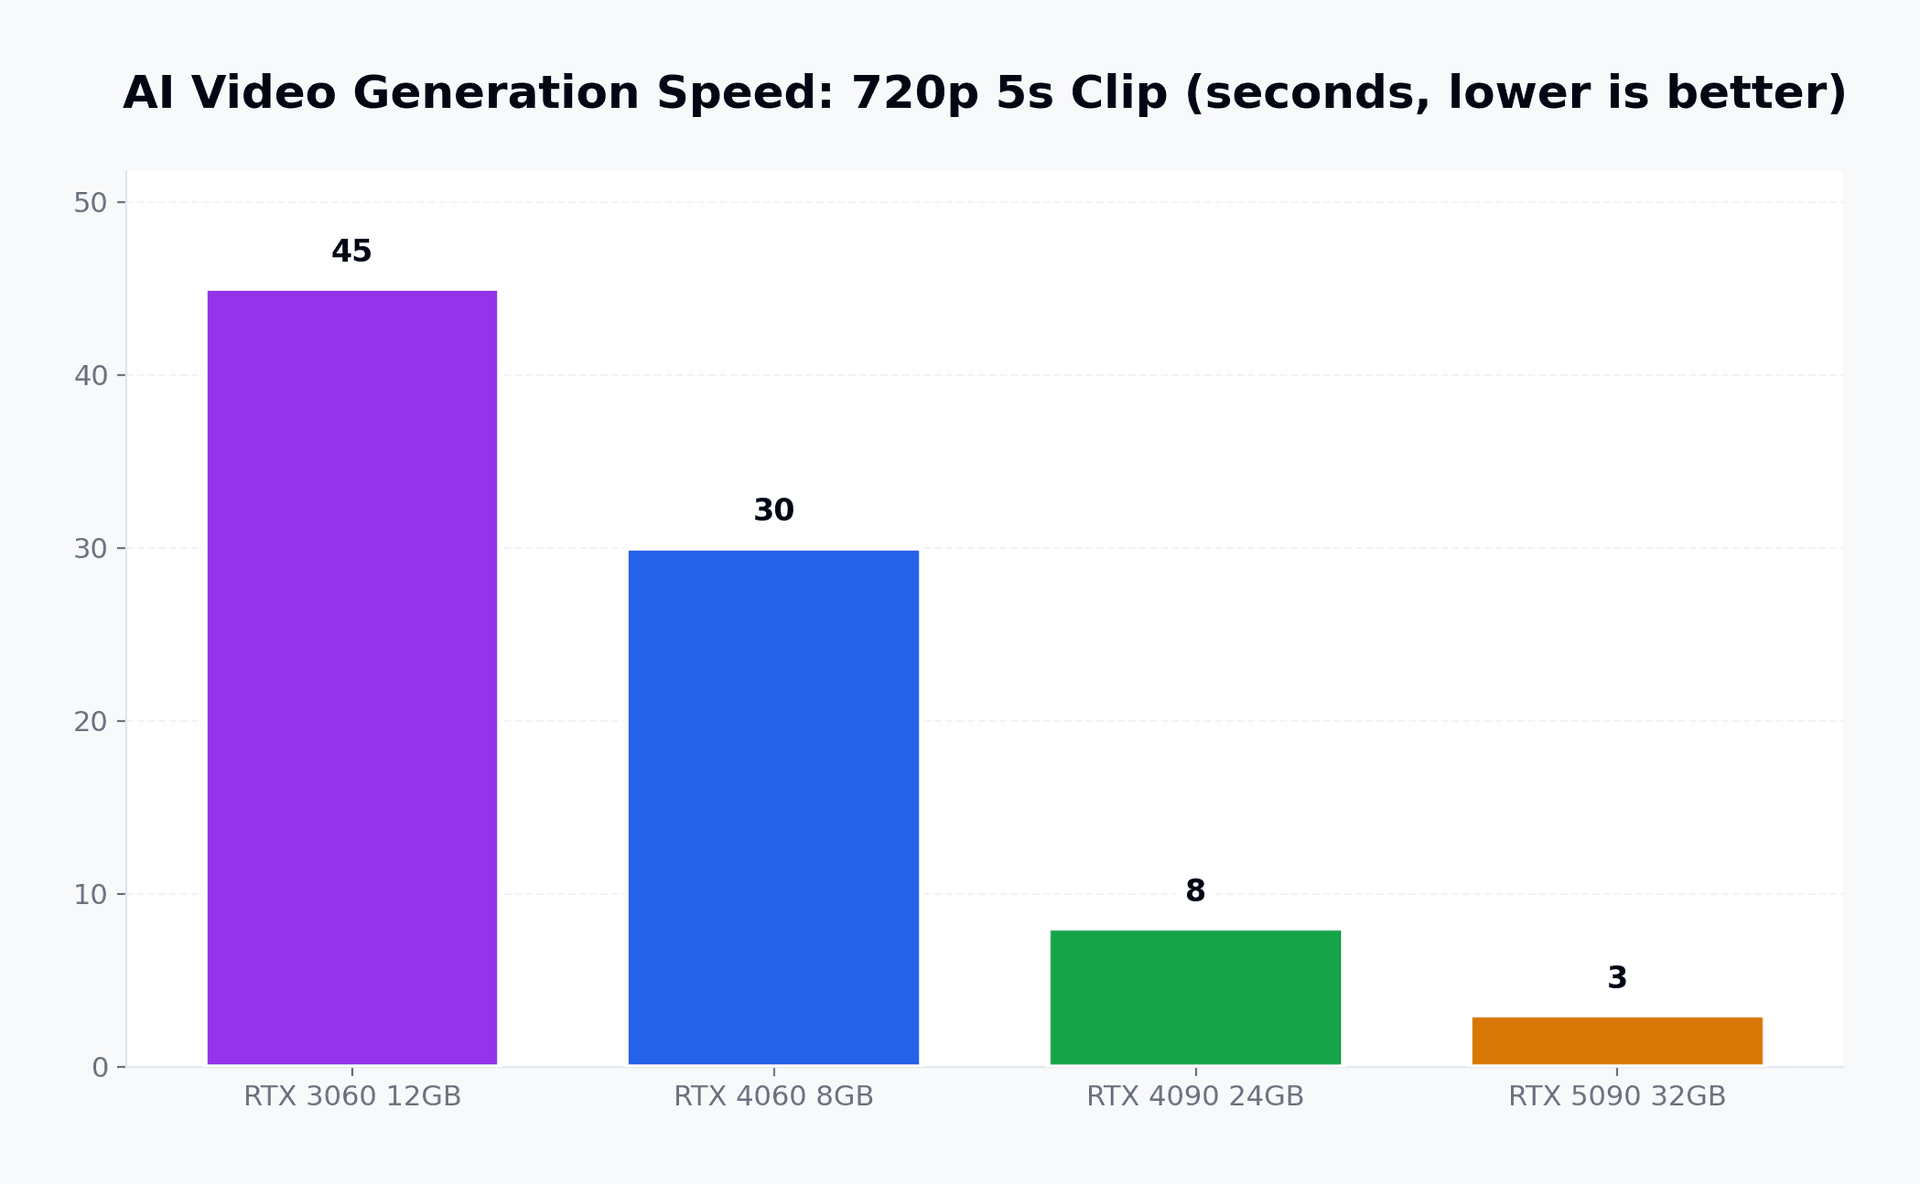
Výkonnostní rozdíl mezi jednotlivými generacemi je dramatický. Zde jsou data, která společnost NVIDIA předvedla na CES 2026:
| GPU | 720p (5s klip) | 1080p (5s klip) | 4K (5s klip) | Využití VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 sekund | ~90 sekund | Nepodporováno | 11 GB |
| RTX 4060 8 GB | ~30 sekund | ~60 sekund | Nepodporováno | 7.5 GB |
| RTX 4090 24 GB | ~8 sekund | ~15 sekund | ~45 sekund | 18 GB |
| RTX 5090 32 GB | ~3 sekundy | ~6 sekund | ~15 sekund | 20 GB |
Řada RTX 50 dosahuje trojnásobného zrychlení díky nativní kvantizaci NVFP4, která snižuje přesnost vah modelu na polovinu bez viditelné ztráty kvality. Jde o stejný postup, který umožnil praktické nasazení velkých jazykových modelů na spotřebitelském hardwaru, nyní aplikovaný na difúzi videa.
LTX-2: V čem je výjimečný
LTX-2 není jen "další open source model." Představuje zásadní posun v tom, co je na spotřebitelském hardwaru vůbec možné.
Až 20 sekund ve 4K 50 FPS
Vestavěné generování zvuku
Řízení pomocí více klíčových snímků
Přizpůsobení pomocí LoRA
Integrace s ComfyUI
Jak si stojí ve srovnání s cloudovými službami
Podívejme se konkrétně na to, co lokální generování ve srovnání s velkými cloudovými platformami zvládne a co nikoli.
| Funkce | LTX-2 (lokálně) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Maximální rozlišení | 4K | 1080p | 4K | 1080p |
| Maximální délka | 20 sekund | 20 sekund | 8 sekund | 10 sekund |
| Zvuk | Vestavěný | Samostatný | Nativní | Samostatný |
| Soukromí | Naprosté | Cloud | Cloud | Cloud |
| Měsíční náklady | $0 | $20-200 | $20-50 | $15-100 |
| Přizpůsobení | Plné (LoRA) | Omezené | Omezené | Střední |
| Rychlost (1080p, 5s) | 6-60 s (podle GPU) | 30-120 s | 15-60 s | 20-90 s |
Kompromis je zřejmý: cloudové služby nabízejí uhlazenější výstupy s jednodušším nastavením, zatímco lokální generování vám dává kontrolu, soukromí a nulové dodatečné náklady na každý vygenerovaný klip. Podrobnější pohled na srovnání těchto cloudových platforem najdete v našem srovnání Sora 2 vs Runway vs Veo 3.
Nastavení LTX-2 v ComfyUI: Krok za krokem
Zde je praktický průvodce. Předpokládáme, že máte grafickou kartu NVIDIA s alespoň 8 GB VRAM a nainstalované aktuální ovladače.
Krok 1: Instalace ComfyUI
ComfyUI je vizuální rozhraní založené na propojování uzlů pro difúzní modely. Představte si jej jako systém Blueprint v Unreal Engine, ale pro pracovní postupy generování AI.
# Klonování ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Vytvoření virtuálního prostředí
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Instalace závislostí
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Krok 2: Stažení modelu LTX-2
# Přechod do složky s modely
cd models/checkpoints

# Váhy se nacházejí v neveřejném (gated) repozitáři Lightricks na Hugging Face. Nejprve
# odsouhlaste podmínky na stránce modelu a poté se přihlaste, jinak stahování vrátí chybu 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Ověřeno 2026-08-31: repozitář je podmíněný přístupem (API hlásí gated=auto, 17 souborů).
# Zvolte transformer odpovídající vaší VRAM ze složky diffusion_models/ a video VAE ze složky vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Krok 3: Instalace rozšíření LTX-2 pro ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Krok 4: Spuštění a generování
# Návrat do kořenového adresáře ComfyUI
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Otevřete http://127.0.0.1:8188 ve svém prohlížeči. Načtěte workflow pro LTX-2 ze složky příkladů daného rozšíření, zadejte prompt a klikněte na "Queue Prompt."
Optimalizace vašeho nastavení
Jakmile základní nastavení funguje, přicházejí na řadu ladicí tipy, které přinášejí znatelný rozdíl.
Správa VRAM
Největší překážkou při lokálním generování je velikost VRAM. Zde je návod, jak z dostupné paměti vytěžit maximum:
- ✓Povolte odkládání modelu (přesune nepoužívané vrstvy do systémové RAM)
- ✓Používejte kvantizaci NVFP8/NVFP4 odpovídající vaší generaci GPU
- ✓Zavřete záložky v prohlížeči a další aplikace náročné na grafickou kartu
- ✓Ve Windows zapněte v nastavení obrazovky "Plánování GPU s hardwarovou akcelerací"
- ✓Zvažte dual-boot s Linuxem (o 5-10 % lepší využití GPU oproti Windows)
Pracovní postup s dávkovým zpracováním
Pro tvůrce, kteří potřebují generovat velké množství klipů, podporuje ComfyUI řazení do dávek. Připravte si prompty do JSON souboru, propojte je s dávkovým načítacím nodem a nechte grafickou kartu pracovat přes noc.
Trénování LoRA pro vlastní styly
Zde lokální generování skutečně vyniká. Adaptér LoRA můžete natrénovat na 50-100 referenčních snímcích přibližně za 30 minut na kartě RTX 4090. Výsledkem je malý soubor (obvykle 100-300 MB), který model nasměruje k vašemu konkrétnímu vizuálnímu stylu, vzhledu postav nebo estetice prostředí.
# Příklad příkazu pro trénování LoRA
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Výpočet nákladů
Ukažme si to na konkrétních číslech. Předpokládejme, že jste video tvůrce na volné noze a generujete 100 pětisekundových klipů měsíčně.
| Přístup | Měsíční náklady | Roční náklady | Soukromí |
|---|---|---|---|
| Sora 2 Pro | $100/měsíc | $1,200/rok | Cloud |
| Runway Standard | $76/měsíc | $912/rok | Cloud |
| Veo (Google AI Pro) | $50/měsíc | $600/rok | Cloud |
| LTX-2 + RTX 4090 | ~$15/měsíc (elektřina) | ~$180/rok | Naprosté |
Karta RTX 4090 stojí kolem $1,600 v doporučené ceně (MSRP), i když aktuální tržní ceny se kvůli ukončení výroby pohybují spíše kolem $2,500-2,800. Při objemu 100 klipů měsíčně v cloudových službách se i při tržní ceně investice do GPU vrátí během 18-24 měsíců, a poté již generujete pouze za cenu elektřiny.
Co se chystá dál
Vývoj lokálního generování AI videa neustále zrychluje. Vyplatí se sledovat tři klíčové trendy:
Vydání LTX-2.1
Platforma NVIDIA Rubin
Meta Mango (možný open source)
Závěrečné shrnutí
Cloudové služby pro generování AI videa jsou skvělé produkty. Sora, Veo, Runway, všechny přinášejí působivé výsledky s minimálním úsilím při nastavení. Přinášejí však kompromisy, které mnozí tvůrci začínají vnímat jako problematické: opakované poplatky, obavy o soukromí, závislost na připojení k internetu a omezené možnosti přizpůsobení.
LTX-2 s ComfyUI na kartě NVIDIA RTX nepředstavuje kompromis. Jde o zcela odlišný přístup, kdy vlastníte celý proces od vah modelu až po finální výstup. Nastavení zabere jedno odpoledne. Učení vyžaduje čas, ale není nepřekonatelné. A výsledky, zejména ve 4K s nejnovějšími optimalizacemi, plnohodnotně konkurují cloudovým alternativám.
Pokud vám grafická karta RTX zahálí mezi herními večery, dejte jí novou práci. Možná budete překvapeni, co všechno dokáže.
Související články: Pokud se chcete dozvědět více o hnutí open source AI videa, přečtěte si článek Revoluce open source AI videa a náš dřívější podrobný rozbor Nativní 4K generování s LTX-2. Zajímá vás širší kontext trhu? Podívejte se na Revoluce AI videa za $10: Jak cenově dostupné nástroje vyzývají giganty.