¿Cuál es el mejor generador de video con IA en 2026? Probado y clasificado
Descubre cuál es el mejor generador de video con IA en 2026. Probamos Veo 3.1, Runway y Kling frente a pipelines multietapa desde $0.045 hasta $0.35 por segundo.
 Alexis8 min read
Autor de IA, revisiones automáticas, edición responsable
Decidir cuál es el mejor generador de video con IA en 2026 exige mirar más allá de clips de prueba aislados para evaluar la fiabilidad de producción, la economía unitaria de la API y la consistencia en múltiples tomas.
Durante los últimos doce meses, el panorama de la difusión de video se fragmentó en motores especializados. Las interfaces independientes de texto a video han alcanzado en gran medida un estancamiento arquitectónico. En el segmento de alta gama, Google DeepMind implementó Veo 3.1 con generación nativa de audio en Google Cloud Vertex AI a $0.35 por segundo. En el extremo de alto rendimiento, MiniMax Hailuo H3 redujo el precio de inferencia a $0.045 por segundo. Mientras tanto, los equipos de producción que ejecutan flujos de trabajo comerciales han abandonado por completo las cajas de prompts monolíticas, adoptando arquitecturas multietapa que separan la composición espacial del movimiento temporal.
La matriz de video con IA de 2026: comparativa de los principales modelos
Para determinar cuál es el mejor generador de video con IA en 2026, comparamos los principales modelos de producción a lo largo de cuatro dimensiones medibles: resolución máxima de renderizado, integración de audio nativo, precios de la API para desarrolladores y precisión del control de cámara.
| Modelo | Resolución máxima | Audio nativo | Costo de API / seg | Latencia (clip de 6s) | Fortaleza principal |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Sí (diálogo + Foley) | $0.350 | 120s | Fidelidad cinematográfica, sonido sincronizado |
| Runway Gen-4.5 | 1080p | No | $0.250 | 95s | Rutas de cámara por fotogramas clave, vectores de movimiento |
| Kling AI 2.0 | 1080p | Experimental | $0.080 | 85s | Consistencia facial humana, adherencia al prompt |
| Luma Dream Machine | 1080p | No | $0.180 | 65s | Cambios fluidos de perspectiva 3D |
| MiniMax Hailuo H3 | 768p / 1080p | Sí (ambiente + sonido) | $0.045 | 73s | Física dinámica rápida, bajo costo de generación |
| Bonega Pipeline | 1080p / 4K | Sí | $0.070 | 60s | Orquestación multietapa, cero dependencia de un solo modelo |
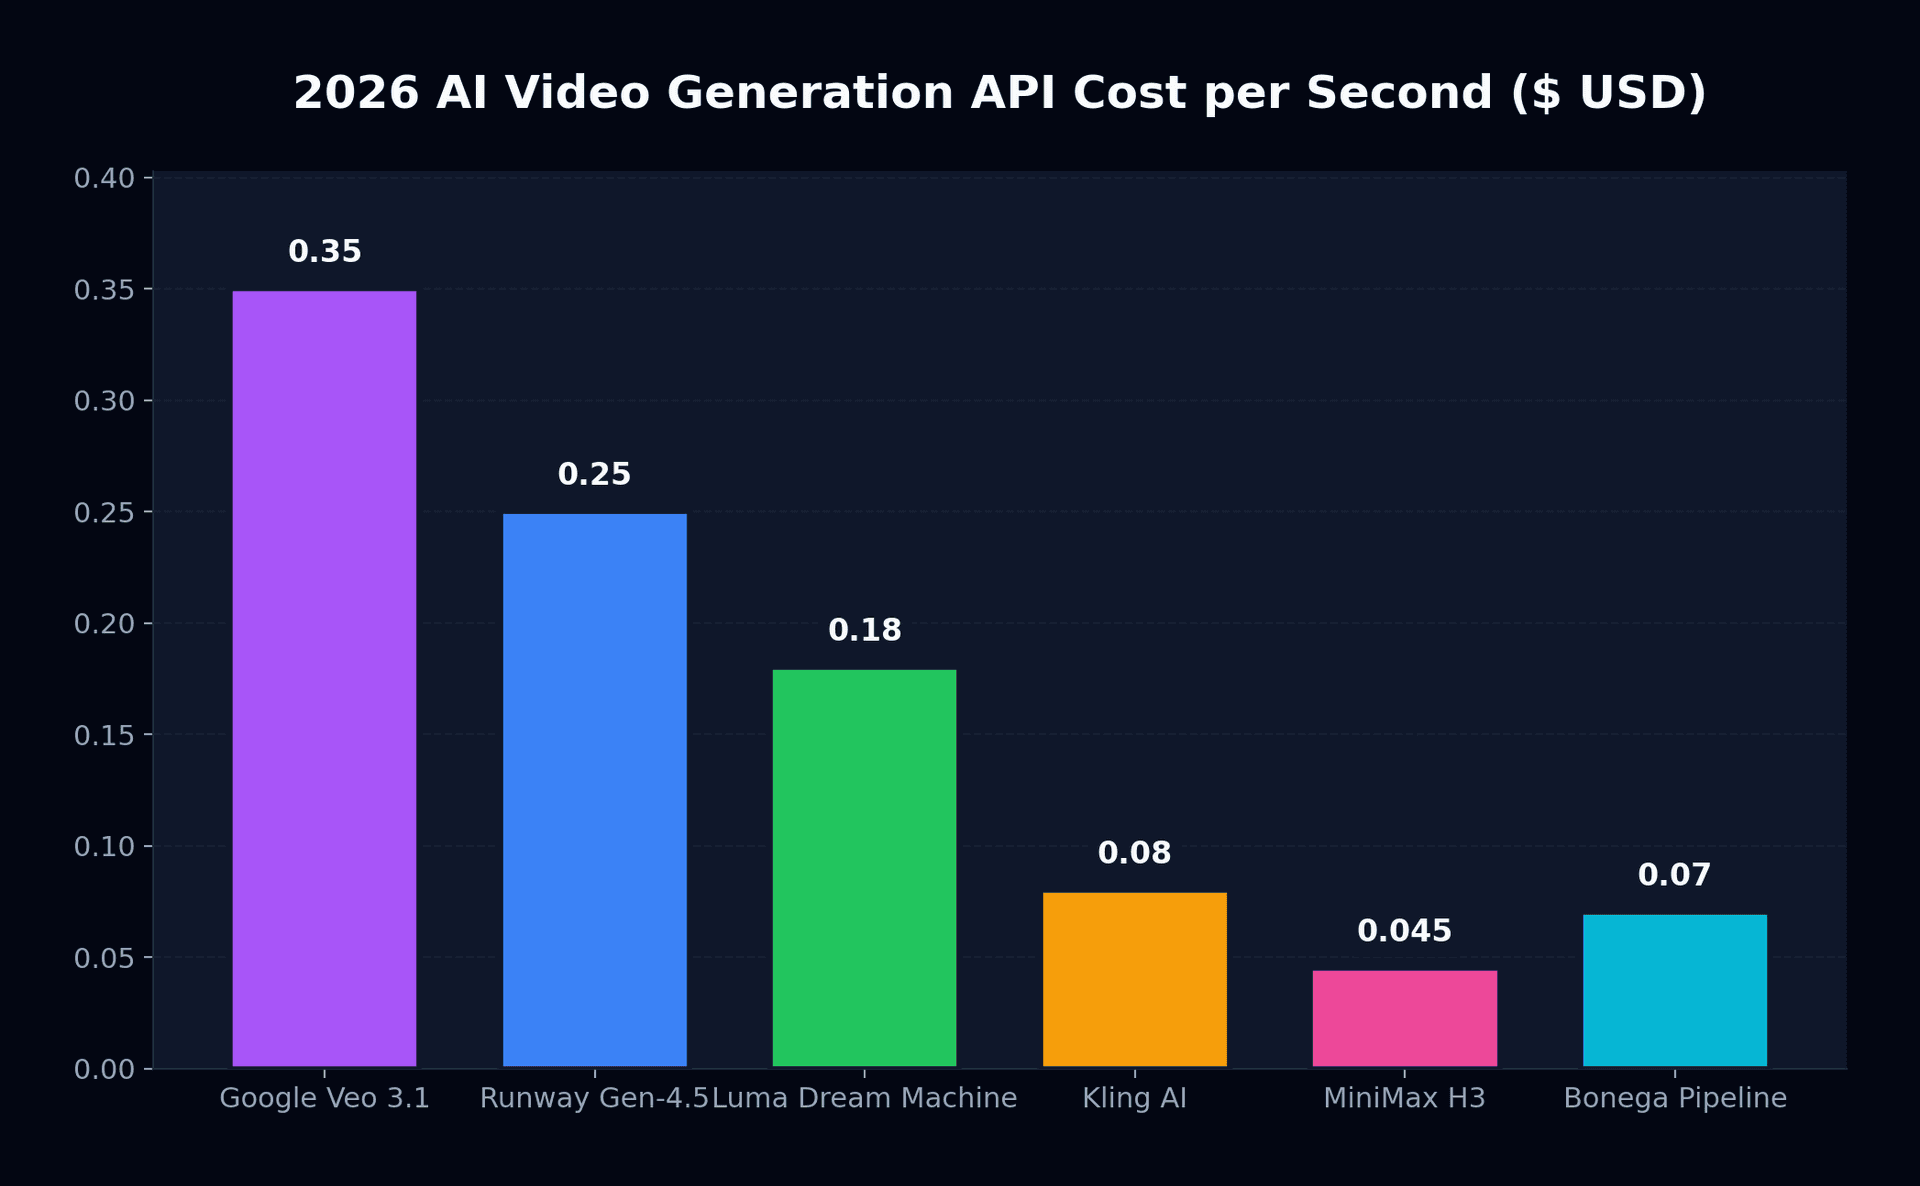
Los precios entre estos motores varían en casi un orden de magnitud. Un creador que genera sesenta segundos de video sin procesar al día en el modo Quality de Veo 3.1 enfrenta un gasto mensual de API superior a $630. Ejecutar ese mismo volumen a través de MiniMax H3 cuesta aproximadamente $81. Sin embargo, el costo por sí solo no determina la utilidad. Una secuencia deportiva de mucha acción colapsa en modelos que carecen de entrenamiento temporal de alta velocidad, mientras que una escena de entrevista corporativa requiere la geometría facial impecable que Kling AI y Veo conservan.
Por qué el texto a video monolítico falla en producción
Cuando los creadores investigan cuál es el mejor generador de video con IA en 2026 para una narrativa continua, los modelos de prompt único suelen quedarse cortos durante las pruebas de producción. La limitación fundamental se reduce a la asignación de tensores. Cuando un algoritmo intenta mapear tokens de lenguaje natural directamente a un volumen latente espacio-temporal tridimensional, debe resolver la geometría espacial y la física temporal simultáneamente.
En la práctica, esto provoca tres modos de fallo predecibles:
- Deriva temporal semántica: El modelo olvida los atributos del sujeto después de dos segundos en pantalla. Los patrones de la ropa cambian, el color de los ojos varía y las joyas desaparecen entre fotogramas.
- Costo de prompt y alucinación: Añadir tokens descriptivos para controlar la arquitectura del fondo a menudo compromete la anatomía del personaje en primer plano, generando manos distorsionadas o ciclos de marcha poco naturales.
- Imposibilidad de un encuadre exacto: Si un director requiere que un actor comience en un plano medio corto y termine en un plano tres cuartos amplio, el condicionamiento por texto no puede imponer restricciones de coordenadas exactas.
Para un análisis más profundo de la evolución de los modelos, explora nuestra reseña sobre la generación de video con Google Veo 3.1 junto con nuestro desglose de las mejores alternativas a Sora en 2026.
La arquitectura multietapa que prioriza la imagen
Los estudios profesionales resolvieron la deriva semántica desacoplando la identidad visual del movimiento temporal. En lugar de pedirle a un único modelo de difusión que invente tanto la escena como su movimiento a partir de palabras, los equipos crean pipelines multietapa.
Etapa 1: Generación de fotogramas clave (Flux / Midjourney / GPT Image)
         └── Alta fidelidad espacial, composición exacta, iluminación fijada
Etapa 2: Condicionamiento de movimiento latente (Difusión de imagen a video)
         └── Vectores temporales aplicados a píxeles sin alterar la identidad
Etapa 3: Superresolución espacial y síntesis de audio
         └── Escalado nativo a 4K y generación sincronizada de Foley
Al generar un primer fotograma fotográfico utilizando herramientas documentadas en las directrices de video de Midjourney o generadores de imágenes especializados, los creadores fijan la identidad del personaje y la iluminación antes de calcular los vectores temporales. El motor de video luego ejecuta la difusión de imagen a video, tratando el fotograma inicial como una condición de contorno inmutable.
Fija la geometría facial, el vestuario y la presencia de marca del producto en el primer fotograma. Reduce las tasas de descarte de generación del 70% a menos del 15%, recortando los costos generales de cómputo de producción.
Sufre una grave mutación de personajes entre tomas. Requiere decenas de iteraciones de prompts para lograr un encuadre aceptable, multiplicando el gasto de créditos de API sin garantizar la repetibilidad.
Documentamos la mecánica de este flujo de trabajo en nuestra guía detallada sobre flujos de trabajo de IA de fotograma a video.
La tesis de la orquestación: por qué elegir un solo modelo es una trampa
En lugar de obsesionarse con cuál es el mejor generador de video con IA en 2026 en una tabla clasificatoria aislada, los equipos empresariales evalúan la eficiencia global del pipeline. Comprometer tu flujo de trabajo con una única plataforma de generación de video introduce fragilidad operativa. Las capacidades de los modelos cambian cada trimestre. Cuando un estudio se suscribe individualmente a cuatro servicios diferentes a un costo de $50 a $200 por puesto cada mes, la sobrecarga operativa supera rápidamente la producción creativa.
Bonega resuelve esta fragmentación funcionando como una capa de orquestación inteligente. En lugar de obligarte a elegir entre Veo 3.1, Runway o MiniMax, Bonega despliega automáticamente el modelo óptimo para cada paso de tu pipeline:
- La síntesis del primer fotograma genera fotogramas clave de alta fidelidad utilizando modelos de imagen fotorrealistas, fijando la composición y la identidad del personaje.
- La animación del movimiento dirige el fotograma clave al motor óptimo de imagen a video según la complejidad del movimiento y la relación de aspecto deseada.
- La extensión de duración une clips cortos en secuencias narrativas coherentes mediante algoritmos automatizados de coincidencia de fotogramas.
Puedes probar este pipeline directamente visitando nuestro espacio de trabajo de creación de texto a video, o revisar los planes en la página de precios de Bonega, a partir de $9 mensuales con una prueba de 3 días. Si tu proyecto exige clips continuos más allá de los límites habituales de diez segundos de los modelos, consulta nuestra completa guía para extender video con IA.
Marco de decisión: ¿qué generador de video con IA deberías elegir?
Resolver cuál es el mejor generador de video con IA en 2026 para tu pipeline específico se reduce a cinco escenarios de producción distintos:
- Implementa Google Veo 3.1 a través de la documentación de la API de Google Gemini si requieres una resolución 4K lista para emisión con diálogos nativos simultáneos y sonido ambiental, y tu presupuesto admite $0.35 por segundo.
- Recurre a Runway Gen-4.5 si tu proyecto requiere rutas precisas de movimiento de cámara, cuadrículas de director y control editorial especializado de posproducción.
- Selecciona MiniMax Hailuo H3 al crear variaciones programáticas de anuncios o videos para redes sociales de alta acción al máximo volumen, donde la economía unitaria de $0.045 por segundo sea crítica.
- Confía en Kling AI 2.0 para el realismo facial humano, microexpresiones complejas y una sincronización labial natural en el centro de tu narrativa.
- Opta por Bonega para obtener pipelines multietapa automatizados que combinan el fotorrealismo de fotogramas clave con movimiento dinámico, eliminando la necesidad de gestionar suscripciones individuales a modelos o wrappers de API.
Fuentes
- Precios de Google Cloud Vertex AI (Google Cloud)
- Documentación de generación de video con la API de Google Gemini (Google AI)
- Directrices de generación de video de Midjourney (Midjourney)
Preguntas Frecuentes
- ¿Cuál es el mejor generador de video con IA en 2026?
- Ningún motor individual lidera en todos los criterios comerciales. Veo 3.1 ofrece una claridad cinematográfica en 4K inigualable con efectos Foley integrados, Runway Gen-4.5 destaca en navegación espacial de cámara y Hailuo H3 proporciona movimiento dinámico a un costo ultrabajo. Para una continuidad de escena fiable, los pipelines multietapa que vinculan fotogramas clave estáticos con modelos de movimiento superan sistemáticamente a los prompts monolíticos.
- ¿Cuánto cuesta la generación profesional de video con IA en 2026?
- Las tarifas de las API comerciales varían entre cuatro centavos y medio por segundo en motores asiáticos ligeros y hasta treinta y cinco centavos por segundo en los modos de alta fidelidad de Google. Las suscripciones típicas para creadores oscilan entre $76 y $249 al mes. Los pipelines modulares promedian siete centavos por segundo renderizando imágenes fijas impecables y animando fotogramas seleccionados.
- ¿Por qué imagen a video es mejor que texto a video para la consistencia?
- El prompting directo de texto obliga a las redes neuronales a fabricar simultáneamente la identidad del personaje, la iluminación del fondo, la composición y la física temporal a partir de palabras. Esto crea una grave deformación del personaje entre cortes. Introducir una imagen de referencia prerrenderizada fija la identidad y la geometría, restringiendo la red de difusión puramente a calcular vectores de movimiento fluidos.
- ¿Pueden los generadores de video con IA producir efectos de sonido y diálogos sincronizados?
- Las arquitecturas avanzadas de difusión ahora generan voz sincronizada, paisajes sonoros ambientales y audio Foley mecánico a la par con los fotogramas visuales. Esta capacidad elimina la posproducción de audio secundaria para recursos sociales breves, aunque la composición orquestal compleja o la masterización de voz en off aún depende de estaciones de trabajo de audio externas especializadas.