הפעלת וידאו בינה מלאכותית מקומית: LTX-2, RTX ו-ComfyUI בשנת 2026
הפעלת LTX-2 באופן מקומי עם ComfyUI: מינימום RTX 4060 (8 GB), מומלץ 24 GB VRAM, התקנה שלב אחר שלב והשוואת עלויות מול כלי ענן.
 Damien9 min read
כותב AI, בדיקות אוטומטיות, עורך אחראי
מודל הקוד הפתוח LTX-2, שפותח על ידי Lightricks בשיתוף עם NVIDIA, מייצר כעת עד 20 שניות של וידאו 4K ב-50 FPS על גבי כרטיס מסך צרכני יחיד. ללא ענן. ללא מנוי. ללא שום נתונים שעוזבים את המחשב שלך.
ב-CES 2026, NVIDIA הדגימה את LTX-2 פועל באופן מקורי על סדרת RTX 50 החדשה, והתוצאות הותירו את הקהל פעור פה. זו לא הייתה הדגמת מחקר. זו הייתה יצירת וידאו מקומית מוכנה לסביבת עבודה מקצועית, הפועלת במהירויות שמתחרות בשירותי ענן.
בוא נעבור על מה זה אומר, מה דרוש לך, וכיצד להגדיר זאת.
מדוע יצירת וידאו מקומית בבינה מלאכותית חשובה
לפני שנצלול להגדרה הטכנית, אסביר מדוע הפעלת וידאו בינה מלאכותית באופן מקומי אינה רק העדפה של חובבים. היא פותרת בעיות אמיתיות.
מנויים חודשיים ($20-100/חודש), נתונים מועלים לשרתי צד שלישי, תלות באינטרנט, תורי יצירה בשעות שיא, אפשרויות התאמה אישית מוגבלות
השקעה חד-פעמית בחומרה, פרטיות נתונים מלאה, עובד ללא חיבור לרשת, ללא זמני המתנה בתור, התאמה אישית מלאה של המודל באמצעות אימון LoRA, יצירות ללא הגבלה
עבור סטודיואים שמטפלים בחומרי גלם של לקוחות, פרטיות אינה מותרות. עבור יוצרים באזורים עם חיבור אינטרנט איטי, יצירה בענן אינה מעשית. ועבור כל מי שמייצר מאות קליפים בחודש, תחשיב המנויים מפסיק להיות משתלם מהר מאוד.
מה נחוץ לך: דרישות חומרה
הנה הפירוט האמיתי. יצירה מקומית דורשת חומרה מכובדת, אך כנראה לא קיצונית כפי שחשבת.
| רכיב | מינימום | מומלץ | אופטימלי |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| אחסון | 50 GB פנויים ב-SSD | 200 GB NVMe | 500 GB NVMe |
| מערכת הפעלה | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
השוואת ביצועי כרטיסי מסך
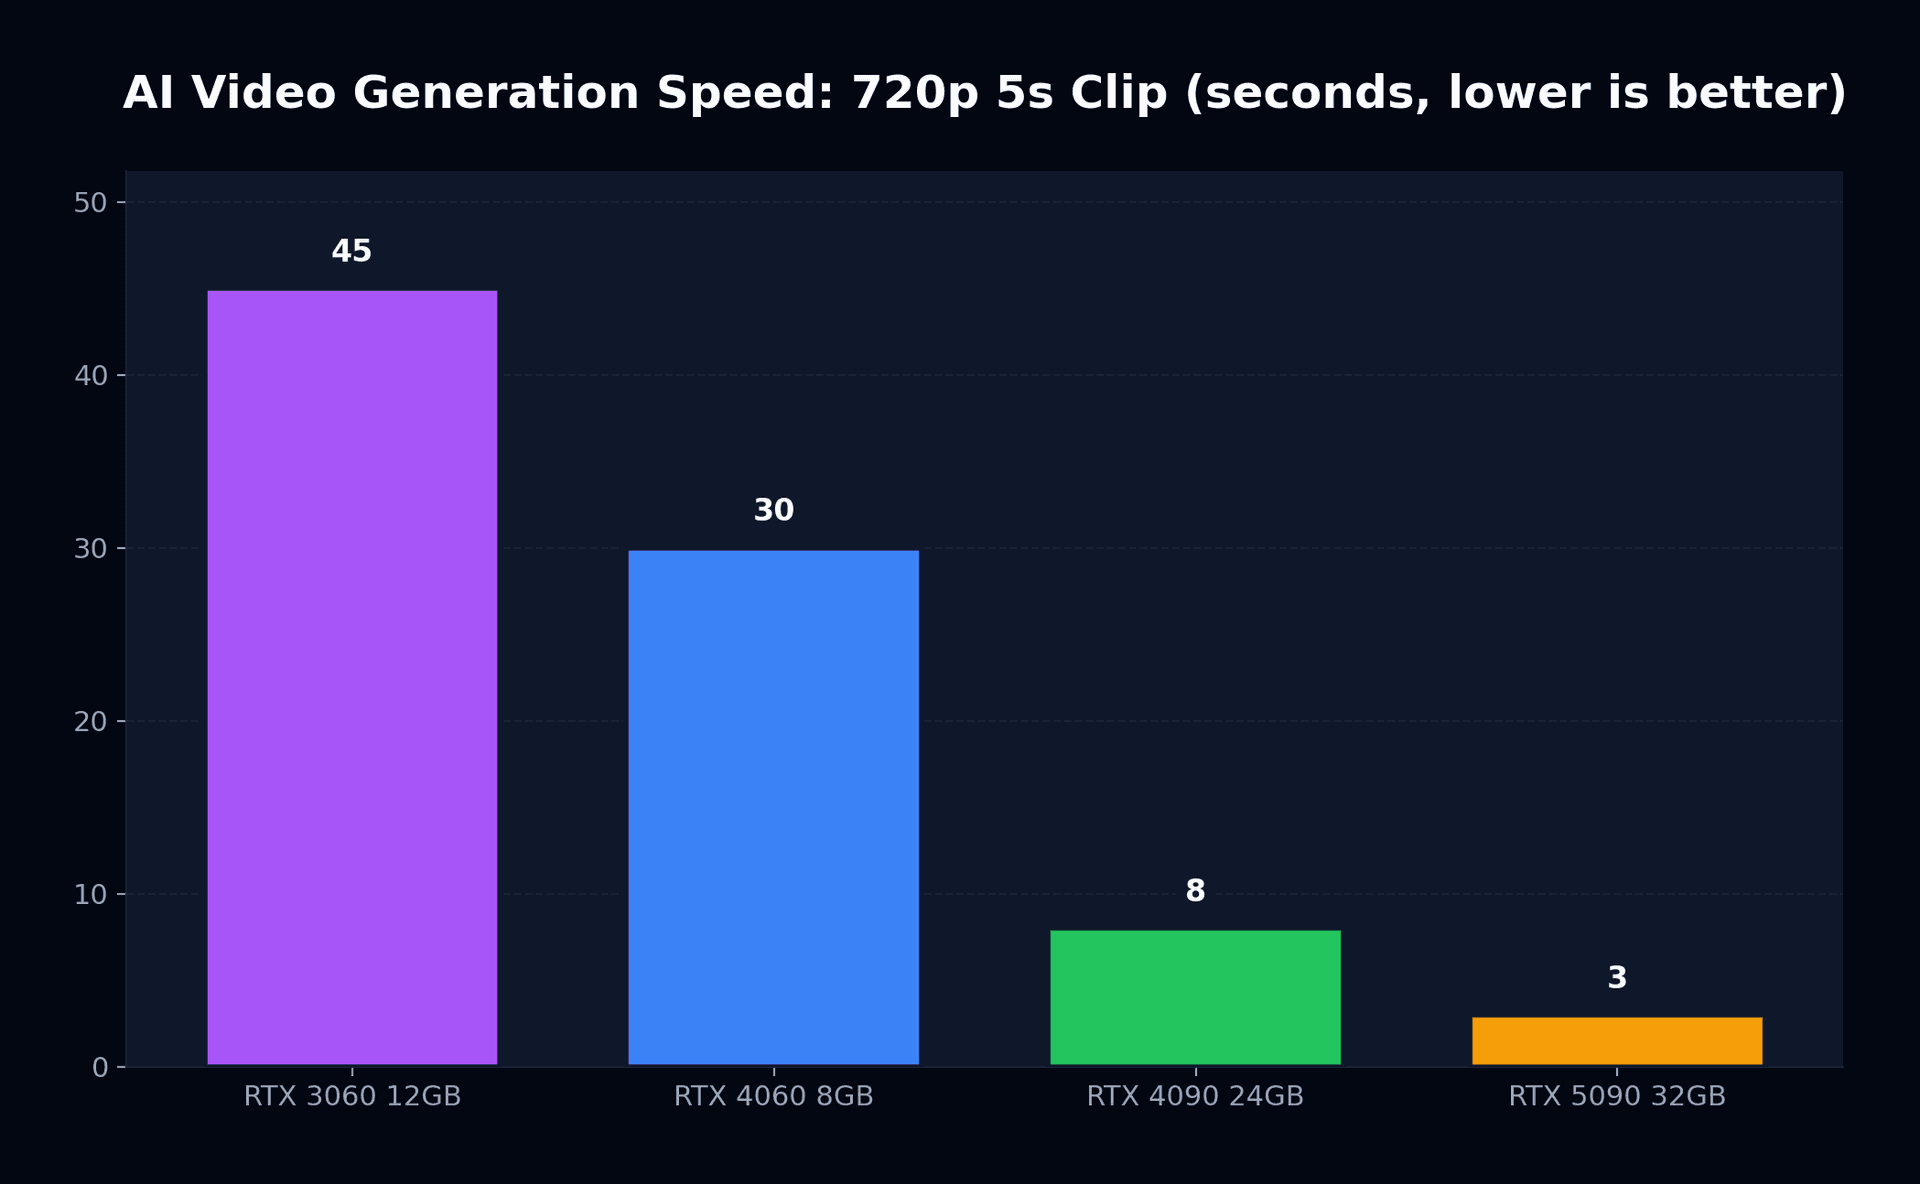
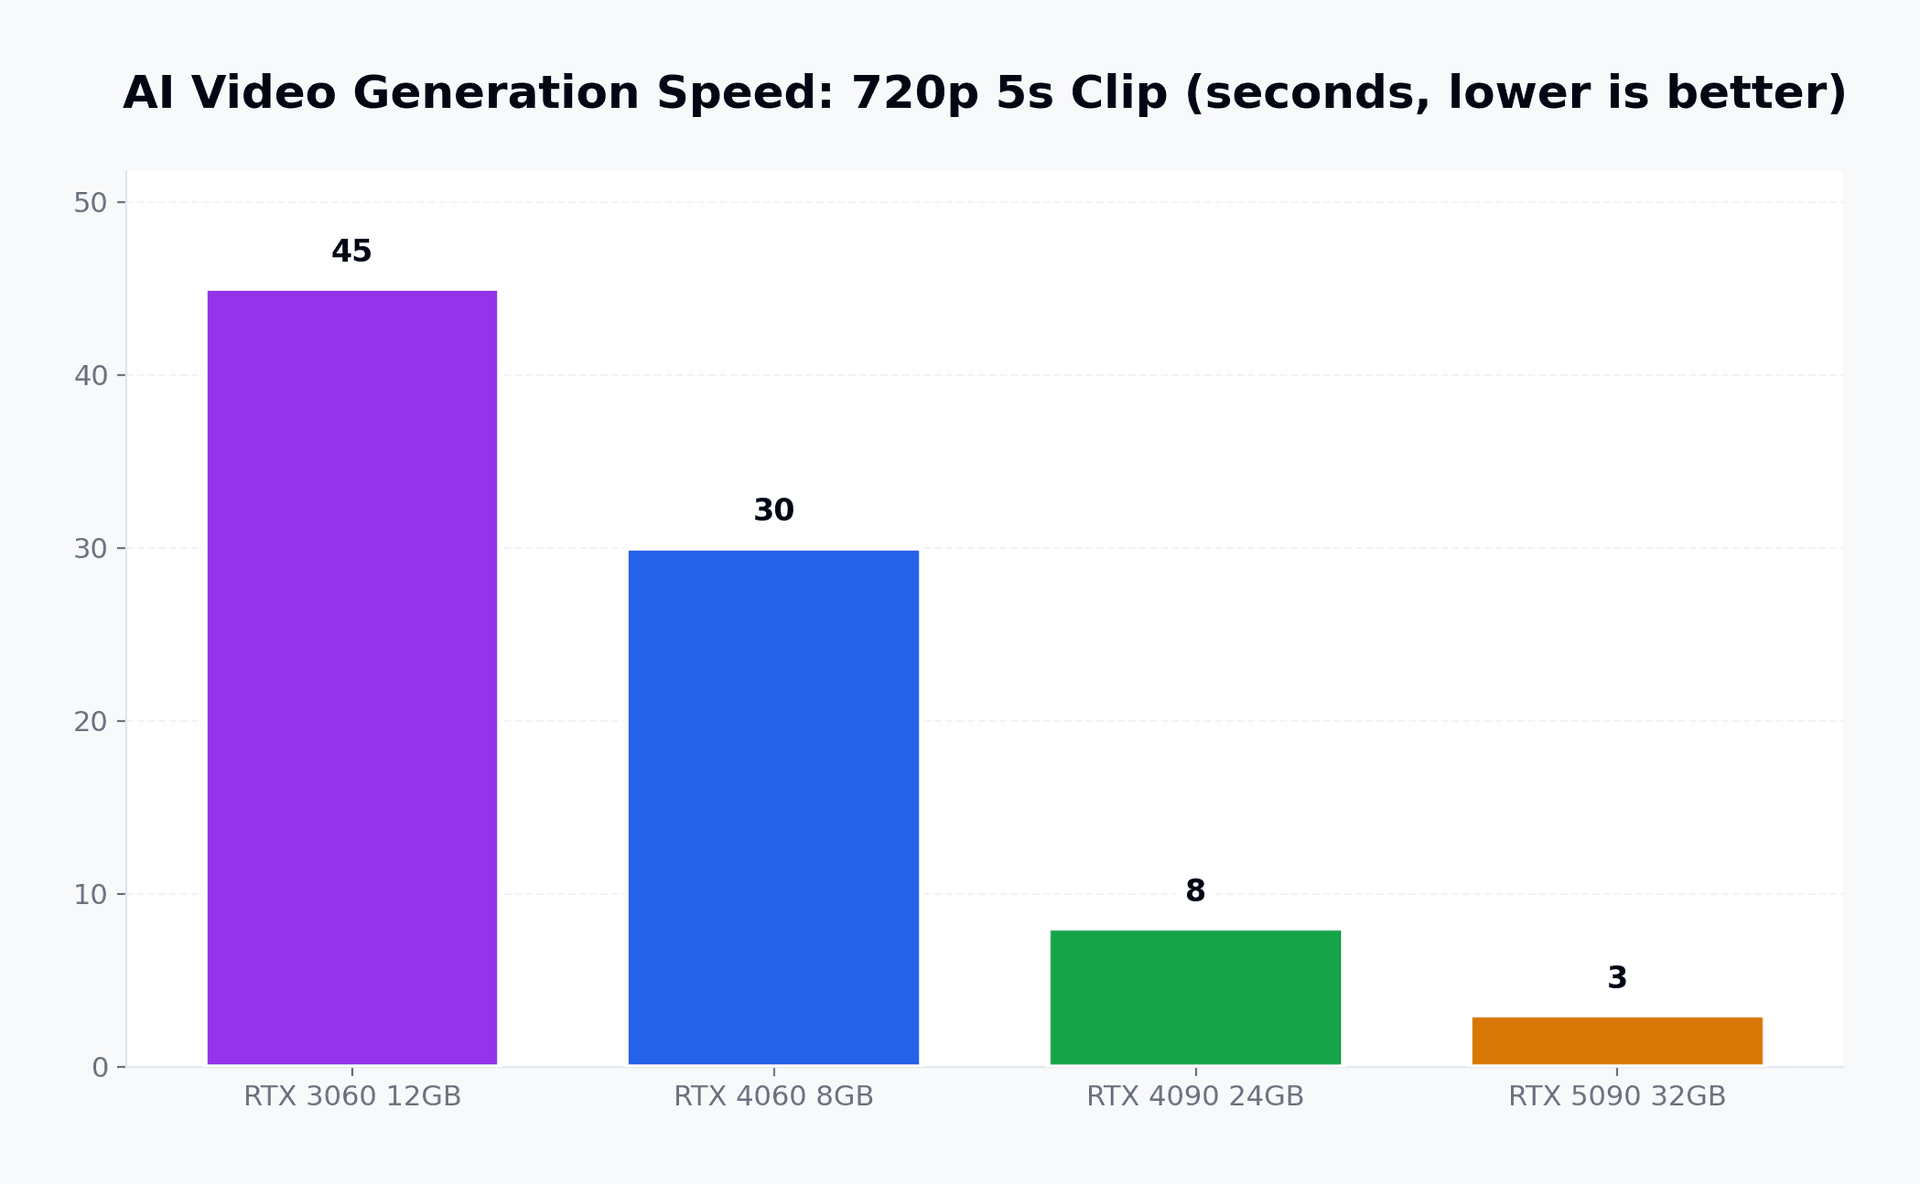
פערי הביצועים בין הדורות דרמטיים. הנה מה ש-NVIDIA הדגימה ב-CES 2026:
| GPU | 720p (קליפ של 5 שניות) | 1080p (קליפ של 5 שניות) | 4K (קליפ של 5 שניות) | שימוש ב-VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 שניות | ~90 שניות | אינו נתמך | 11 GB |
| RTX 4060 8 GB | ~30 שניות | ~60 שניות | אינו נתמך | 7.5 GB |
| RTX 4090 24 GB | ~8 שניות | ~15 שניות | ~45 שניות | 18 GB |
| RTX 5090 32 GB | ~3 שניות | ~6 שניות | ~15 שניות | 20 GB |
סדרת RTX 50 מגיעה למהירות גבוהה פי 3 באמצעות קוונטיזציית NVFP4 מובנית, החוצה את דיוק משקולות המודל ללא ירידה נראית לעין באיכות. זהו אותו טריק שהפך מודלי שפה גדולים למעשיים על חומרת צרכנים, המיושם כעת על מודלי דיפוזיה של וידאו.
LTX-2: מה הופך אותו למיוחד
LTX-2 אינו סתם "עוד מודל קוד פתוח". הוא מייצג שינוי יסודי במה שאפשרי בחומרת צרכנים.
עד 20 שניות ב-4K 50 FPS
יצירת אודיו מובנית
שליטה בריבוי פריימי מפתח (Keyframes)
התאמה אישית מבוססת LoRA
שילוב עם ComfyUI
כיצד הוא עומד בהשוואה לשירותי ענן
בוא נהיה ספציפיים לגבי מה שיצירה מקומית מסוגלת או אינה מסוגלת לבצע בהשוואה לפלטפורמות הענן הגדולות.
| תכונה | LTX-2 (מקומי) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| רזולוציה מרבית | 4K | 1080p | 4K | 1080p |
| משך מרבי | 20 שניות | 20 שניות | 8 שניות | 10 שניות |
| אודיו | מובנה | נפרד | מקורי | נפרד |
| פרטיות | מלאה | ענן | ענן | ענן |
| עלות חודשית | $0 | $20-200 | $20-50 | $15-100 |
| התאמה אישית | מלאה (LoRA) | מוגבלת | מוגבלת | בינונית |
| מהירות (1080p, 5 שניות) | 6-60 שניות (תלוי ב-GPU) | 30-120 שניות | 15-60 שניות | 20-90 שניות |
הפשרה ברורה: שירותי ענן מציעים תוצאות מלוטשות יותר עם פחות הגדרות, בעוד שיצירה מקומית מעניקה לך שליטה, פרטיות, ואפס עלות שולית לכל יצירה. למבט מעמיק יותר על השוואת פלטפורמות הענן הללו, עיין בהשוואת Sora 2 מול Runway מול Veo 3.
הגדרת LTX-2 עם ComfyUI: שלב אחר שלב
הנה המדריך המעשי. נקודת ההנחה היא שיש לך כרטיס מסך של NVIDIA עם לפחות 8 GB של VRAM ודרייבר עדכני מותקן.
שלב 1: התקנת ComfyUI
ComfyUI הוא ממשק חזותי מבוסס צמתים למודלי דיפוזיה. אפשר לחשוב עליו כמו מערכת ה-Blueprints של Unreal Engine, אך עבור תהליכי עבודה של יצירת בינה מלאכותית.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
שלב 2: הורדת מודל LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
שלב 3: התקנת הרחבת LTX-2 עבור ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
שלב 4: הפעלה ויצירה
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
פתח את http://127.0.0.1:8188 בדפדפן שלך. טען את תהליך העבודה של LTX-2 מתיקיית הדוגמאות של ההרחבה, הקלד את ההנחיה שלך, ולחץ על "Queue Prompt".
אופטימיזציה של ההגדרות שלך
לאחר שההתקנה הבסיסית עובדת, הנה טריקים של כוונון שעושים הבדל אמיתי.
ניהול VRAM
צוואר הבקבוק המשמעותי ביותר ביצירה מקומית הוא VRAM. הנה כיצד למקסם את מה שיש לך:
- ✓הפעלת פריקת מודל (העברת שכבות שאינן בשימוש לזיכרון ה-RAM של המערכת)
- ✓שימוש בקוונטיזציית NVFP8/NVFP4 עבור דור כרטיס המסך שלך
- ✓סגירת לשוניות דפדפן ויישומים אחרים הזוללים משאבי GPU
- ✓הגדרת Windows ל-"תזמון GPU עם האצת חומרה" בהגדרות התצוגה
- ✓שקילת אתחול כפול עם Linux (ניצול GPU טוב יותר ב-5-10% לעומת Windows)
זרימת עבודה של עיבוד באצוות (Batch Processing)
עבור יוצרים שצריכים לייצר קליפים רבים, ComfyUI תומך בהעמדה בתור באצוות. הגדר את ההנחיות שלך בקובץ JSON, חבר אותן לצומת טעינת אצווה, ותן לכרטיס המסך שלך לעבוד במשך הלילה.
אימון LoRA עבור סגנונות מותאמים אישית
כאן יצירה מקומית זורחת באמת. באפשרותך לאמן מתאם LoRA על 50-100 פריימים של חומר ייחוס תוך כ-30 דקות על גבי RTX 4090. התוצאה היא קובץ קל משקל (בדרך כלל 100-300 MB) המכוון את המודל לכיוון הסגנון החזותי הספציפי שלך, מראה הדמויות, או האסתטיקה של הסביבה.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
חישוב העלויות
בוא נציג לכך מספרים קונקרטיים. נניח שאתה יוצר וידאו עצמאי שמייצר 100 קליפים של חמש שניות בחודש.
| גישה | עלות חודשית | עלות שנתית | פרטיות |
|---|---|---|---|
| Sora 2 Pro | $100/חודש | $1,200/שנה | ענן |
| Runway Standard | $76/חודש | $912/שנה | ענן |
| Veo (Google AI Pro) | $50/חודש | $600/שנה | ענן |
| LTX-2 + RTX 4090 | ~$15/חודש (חשמל) | ~$180/שנה | מלאה |
כרטיס RTX 4090 עולה בסביבות $1,600 במחיר מומלץ לצרכן, אם כי מחירי השוק הנוכחיים נעים קרוב יותר ל-$2,500-2,800 בשל הפסקת הייצור. בחישוב של 100 קליפים בחודש בשירותי ענן, אפילו במחיר השוק כרטיס המסך מחזיר את עלותו בתוך 18-24 חודשים, ולאחר מכן היצירה עולה לך רק כמחיר החשמל.
מה צופן העתיד
המסלול של יצירת וידאו מקומית בבינה מלאכותית מאיץ. שלוש התפתחויות שכדאי לעקוב אחריהן:
שחרור LTX-2.1
פלטפורמת NVIDIA Rubin
Meta Mango (פוטנציאל לקוד פתוח)
השורה התחתונה
שירותי וידאו בינה מלאכותית בענן הם מוצרים מצוינים. Sora, Veo, Runway, כולם מספקים תוצאות מרשימות בהגדרה מינימלית. אך הם מגיעים עם פשרות שיוצרים רבים מתחילים לראות כבלתי מקובלות: עלויות חוזרות, חששות פרטיות, תלות באינטרנט והתאמה אישית מוגבלת.
LTX-2 עם ComfyUI על גבי כרטיס NVIDIA RTX אינו פשרה. זהו פרדיגמה שונה. כזו שבה כל תהליך העבודה בבעלותך, ממשקולות המודל ועד לפלט הסופי. ההגדרה אורכת שעות ספורות אחר הצהריים. עקומת הלמידה קיימת אך ניתנת לניהול. והתוצאות, במיוחד ב-4K עם האופטימיזציות האחרונות, תחרותיות לחלוטין מול החלופות בענן.
אם יש לך כרטיס מסך RTX שצובר אבק בין סבבי גיימינג, תן לו עבודה שנייה. ייתכן שתופתע ממה שהוא מסוגל לעשות.
קריאה נוספת: למידע נוסף על תנועת הווידאו מבוסס הבינה המלאכותית בקוד פתוח, עיין במהפכת הווידאו בינה מלאכותית בקוד פתוח ובסקירה המעמיקה הקודמת שלנו על יצירת 4K מקורית ב-LTX-2. מתעניין בתמונה הרחבה יותר? ראה מהפכת ה-$10 של וידאו בינה מלאכותית: כיצד כלים תקציביים מאתגרים את הענקים.