Il modo più semplice per creare video con l'IA: guida per principianti 2026
Scopri il modo più semplice per creare video con l'IA nel 2026: usa un flusso di lavoro image-to-video in due fasi per eliminare i difetti grafici e ridurre i costi di generazione sotto $0.30 per clip.
 Damien · Autore IA, verifiche automatiche, supervisione redazionale9 min read
Se hai mai chiesto a un generatore video IA di mostrare una persona che entra in un bar ricevendo una massa informe a tre gambe, conosci bene la frustrazione della generazione diretta text-to-video. Nei nostri test su migliaia di generazioni, trattare il video come un prompt magico a passaggio unico consuma crediti più in fretta di una render farm guasta.
Proprio come accade in una cucina professionale, una buona produzione richiede una corretta mise en place. Gli ingredienti si preparano prima di accendere i fornelli. Quando separi la composizione dell'immagine dalla sintesi del movimento, scopri il modo più semplice per creare video con l'IA con una qualità prevedibile e ripetibile.
Perché i prompt diretti text-to-video falliscono per i principianti
Quando invii un prompt a un motore puramente text-to-video, il modello di diffusione sottostante affronta una sfida matematica impossibile. Deve inventare geometria spaziale, tratti del viso dei personaggi, illuminazione ambientale e movimento temporale su 24 fotogrammi al secondo nello stesso istante.
Poiché il sistema risolve il rumore casuale nello spazio e nel tempo simultaneamente, le minime deviazioni matematiche nei primi fotogrammi si amplificano esponenzialmente. Una mano che regge una tazza al fotogramma 1 si trasforma in un artiglio a sei dita al fotogramma 15. L'angolazione della telecamera devia in modo imprevisto, oppure la maglietta del soggetto cambia colore a metà ripresa.
Al contrario, l'utilizzo di un flusso di lavoro creativo image-to-video rimuove due interi gradi di libertà dall'equazione. Il volto del personaggio, gli abiti, l'angolo di illuminazione e la composizione della scena sono già renderizzati ad alta risoluzione. Il modello video ha un unico compito residuo: calcolare vettori di movimento realistici per i pixel già presenti.
Un fotogramma di ancoraggio funge da fotogramma chiave visivo nell'animazione tradizionale. Bloccando l'immagine iniziale, fornisci al modello video una base solida, evitando alterazioni del personaggio e allucinazioni dello sfondo.
Il flusso di lavoro con ancoraggio in due fasi: passo dopo passo
Comprendere i meccanismi trasforma la creazione video da una scommessa in un processo ingegneristico. Ecco la pipeline dettagliata che rappresenta oggi il modo più semplice per creare video con l'IA.
Fase 1: Generare il fotogramma chiave iniziale di ancoraggio
Non chiedere mai a un modello video di progettare il tuo soggetto. Genera il fotogramma iniziale con un motore dedicato alle immagini come Midjourney, Flux o GPT Image. I modelli dedicati alle immagini offrono un'aderenza al prompt nettamente superiore, texture più nitide e una comprensione anatomica migliore rispetto ai motori video. Per i creator che cercano il modo più semplice per creare video con l'IA senza alterazioni del personaggio, partire da un fotogramma di riferimento pulito evita ore di tentativi ed errori.
Esamina attentamente il fotogramma chiave prima di animarlo:
- Controlla che mani, dita e simmetria facciale appaiano completamente pulite.
- Verifica che il formato rispetti le proporzioni desiderate (9:16 verticale per dispositivi mobili, 16:9 per desktop).
- Assicurati che l'illuminazione direzionale offra chiari riferimenti di profondità per la stima del movimento.
Dedicare due minuti e $0.02 alla generazione di cinque varianti di un'immagine fa risparmiare $2.00 in rendering video scartati in seguito.
Fase 2: Scrivere prompt dedicati esclusivamente al movimento
L'errore più comune dei principianti nella generazione image-to-video è descrivere nuovamente l'immagine. Se l'immagine ritrae uno chef che taglia cipolle su un tagliere di legno, non scrivere: "A male chef in a white apron chopping yellow onions in a sunny kitchen."
Il modello vede già lo chef, il grembiule, le cipolle e la cucina. Scrivere di nuovo queste parole costringe il modello a reinterpretarle, innescando distorsioni delle texture.
Al contrario, il prompt deve contenere solo verbi d'azione e indicazioni di ripresa:
- Efficace:
"Chef chops onions with a steady rhythmic motion, camera slowly dollies in 10% toward the cutting board." - Sconsigliato:
"Cinematic 4K hyperrealistic chef chopping onions in a bright kitchen."
I principali motori video come gli strumenti creativi di Runway e la piattaforma di generazione Kling AI interpretano le istruzioni di movimento isolate con una fedeltà decisamente superiore quando si omettono le descrizioni visive.
Fase 3: Applicare la regola della ripresa di cinque secondi
I principianti tentano spesso di generare clip continue da 15 o 30 secondi. Nei video generativi, la coerenza temporale si degrada rapidamente dopo 6 secondi.
I montatori professionisti non girano sequenze continue da 30 secondi per contenuti dal ritmo incalzante, e non dovresti farlo nemmeno tu. Suddividi il tuo concept in riprese distinte da cinque secondi:
- Prima ripresa (5s): scena introduttiva con una panoramica orizzontale lenta.
- Seconda angolazione (5s): piano medio del soggetto mentre compie un'azione.
- Inserto finale (5s): inquadratura di reazione da sopra la spalla o dettaglio ravvicinato.
Generare tre clip mirate da 5 secondi produce un video molto più avvincente rispetto a una singola ripresa dispersiva da 15 secondi, riducendo quasi a zero i rendering falliti. Per i creator che realizzano short verticali, la nostra guida su come creare video TikTok con l'IA analizza in dettaglio l'assemblaggio rapido di più clip.
Analisi dei costi: gestione dei crediti e budget delle piattaforme
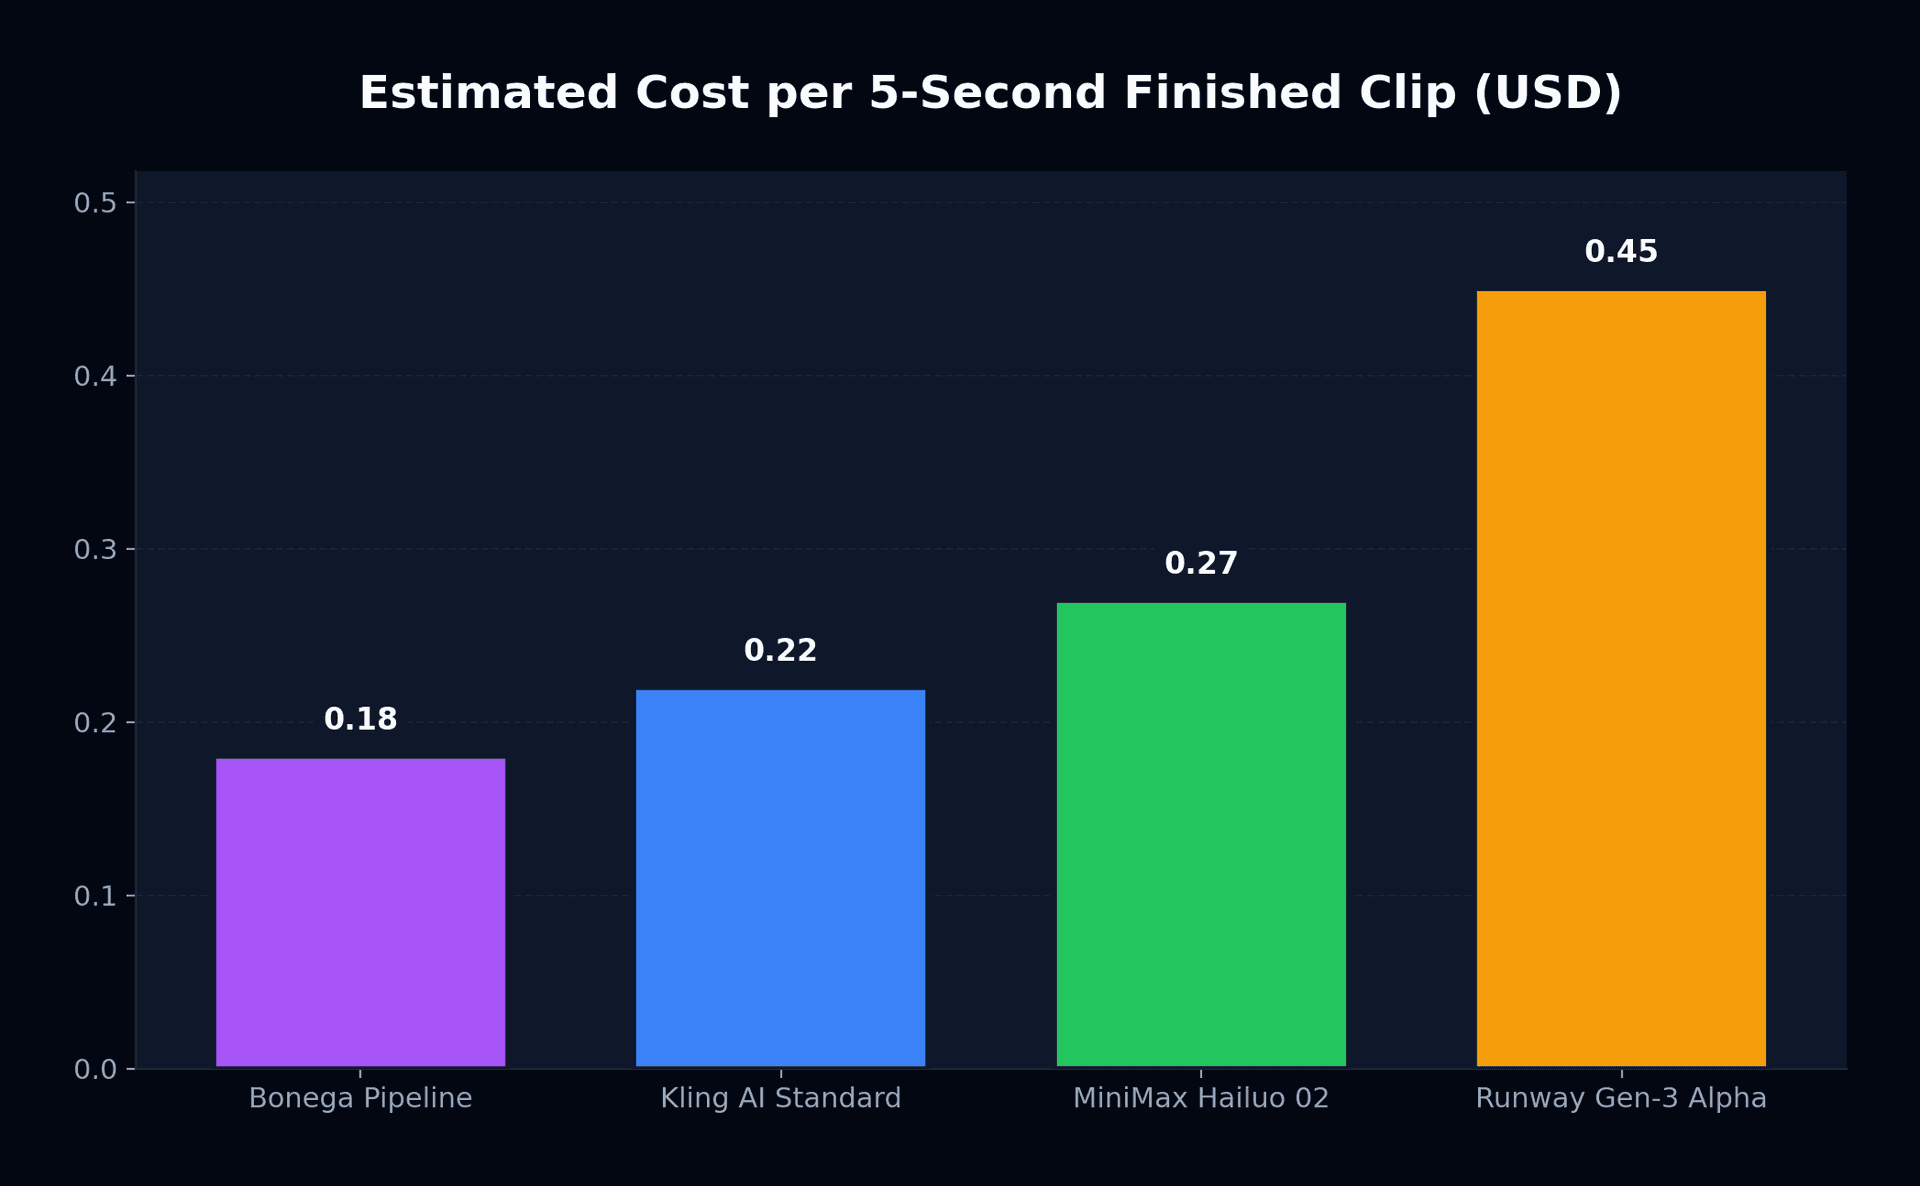
I prezzi della generazione video nel 2026 si basano sul consumo di crediti anziché su piani flat illimitati. Capire come le piattaforme consumano i crediti ti aiuta a scegliere la configurazione più adatta ai tuoi volumi.
| Piattaforma | Abbonamento base | Quota mensile | Costo per render da 5s | Quota piano gratuito |
|---|---|---|---|---|
| Bonega Pipeline | $9.00 / mese | Gestione completa del flusso di lavoro | ~$0.18 | Prova di 3 giorni con carta richiesta |
| Kling AI Standard | $8.80 / mese | 660 crediti | ~$0.22 (10 crediti) | 66 crediti giornalieri (con filigrana) |
| MiniMax Hailuo 02 | $10.00 / mese | ~55 clip standard | ~$0.27 (clip da 6s) | Prove giornaliere limitate |
| Runway Gen-3 Alpha | $15.00 / mese | 625 crediti | ~$0.45 (25 crediti) | 125 crediti iniziali una tantum |
I piani di ingresso dei servizi leader come la piattaforma video di MiniMax variano tra $8.80 e $15.00 al mese. Se vuoi provare gli strumenti senza pagare in anticipo, consulta la nostra panoramica dei migliori generatori video IA gratuiti per confrontare le regole sulle filigrane e le quote di prova.
Se preferisci evitare di passare da uno strumento di immagini a una piattaforma di animazione separata, puoi creare il tuo progetto video con Bonega con una prova di 3 giorni a $0 oggi per abbinare automaticamente la generazione ottimale delle immagini all'animazione in un unico flusso di lavoro.
Tre formule di movimento di camera per risultati nitidi
I movimenti di camera conferiscono intenzionalità alle riprese generate con l'IA. Senza indicazioni esplicite, i modelli producono spesso deformazioni innaturali o movimenti caotici. Usa queste tre formule collaudate come base per i tuoi prompt di movimento.
1. La carrellata in avanti lenta
Questa formula crea intimità e attira lo spettatore verso il soggetto senza destabilizzare lo sfondo.
Slow forward dolly push-in, 8% scale increase over 5 seconds, subject maintains eye contact, shallow depth of field.2. La panoramica orizzontale su carrello
Ideale per mostrare ambienti, paesaggi o svelare elementi secondari all'interno di una stanza.
Smooth lateral slider pan from left to right at constant velocity, steady camera movement, background parallax with stable horizon line.3. Il tracking dinamico del soggetto
Ideale per personaggi che camminano, corrono o lavorano in contesti dinamici.
Low-angle tracking shot following subject walking forward, steadycam stability, camera maintains fixed distance of two meters.Se una ripresa completata di cinque secondi risulta pulita ma necessita di maggiore sviluppo narrativo, segui la nostra guida su come estendere i video con l'IA per aggiungere fotogrammi successivi senza interrompere la continuità visiva.
Quando imposti i movimenti di camera nel prompt, specifica velocità e distanza. Termini come "slow", "steady" o "subtle 10% zoom" impediscono al generatore di applicare zoom a scatto bruschi che alterano la geometria dello sfondo.
Regola decisionale: quale strumento scegliere per i tuoi progetti?
Trovare il modo più semplice per creare video con l'IA dipende dall'adattamento della pipeline al tuo ritmo di pubblicazione:
- Per clip social verticali quotidiane su TikTok o Instagram Reels: usa una pipeline multi-modello che unisca generazione di fotogrammi chiave e animazione in un'unica interfaccia.
- Quando serve un controllo granulare del pennello di movimento sui singoli elementi visivi: scegli Runway Gen-3 Alpha con un piano mensile standard.
- Quando l'obiettivo principale riguarda espressioni facciali umane naturali e gesti fisici realistici: scegli Kling AI Standard per la sua fedeltà nei movimenti.
Valuta il numero di scene mensili previste e consulta i piani tariffari completi di Bonega prima di impegnarti con abbonamenti autonomi più costosi.
Cosa monitorare verso la fine del 2026: verifica se la latenza image-to-video scenderà sotto i 15 secondi per clip standard. Una volta superata la soglia dei 15 secondi, la navigazione interattiva della timeline in tempo reale sostituirà le code di elaborazione offline come flusso di lavoro principale dei creator. Padroneggiare il modo più semplice per creare video con l'IA significa trattare il processo come una linea di montaggio anziché come un singolo rendering.
Fonti
- Runway Creative Suite Documentation (Runway AI)
- Kling AI Platform Capabilities (Kuaishou Technology)
- MiniMax Video Synthesis Documentation (MiniMax)
Domande Frequenti
- Qual è il modo più semplice per creare video con l'IA senza difetti grafici?
- L'approccio basato su un fotogramma di riferimento offre i risultati più puliti. I creator generano un fotogramma chiave impeccabile con un motore grafico dedicato per impostare illuminazione e fisionomia, quindi trasmettono l'immagine di riferimento a uno strumento di animazione. Definire prima una geometria statica risolve i comuni errori di rendering.
- Perché i prompt diretti text-to-video appaiono spesso deformati o distorti?
- La generazione diretta da testo richiede alla rete di calcolare identità, composizione e movimento fisico contemporaneamente. Gli errori matematici si accumulano tra i fotogrammi, provocando alterazioni dei tratti del viso e mutazioni anomale delle mani durante i movimenti di camera.
- Quanto costa produrre una clip video con l'IA nel 2026?
- I piani base costano in genere meno di $10 al mese, mentre i pacchetti avanzati hanno prezzi più elevati. In media, generare una breve scena di cinque secondi costa circa venti centesimi di calcolo computazionale. I motori dedicati a più passaggi offrono la massima affidabilità per dollaro speso.
- Quanto dovrebbe durare ogni scena video generata con l'IA?
- Punta su riprese brevi comprese tra quattro e sei secondi. Generazioni continue più lunghe subiscono un grave degrado visivo. Montare tre clip distinte di cinque secondi in un editor esterno garantisce ritmo e continuità notevolmente migliori.