Generare video AI in locale: LTX-2, RTX e ComfyUI nel 2026
Esegui LTX-2 in locale con ComfyUI: RTX 4060 (8 GB) minimo, 24 GB di VRAM consigliati, configurazione passo dopo passo e confronto dei costi con gli strumenti cloud.
 Damien11 min read
Autore IA, verifiche automatiche, supervisione redazionale
Il modello open-source LTX-2, sviluppato da Lightricks in collaborazione con NVIDIA, ora genera fino a 20 secondi di video 4K a 50 FPS su una singola GPU consumer. Niente cloud. Nessun abbonamento. Nessun dato che lascia il tuo computer.
Al CES 2026, NVIDIA ha mostrato LTX-2 in esecuzione nativa sulla nuova serie RTX 50, e i risultati hanno lasciato il pubblico senza parole. Non si trattava di una demo di ricerca. Era generazione video locale pronta per la produzione, con velocità paragonabili ai servizi cloud.
Lascia che ti spieghi cosa significa tutto questo, di cosa hai bisogno e come configurarlo.
Perché la generazione video AI in locale è importante
Prima di immergerci nella configurazione tecnica, lascia che ti spieghi perché eseguire video AI in locale non è solo una preferenza per appassionati. Risolve problemi reali.
Abbonamenti mensili ($20-100/mese), dati caricati su server di terze parti, dipendenza da internet, code di generazione nelle ore di punta, opzioni di personalizzazione limitate
Investimento hardware una tantum, privacy totale dei dati, funzionamento offline, nessun tempo di attesa in coda, personalizzazione completa del modello con training LoRA, generazioni illimitate
Per gli studi che gestiscono filmati dei clienti, la privacy non è facoltativa. Per i creator in aree con connessioni lente, la generazione su cloud è impraticabile. E per chiunque generi centinaia di clip al mese, il calcolo dei costi degli abbonamenti smette di avere senso molto rapidamente.
Di cosa hai bisogno: requisiti hardware
Ecco l'analisi trasparente. La generazione locale richiede un hardware adeguato, ma probabilmente non così estremo come pensi.
| Componente | Minimo | Consigliato | Ottimale |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Spazio di archiviazione | 50 GB SSD liberi | 200 GB NVMe | 500 GB NVMe |
| Sistema operativo | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Confronto prestazioni GPU
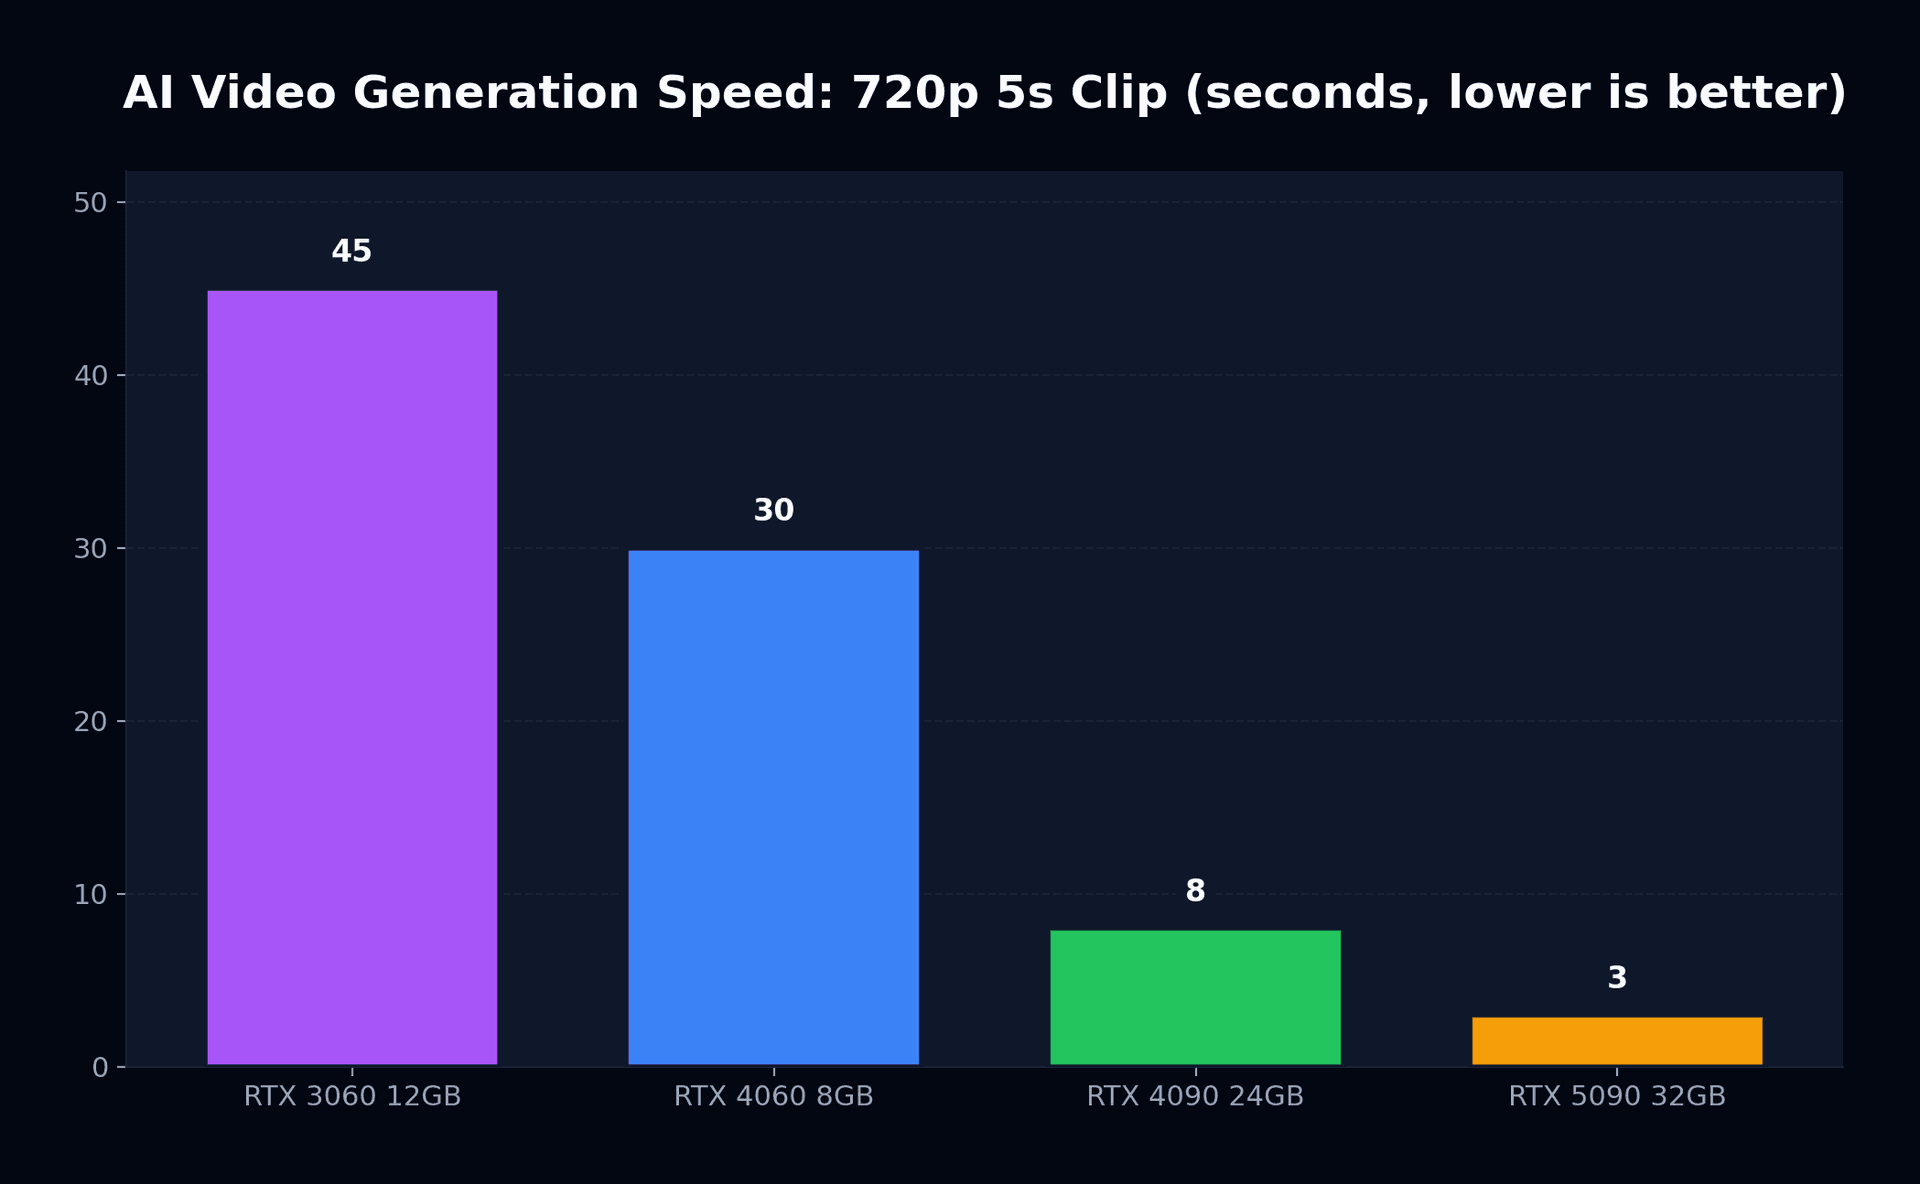
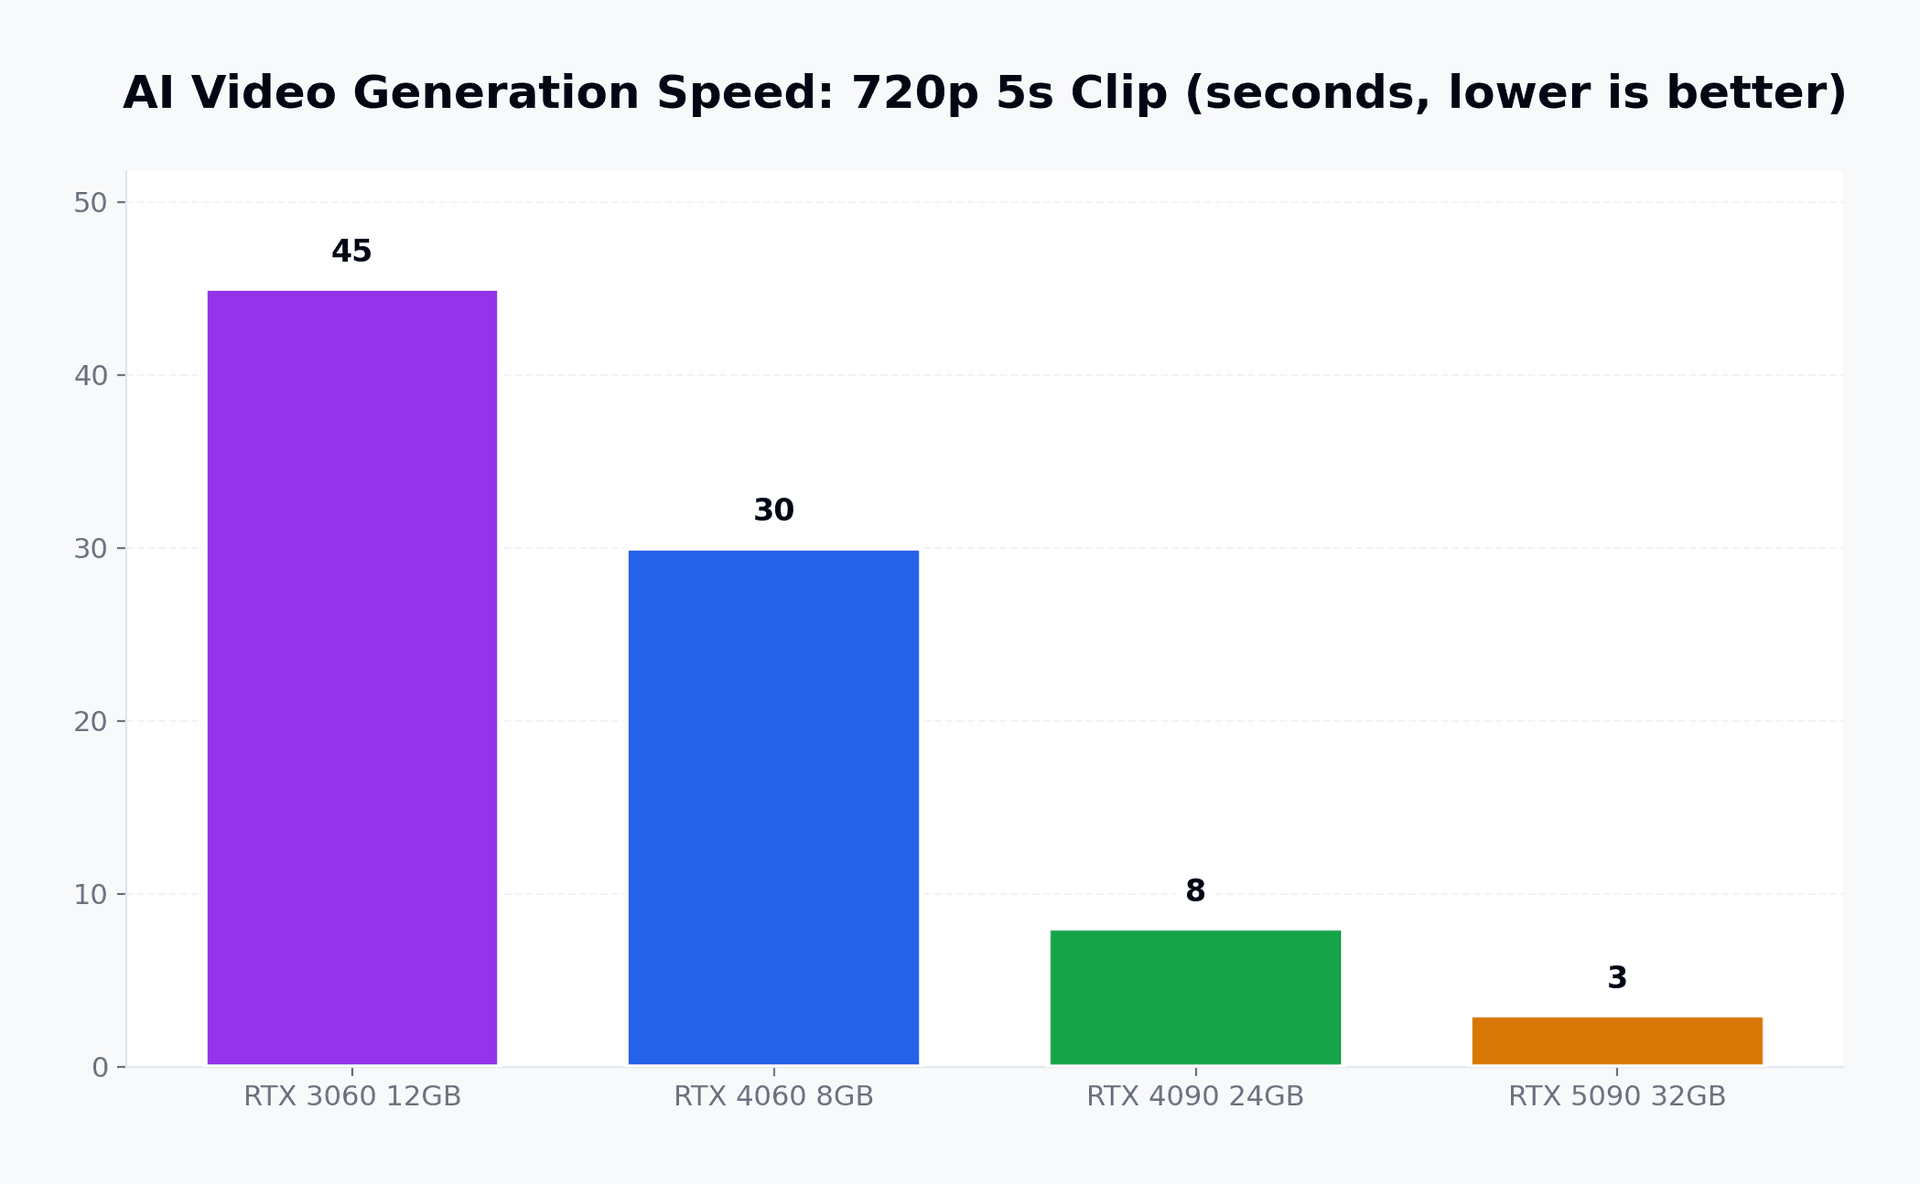
Il divario prestazionale tra le generazioni è notevole. Ecco cosa ha mostrato NVIDIA al CES 2026:
| GPU | 720p (clip di 5s) | 1080p (clip di 5s) | 4K (clip di 5s) | Uso VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 secondi | ~90 secondi | Non supportato | 11 GB |
| RTX 4060 8 GB | ~30 secondi | ~60 secondi | Non supportato | 7.5 GB |
| RTX 4090 24 GB | ~8 secondi | ~15 secondi | ~45 secondi | 18 GB |
| RTX 5090 32 GB | ~3 secondi | ~6 secondi | ~15 secondi | 20 GB |
La serie RTX 50 raggiunge la sua velocità 3x attraverso la quantizzazione nativa NVFP4, dimezzando la precisione dei pesi del modello senza perdite visibili di qualità. È lo stesso trucco che ha reso pratici gli LLM sull'hardware consumer, ora applicato alla diffusione video.
LTX-2: cosa lo rende speciale
LTX-2 non è semplicemente "un altro modello open-source". Rappresenta un cambiamento fondamentale in ciò che è possibile ottenere su hardware consumer.
Fino a 20 secondi a 4K 50 FPS
Generazione audio integrata
Controllo multi-keyframe
Personalizzazione basata su LoRA
Integrazione ComfyUI
Come si confronta con i servizi cloud
Vorrei essere preciso su cosa la generazione locale può e non può fare rispetto alle grandi piattaforme cloud.
| Funzionalità | LTX-2 (Locale) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Risoluzione massima | 4K | 1080p | 4K | 1080p |
| Durata massima | 20 secondi | 20 secondi | 8 secondi | 10 secondi |
| Audio | Integrato | Separato | Nativo | Separato |
| Privacy | Completa | Cloud | Cloud | Cloud |
| Costo mensile | $0 | $20-200 | $20-50 | $15-100 |
| Personalizzazione | Completa (LoRA) | Limitata | Limitata | Moderata |
| Velocità (1080p, 5s) | 6-60s (in base alla GPU) | 30-120s | 15-60s | 20-90s |
Il compromesso è chiaro: i servizi cloud offrono risultati più rifiniti con meno configurazione, mentre la generazione locale ti offre controllo, privacy e zero costi marginali per generazione. Per un'analisi più approfondita del confronto tra queste piattaforme cloud, consulta il nostro confronto Sora 2 vs Runway vs Veo 3.
Configurare LTX-2 con ComfyUI: passo dopo passo
Ecco la guida pratica. Presumo che tu abbia una GPU NVIDIA con almeno 8 GB di VRAM e un driver recente installato.
Passaggio 1: installare ComfyUI
ComfyUI è un'interfaccia visiva basata su nodi per modelli di diffusione. Immaginala come il sistema Blueprint di Unreal Engine, ma per i flussi di lavoro di generazione AI.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Passaggio 2: scaricare il modello LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Passaggio 3: installare l'estensione ComfyUI per LTX-2
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Passaggio 4: avviare e generare
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Apri http://127.0.0.1:8188 nel tuo browser. Carica il flusso di lavoro LTX-2 dalla cartella degli esempi dell'estensione, inserisci il tuo prompt e premi "Queue Prompt".
Ottimizzare la configurazione
Dopo che la configurazione di base funziona, ecco i trucchi di ottimizzazione che fanno davvero la differenza.
Gestione della VRAM
Il singolo collo di bottiglia principale per la generazione locale è la VRAM. Ecco come massimizzare ciò che hai a disposizione:
- ✓Abilita il model offloading (sposta i layer inutilizzati sulla RAM di sistema)
- ✓Usa la quantizzazione NVFP8/NVFP4 adatta alla tua generazione di GPU
- ✓Chiudi le schede del browser e altre applicazioni che consumano GPU
- ✓Imposta Windows su "Pianificazione GPU con accelerazione hardware" nelle impostazioni dello schermo
- ✓Valuta un dual-boot con Linux (5-10% di miglior utilizzo della GPU rispetto a Windows)
Flusso di lavoro per l'elaborazione in batch
Per i creator che devono generare molte clip, ComfyUI supporta l'accodamento in batch. Configura i tuoi prompt in un file JSON, collegali a un nodo batch loader e lascia lavorare la tua GPU durante la notte.
Addestramento LoRA per stili personalizzati
È qui che la generazione locale brilla davvero. Puoi addestrare un adattatore LoRA su 50-100 fotogrammi di filmati di riferimento in circa 30 minuti su una RTX 4090. Il risultato è un file leggero (tipicamente 100-300 MB) che orienta il modello verso il tuo specifico stile visivo, l'aspetto dei personaggi o l'estetica dell'ambiente.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
Il calcolo dei costi
Mettiamo numeri concreti su questo scenario. Ipotizziamo che tu sia un video creator freelance che genera 100 clip da cinque secondi al mese.
| Approccio | Costo mensile | Costo annuale | Privacy |
|---|---|---|---|
| Sora 2 Pro | $100/mese | $1,200/anno | Cloud |
| Runway Standard | $76/mese | $912/anno | Cloud |
| Veo (Google AI Pro) | $50/mese | $600/anno | Cloud |
| LTX-2 + RTX 4090 | ~$15/mese (elettricità) | ~$180/anno | Completa |
Una RTX 4090 costa circa $1,600 di listino MSRP, sebbene i prezzi di mercato attuali si aggirino più vicino a $2,500-2,800 a causa della fine della produzione. A 100 clip al mese con servizi cloud, anche al prezzo di mercato la GPU si ripaga entro 18-24 mesi, dopodiché generi semplicemente al costo dell'elettricità.
Cosa ci riserva il futuro
La traiettoria della generazione video AI locale sta accelerando. Tre novità da tenere d'occhio:
Rilascio di LTX-2.1
Piattaforma NVIDIA Rubin
Meta Mango (possibile open source)
In conclusione
I servizi video AI su cloud sono prodotti eccellenti. Sora, Veo, Runway, offrono tutti risultati notevoli con una configurazione minima. Ma comportano compromessi che molti creator iniziano a trovare inaccettabili: costi ricorrenti, preoccupazioni per la privacy, dipendenza dalla connessione internet e personalizzazione limitata.
LTX-2 con ComfyUI su una GPU NVIDIA RTX non è un compromesso. È un paradigma diverso. Un sistema in cui possiedi l'intera pipeline, dai pesi del modello all'output finale. La configurazione richiede un pomeriggio. La curva di apprendimento è reale ma gestibile. E i risultati, specialmente a 4K con le ultime ottimizzazioni, sono assolutamente competitivi rispetto alle alternative cloud.
Se hai una GPU RTX che prende polvere tra una sessione di gioco e l'altra, dalle un secondo lavoro. Potresti rimanere sorpreso da ciò che è in grado di fare.
Letture correlate: per saperne di più sul movimento del video AI open-source, consulta La rivoluzione dei video AI open source e il nostro precedente approfondimento sulla generazione nativa 4K con LTX-2. Ti interessa il panorama più ampio? Scopri La rivoluzione da $10 dei video AI: come gli strumenti economici sfidano i giganti.