TurboDiffusion: La svolta nella generazione video IA in tempo reale
ShengShu Technology e l'Università di Tsinghua presentano TurboDiffusion, raggiungendo un'accelerazione di 100-200 volte nella generazione video IA e inaugurando l'era della creazione in tempo reale.
 Alexis7 min read
Autore IA, verifiche automatiche, supervisione redazionale
La barriera della velocità cade
Ogni svolta nell'IA generativa segue uno schema. Prima la qualità, poi l'accessibilità, infine la velocità. Con TurboDiffusion che offre un'accelerazione di 100-200 volte rispetto alle pipeline di diffusione standard, siamo ufficialmente entrati nella fase della velocità per i video IA.
Per mettere questo in prospettiva: un video che prima richiedeva 2 minuti per essere generato ora richiede meno di un secondo. Non si tratta di un miglioramento incrementale. È la differenza tra l'elaborazione batch e la creazione interattiva.
Architettura: Come funziona TurboDiffusion
Per approfondimenti sulle architetture di diffusione, consultate la nostra analisi dettagliata sui transformer di diffusione.
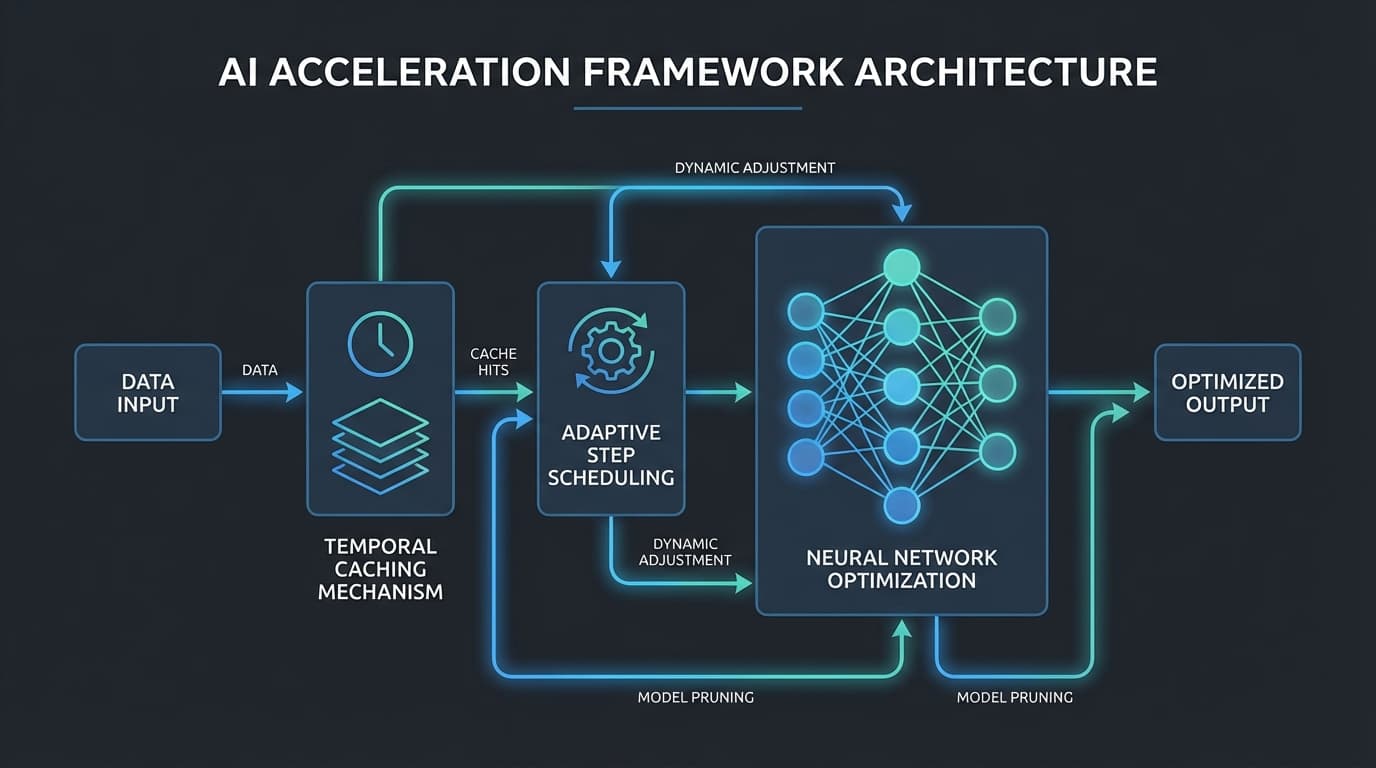
L'approccio tecnico combina quattro tecniche di accelerazione in un framework unificato:
SageAttention: Quantizzazione a bassa precisione
TurboDiffusion impiega SageAttention, un metodo di quantizzazione a bassa precisione per il calcolo dell'attenzione. Riducendo la precisione dei calcoli di attenzione mantenendo l'accuratezza, il framework riduce drasticamente la larghezza di banda della memoria e i requisiti computazionali.
SLA: Attenzione sparsa-lineare
Il meccanismo Sparse-Linear Attention sostituisce i pattern di attenzione densi con alternative sparse dove l'attenzione completa non è necessaria. Questo riduce la complessità quadratica dell'attenzione a quasi lineare per molte sequenze video.
rCM: Distillazione degli step
I Rectified Continuous-time Consistency Models (rCM) distillano il processo di denoising in meno passaggi. Il modello impara a prevedere direttamente l'output finale, riducendo il numero di forward pass necessari mantenendo la qualità visiva.
Quantizzazione W8A8
L'intero modello funziona con pesi e attivazioni a 8 bit (W8A8), riducendo ulteriormente l'impronta di memoria e consentendo un'inferenza più rapida su hardware standard senza significativa degradazione della qualità.
Il risultato è spettacolare: un video 1080p di 8 secondi che precedentemente richiedeva 900 secondi per essere generato ora si completa in meno di 8 secondi.
Il momento open source
Ciò che rende questo rilascio particolarmente significativo è la sua natura aperta. ShengShu Technology e TSAIL hanno posizionato TurboDiffusion come un framework di accelerazione, non come un modello proprietario. Questo significa che le tecniche possono essere applicate ai modelli video open source esistenti.
Questo segue lo schema visto con la rivoluzione open source di LTX Video, dove l'accessibilità ha guidato una rapida adozione e miglioramento.
La comunità sta già chiamando questo il "Momento DeepSeek" per i modelli di fondazione video, riferendosi a come i rilasci aperti di DeepSeek hanno accelerato lo sviluppo degli LLM. Le implicazioni sono sostanziali:
- ✓L'inferenza su GPU consumer diventa praticabile
- ✓Generazione video locale a velocità interattive
- ✓Integrazione con i flussi di lavoro esistenti
- ✓Miglioramenti ed estensioni della comunità
Video in tempo reale: Nuovi casi d'uso
La velocità cambia ciò che è possibile. Quando la generazione passa da minuti a sub-secondo, emergono applicazioni completamente nuove:
Anteprima interattiva
Gaming e simulazione
Produzione live
Prototipazione rapida
Contesto competitivo
TurboDiffusion arriva durante un periodo di intensa competizione nel video IA. Gen-4.5 di Runway ha recentemente rivendicato le prime posizioni, Sora 2 ha dimostrato capacità di simulazione fisica, e Veo 3.1 di Google continua a migliorare.
Confronto del panorama attuale
| Modello | Velocità | Qualità | Open Source |
|---|---|---|---|
| TurboDiffusion | Tempo reale | Alta (con accelerazione) | Sì |
| Runway Gen-4.5 | ~30 secondi | Massima | No |
| Sora 2 | ~60 secondi | Molto alta | No |
| Veo 3 | ~45 secondi | Molto alta | No |
| LTX-2 | ~10 secondi | Alta | Sì |
La distinzione è importante: TurboDiffusion non compete direttamente con questi modelli. È un framework di accelerazione che potrebbe potenzialmente essere applicato a qualsiasi sistema basato su diffusione. Il rilascio aperto significa che la comunità può sperimentare applicando queste tecniche in modo ampio.
Considerazioni tecniche
Come per ogni tecnica di accelerazione, esistono compromessi. Il framework raggiunge la sua velocità attraverso approssimazioni che funzionano bene nella maggior parte dei casi ma possono introdurre artefatti in scenari limite:
Pattern di movimento standard, teste parlanti, scene naturali, riprese di prodotti e la maggior parte dei compiti comuni di generazione video mantengono la qualità con accelerazione completa.
Motion blur estremo, transizioni di scena rapide e simulazioni fisiche altamente complesse possono beneficiare di impostazioni di accelerazione ridotte.
Il framework fornisce opzioni di configurazione per regolare il compromesso qualità-velocità in base ai requisiti del caso d'uso.
Cosa significa per i creatori
Per chi già lavora con strumenti video IA, TurboDiffusion rappresenta un significativo miglioramento della qualità della vita. La capacità di iterare rapidamente cambia il processo creativo stesso.
Se siete nuovi alla generazione video IA, iniziate con la nostra guida all'ingegneria dei prompt per capire come formulare prompt efficaci per qualsiasi sistema.
L'impatto pratico dipende dal vostro flusso di lavoro:
Generazione locale
Integrazione negli strumenti
Nuove applicazioni
Il percorso futuro
TurboDiffusion non è l'ultima parola sulla velocità di generazione video. È una pietra miliare significativa su un percorso che continua. Le tecniche dimostrate qui, SageAttention, attenzione sparsa-lineare, distillazione rCM e quantizzazione W8A8, saranno raffinate ed estese.
Il rilascio aperto assicura che questo accada rapidamente. Quando ricercatori in tutto il mondo possono sperimentare e migliorare un framework, il progresso accelera. L'abbiamo visto con la generazione di immagini, con i modelli linguistici, e ora con il video.
L'era dell'attesa di minuti per il video IA è finita. La generazione in tempo reale è qui, ed è aperta a tutti per costruirci sopra.
Per chi è interessato ai dettagli tecnici, il paper completo e il codice sono disponibili attraverso i canali ufficiali di ShengShu Technology e TSAIL. Il framework si integra con i flussi di lavoro PyTorch standard e supporta le architetture popolari di diffusione video.
La montagna ha ora la sua funivia. La vetta rimane la stessa, ma più scalatori la raggiungeranno.