Executar Vídeo de IA Localmente: LTX-2, RTX e ComfyUI em 2026
Execute o LTX-2 localmente com o ComfyUI: RTX 4060 (8 GB) no mínimo, 24 GB de VRAM recomendados, configuração passo a passo e comparação de custos com ferramentas na nuvem.
 Damien11 min read
Autor de IA, verificações automáticas, editor responsável
O modelo de código aberto LTX-2, desenvolvido pela Lightricks em colaboração com a NVIDIA, agora gera até 20 segundos de vídeo 4K a 50 FPS em uma única GPU de consumo. Sem nuvem. Sem assinatura. Nenhum dado saindo da sua máquina.
Na CES 2026, a NVIDIA demonstrou o LTX-2 rodando nativamente na nova RTX Série 50, e os resultados deixaram o público impressionado. Não foi uma demonstração de pesquisa. Foi uma geração local de vídeo pronta para produção, rodando a velocidades que rivalizam com serviços na nuvem.
Vou explicar o que isso significa, o que você precisa e como configurar tudo.
Por Que a Geração Local de Vídeo de IA Importa
Antes de mergulhar na configuração técnica, deixe-me explicar por que executar vídeo de IA localmente não é apenas uma preferência de entusiasta. Isso resolve problemas reais.
Assinaturas mensais ($20-100/mês), dados enviados para servidores de terceiros, dependência de internet, filas de geração em horários de pico, opções limitadas de personalização
Investimento único em hardware, privacidade total dos dados, funciona offline, sem tempo de espera em filas, personalização completa do modelo com treinamento LoRA, gerações ilimitadas
Para estúdios lidando com filmagens de clientes, a privacidade não é opcional. Para criadores em regiões com internet lenta, a geração na nuvem é inviável. E para qualquer pessoa que gera centenas de clipes por mês, a matemática das assinaturas rapidamente deixa de fazer sentido.
O Que Você Precisa: Requisitos de Hardware
Aqui está a análise honesta. A geração local requer hardware decente, mas provavelmente não tão extremo quanto você pensa.
| Componente | Mínimo | Recomendado | Ideal |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Armazenamento | 50 GB de SSD livre | 200 GB NVMe | 500 GB NVMe |
| SO | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Comparação de Desempenho de GPU
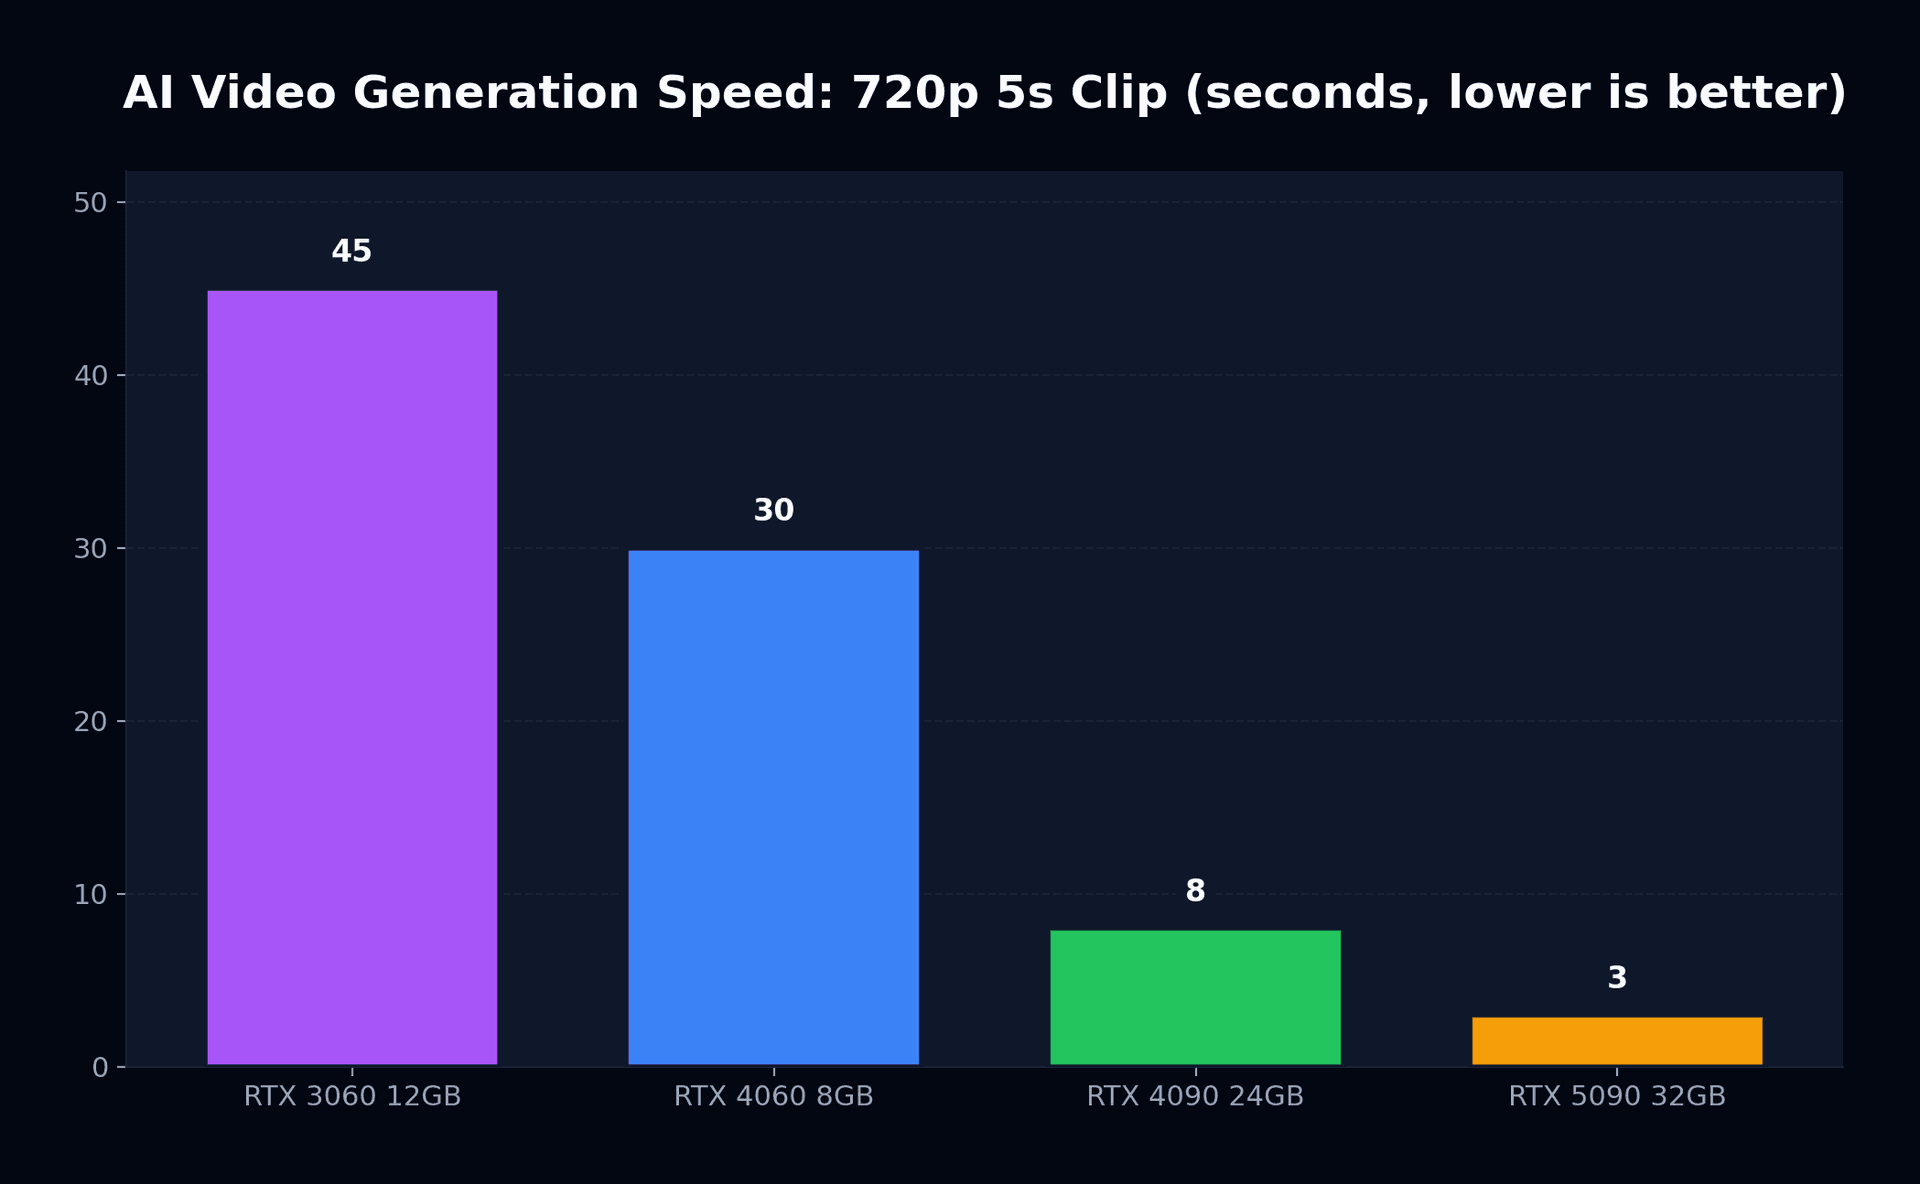
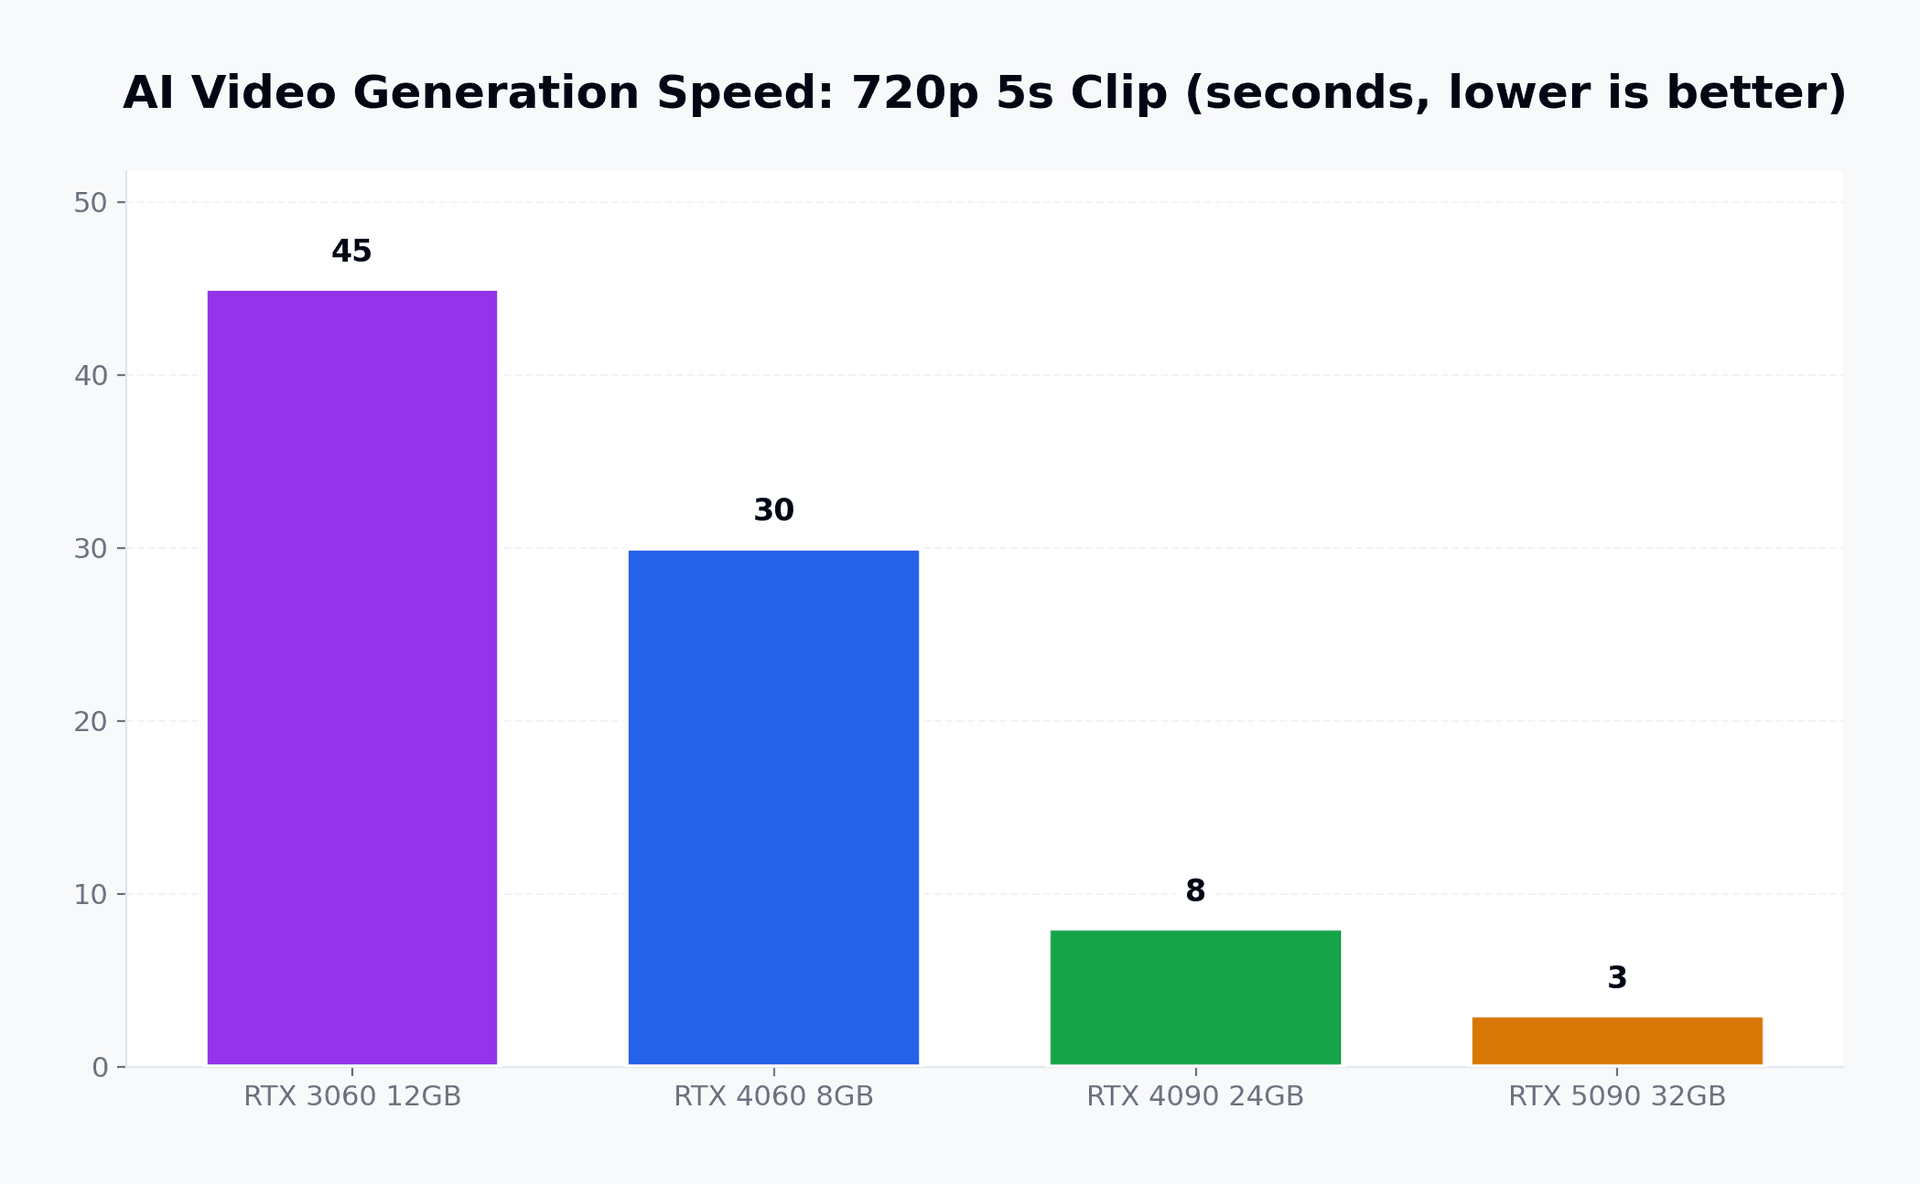
A diferença de desempenho entre as gerações é impressionante. Aqui está o que a NVIDIA demonstrou na CES 2026:
| GPU | 720p (clipe de 5s) | 1080p (clipe de 5s) | 4K (clipe de 5s) | Uso de VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 segundos | ~90 segundos | Não suportado | 11 GB |
| RTX 4060 8 GB | ~30 segundos | ~60 segundos | Não suportado | 7.5 GB |
| RTX 4090 24 GB | ~8 segundos | ~15 segundos | ~45 segundos | 18 GB |
| RTX 5090 32 GB | ~3 segundos | ~6 segundos | ~15 segundos | 20 GB |
A RTX Série 50 alcança sua aceleração de 3x por meio da quantização nativa NVFP4, reduzindo pela metade a precisão dos pesos do modelo sem perda perceptível de qualidade. Este é o mesmo truque que tornou os LLMs práticos em hardware de consumo, agora aplicado à difusão de vídeo.
LTX-2: O Que o Torna Especial
O LTX-2 não é simplesmente "mais um modelo de código aberto". Ele representa uma mudança fundamental no que é possível fazer em hardware de consumo.
Até 20 Segundos em 4K 50 FPS
Geração de Áudio Embutida
Controle Multi-Keyframe
Personalização Baseada em LoRA
Integração com ComfyUI
Como Ele se Compara aos Serviços na Nuvem
Deixe-me ser específico sobre o que a geração local pode e não pode fazer em comparação com as grandes plataformas na nuvem.
| Recurso | LTX-2 (Local) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Resolução máxima | 4K | 1080p | 4K | 1080p |
| Duração máxima | 20 segundos | 20 segundos | 8 segundos | 10 segundos |
| Áudio | Embutido | Separado | Nativo | Separado |
| Privacidade | Total | Nuvem | Nuvem | Nuvem |
| Custo mensal | $0 | $20-200 | $20-50 | $15-100 |
| Personalização | Completa (LoRA) | Limitada | Limitada | Moderada |
| Velocidade (1080p, 5s) | 6-60s (dependente da GPU) | 30-120s | 15-60s | 20-90s |
O compromisso é claro: os serviços na nuvem oferecem resultados mais polidos com menos configuração, enquanto a geração local oferece controle, privacidade e custo marginal zero por geração. Para uma visão mais detalhada de como essas plataformas na nuvem se comparam, consulte nossa comparação entre Sora 2, Runway e Veo 3.
Configurando o LTX-2 com ComfyUI: Passo a Passo
Aqui está o guia prático. Estou presumindo que você tenha uma GPU NVIDIA com pelo menos 8 GB de VRAM e um driver recente instalado.
Passo 1: Instalar o ComfyUI
O ComfyUI é uma interface visual baseada em nós para modelos de difusão. Pense nele como o sistema de Blueprints da Unreal Engine, mas para fluxos de trabalho de geração de IA.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Passo 2: Baixar o Modelo LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Passo 3: Instalar a Extensão ComfyUI do LTX-2
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Passo 4: Inicializar e Gerar
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Abra http://127.0.0.1:8188 no seu navegador. Carregue o fluxo de trabalho do LTX-2 a partir da pasta de exemplos da extensão, digite seu prompt e clique em "Queue Prompt".
Otimizando Sua Configuração
Após o funcionamento básico, aqui estão os ajustes que fazem uma diferença real.
Gerenciamento de VRAM
O maior gargalo individual para geração local é a VRAM. Veja como maximizar o que você tem:
- ✓Ative o offloading de modelo (move camadas não utilizadas para a memória RAM do sistema)
- ✓Use quantização NVFP8/NVFP4 para a sua geração de GPU
- ✓Feche abas do navegador e outros aplicativos com alto consumo de GPU
- ✓Defina o Windows para "Agendamento de GPU acelerado por hardware" nas configurações de exibição
- ✓Considere dual-boot com Linux (utilização da GPU 5-10% melhor em comparação com o Windows)
Fluxo de Trabalho de Processamento em Lote
Para criadores que precisam gerar muitos clipes, o ComfyUI suporta enfileiramento em lote. Configure seus prompts em um arquivo JSON, conecte-os a um nó carregador de lotes e deixe sua GPU trabalhando durante a noite.
Treinamento LoRA para Estilos Personalizados
É aqui que a geração local realmente se destaca. Você pode treinar um adaptador LoRA com 50-100 quadros de filmagem de referência em cerca de 30 minutos em uma RTX 4090. O resultado é um arquivo leve (geralmente de 100-300 MB) que direciona o modelo para o seu estilo visual específico, aparências de personagens ou estéticas de ambiente.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
O Cálculo de Custos
Deixe-me trazer números concretos para isso. Suponha que você seja um criador de vídeo freelancer gerando 100 clipes de cinco segundos por mês.
| Abordagem | Custo Mensal | Custo Anual | Privacidade |
|---|---|---|---|
| Sora 2 Pro | $100/mês | $1,200/ano | Nuvem |
| Runway Standard | $76/mês | $912/ano | Nuvem |
| Veo (Google AI Pro) | $50/mês | $600/ano | Nuvem |
| LTX-2 + RTX 4090 | ~$15/mês (eletricidade) | ~$180/ano | Total |
Uma RTX 4090 custa cerca de $1,600 no preço sugerido (MSRP), embora os preços atuais de mercado fiquem mais próximos de $2,500-2,800 devido ao encerramento da produção. Com 100 clipes por mês usando serviços na nuvem, mesmo pelo preço de mercado a GPU se paga dentro de 18-24 meses, e depois disso você estará gerando pelo custo da eletricidade.
O Que Vem a Seguir
A trajetória da geração local de vídeo com IA está acelerando. Três desenvolvimentos para ficar de olho:
Lançamento do LTX-2.1
Plataforma NVIDIA Rubin
Meta Mango (Possível Código Aberto)
Conclusão
Os serviços de vídeo de IA na nuvem são produtos excelentes. Sora, Veo, Runway, todos entregam resultados impressionantes com configuração mínima. Mas vêm com concessões que muitos criadores começam a achar inaceitáveis: custos recorrentes, preocupações com privacidade, dependência de internet e personalização limitada.
O LTX-2 com ComfyUI em uma GPU NVIDIA RTX não é um paliativo. É um paradigma diferente. Um em que você é dono de todo o fluxo, desde os pesos do modelo até a saída final. A configuração leva uma tarde. A curva de aprendizado existe, mas é perfeitamente administrável. E os resultados, especialmente em 4K com as otimizações mais recentes, são genuinamente competitivos com alternativas na nuvem.
Se você tem uma GPU RTX acumulando poeira entre sessões de jogos, dê a ela um segundo trabalho. Você pode se surpreender com o que ela é capaz de fazer.
Leituras relacionadas: Para saber mais sobre o movimento de vídeo de IA de código aberto, confira A Revolução do Vídeo de IA de Código Aberto e nossa análise aprofundada anterior sobre geração 4K nativa com LTX-2. Interessado em um panorama mais amplo? Veja A Revolução de $10 do Vídeo de IA: Como Ferramentas Acessíveis Desafiam Gigantes.