Ejecutar vídeo de IA en local: LTX-2, RTX y ComfyUI en 2026
Ejecuta LTX-2 en local con ComfyUI: RTX 4060 (8 GB) como mínimo, 24 GB de VRAM recomendados, configuración paso a paso y cómo se compara el coste con las herramientas en la nube.
 Damien11 min read
Autor de IA, revisiones automáticas, edición responsable
El modelo de código abierto LTX-2, desarrollado por Lightricks en colaboración con NVIDIA, ahora genera hasta 20 segundos de vídeo 4K a 50 FPS en una única GPU de consumo. Sin nube. Sin suscripción. Sin datos que salgan de tu equipo.
En el CES 2026, NVIDIA demostró LTX-2 ejecutándose de forma nativa en la nueva RTX 50 Series, y los resultados dejaron al público sin palabras. No era una demo de investigación: era generación de vídeo local lista para producción, ejecutándose a velocidades que rivalizan con los servicios en la nube.
A continuación, te explico qué significa esto, qué necesitas y cómo configurarlo.
Por qué es importante la generación de vídeo de IA en local
Antes de sumergirnos en la configuración técnica, permíteme explicar por qué ejecutar vídeo de IA en local no es solo una preferencia de entusiastas. Resuelve problemas reales.
Suscripciones mensuales ($20-100/mes), datos subidos a servidores de terceros, dependencia de internet, colas de generación en horas punta, opciones de personalización limitadas
Inversión única en hardware, privacidad completa de datos, funciona sin conexión, sin tiempos de espera en cola, personalización completa del modelo mediante entrenamiento LoRA, generaciones ilimitadas
Para los estudios que gestionan metraje de clientes, la privacidad no es opcional. Para los creadores en regiones con conexiones lentas de internet, la generación en la nube es poco práctica. Y para cualquiera que genere cientos de clips al mes, las cuentas de las suscripciones dejan de tener sentido muy rápidamente.
Qué necesitas: requisitos de hardware
Aquí tienes el desglose honesto. La generación local requiere un hardware decente, pero probablemente no tan extremo como imaginas.
| Componente | Mínimo | Recomendado | Óptimo |
|---|---|---|---|
| GPU | RTX 4060 (8 GB) | RTX 4090 (24 GB) | RTX 5090 (32 GB) |
| RAM | 16 GB | 32 GB | 64 GB |
| Almacenamiento | 50 GB de SSD libre | 200 GB NVMe | 500 GB NVMe |
| SO | Windows 10/11, Linux | Ubuntu 22.04+ | Ubuntu 22.04+ |
Comparativa de rendimiento de GPU
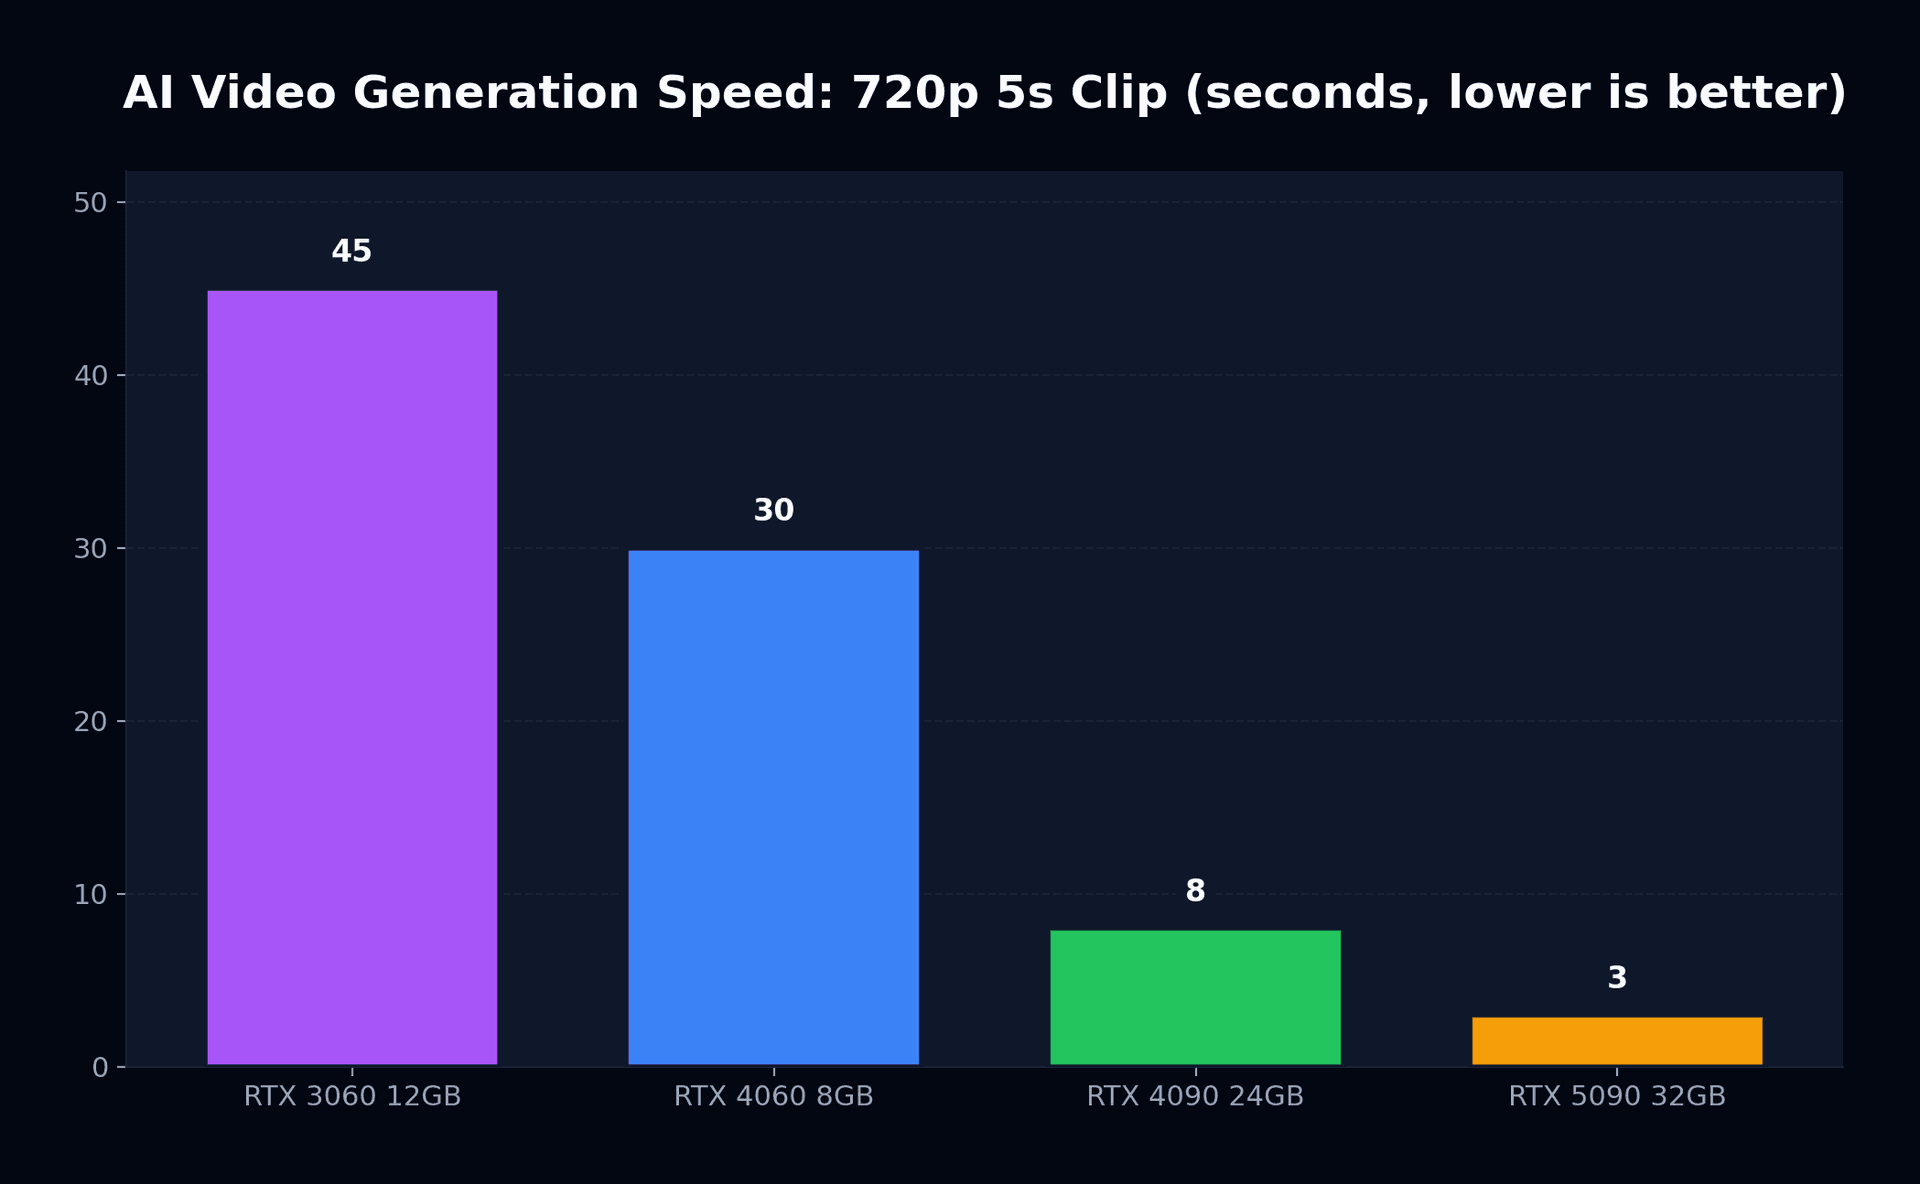
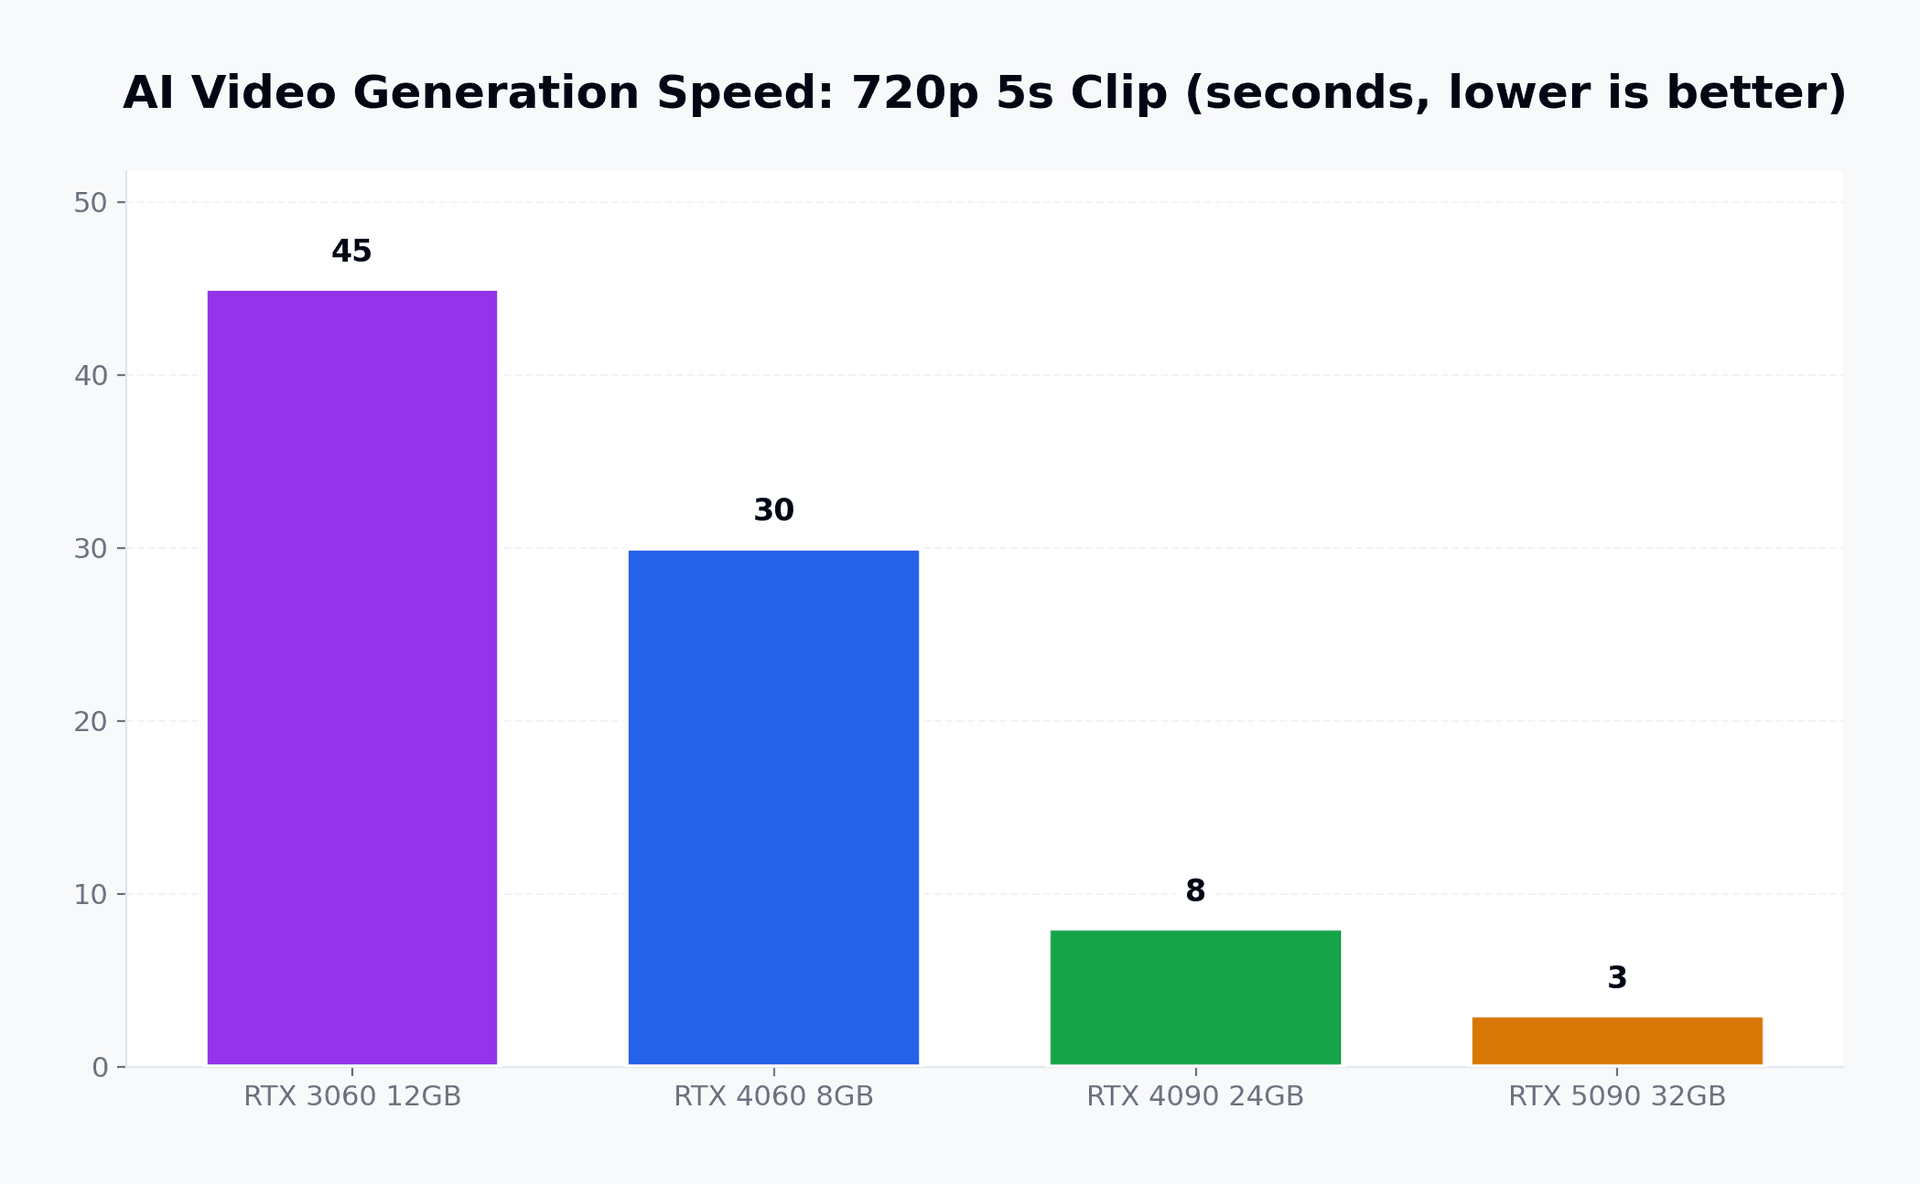
La diferencia de rendimiento entre generaciones es espectacular. Esto es lo que NVIDIA demostró en el CES 2026:
| GPU | 720p (clip de 5s) | 1080p (clip de 5s) | 4K (clip de 5s) | Uso de VRAM |
|---|---|---|---|---|
| RTX 3060 12 GB | ~45 segundos | ~90 segundos | No compatible | 11 GB |
| RTX 4060 8 GB | ~30 segundos | ~60 segundos | No compatible | 7.5 GB |
| RTX 4090 24 GB | ~8 segundos | ~15 segundos | ~45 segundos | 18 GB |
| RTX 5090 32 GB | ~3 segundos | ~6 segundos | ~15 segundos | 20 GB |
La RTX 50 Series logra su aceleración de 3x mediante la cuantización nativa NVFP4, reduciendo a la mitad la precisión de los pesos del modelo sin una pérdida de calidad visible. Es el mismo truco que hizo viables los LLM en hardware de consumo, ahora aplicado a la difusión de vídeo.
LTX-2: qué lo hace especial
LTX-2 no es simplemente "otro modelo de código abierto". Representa un cambio fundamental en lo que es posible sobre hardware de consumo.
Hasta 20 segundos a 4K 50 FPS
Generación de audio integrada
Control por múltiples fotogramas clave
Personalización basada en LoRA
Integración con ComfyUI
Cómo se compara con los servicios en la nube
Veamos en detalle qué puede y qué no puede hacer la generación local frente a las grandes plataformas en la nube.
| Característica | LTX-2 (Local) | Sora 2 | Veo 3.1 | Runway Gen-4.5 |
|---|---|---|---|---|
| Resolución máx. | 4K | 1080p | 4K | 1080p |
| Duración máx. | 20 segundos | 20 segundos | 8 segundos | 10 segundos |
| Audio | Integrado | Independiente | Nativo | Independiente |
| Privacidad | Completa | Nube | Nube | Nube |
| Coste mensual | $0 | $20-200 | $20-50 | $15-100 |
| Personalización | Total (LoRA) | Limitada | Limitada | Moderada |
| Velocidad (1080p, 5s) | 6-60s (según la GPU) | 30-120s | 15-60s | 20-90s |
El compromiso es evidente: los servicios en la nube ofrecen resultados más pulidos con menos configuración inicial, mientras que la generación local te da control, privacidad y cero coste marginal por generación. Para un análisis más exhaustivo sobre cómo se comparan estas plataformas en la nube, consulta nuestra comparativa entre Sora 2, Runway y Veo 3.
Configurar LTX-2 con ComfyUI: paso a paso
Esta es la guía práctica. Doy por hecho que dispones de una GPU NVIDIA con al menos 8 GB de VRAM y un controlador reciente instalado.
Paso 1: Instalar ComfyUI
ComfyUI es una interfaz visual basada en nodos para modelos de difusión. Imagínalo como el sistema de Blueprints de Unreal Engine, pero para flujos de trabajo de generación con IA.
# Clone ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI

# Create a virtual environment
python -m venv venv
source venv/bin/activate  # Linux/Mac
# venv\Scripts\activate   # Windows

# Install dependencies
pip install -r requirements.txt
pip install torch torchvision --index-url https://download.pytorch.org/whl/cu124
Paso 2: Descargar el modelo LTX-2
# Navigate to the models directory
cd models/checkpoints

# The weights live in Lightricks' gated repo on Hugging Face. Accept the terms on the
# model page first, then authenticate, or every download returns 401:
#   https://huggingface.co/Lightricks/LTX-2.5
# Verified 2026-08-31: the repo is gated (API reports gated=auto, 17 files). Pick the
# transformer that matches your VRAM from diffusion_models/ and the video VAE from vae/.
huggingface-cli login
huggingface-cli download Lightricks/LTX-2.5 \
  diffusion_models/ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  vae/ltx-2.5-video-vae-bf16.safetensors --local-dir .
Paso 3: Instalar la extensión LTX-2 para ComfyUI
cd ../../custom_nodes
git clone https://github.com/Lightricks/ComfyUI-LTXVideo.git
cd ComfyUI-LTXVideo
pip install -r requirements.txt
Paso 4: Iniciar y generar
# Return to ComfyUI root
cd ../..
python main.py --listen 127.0.0.1 --port 8188
Abre http://127.0.0.1:8188 en tu navegador. Carga el flujo de trabajo de LTX-2 desde la carpeta de ejemplos de la extensión, introduce tu prompt y haz clic en "Queue Prompt".
Optimizar tu configuración
Una vez que la configuración básica esté funcionando, aquí tienes los ajustes que marcan una diferencia real.
Gestión de VRAM
El mayor cuello de botella para la generación local es la VRAM. A continuación se explica cómo aprovechar al máximo la que tienes:
- ✓Activa la descarga del modelo (mueve capas no utilizadas a la RAM del sistema)
- ✓Usa la cuantización NVFP8/NVFP4 adecuada para tu generación de GPU
- ✓Cierra pestañas del navegador y otras aplicaciones que consuman GPU
- ✓Configura Windows en "Programación de GPU acelerada por hardware" en la configuración de pantalla
- ✓Considera un arranque dual con Linux (5-10% mejor aprovechamiento de la GPU frente a Windows)
Flujo de trabajo de procesamiento por lotes
Para creadores que necesitan generar muchos clips, ComfyUI admite el encolado por lotes. Prepara tus prompts en un archivo JSON, conéctalos a un nodo cargador por lotes y deja tu GPU trabajando toda la noche.
Entrenamiento LoRA para estilos personalizados
Aquí es donde la generación local destaca de verdad. Puedes entrenar un adaptador LoRA con 50-100 fotogramas de metraje de referencia en unos 30 minutos en una RTX 4090. El resultado es un archivo ligero (habitualmente de 100-300 MB) que orienta el modelo hacia tu estilo visual concreto, apariencias de personajes o estéticas de entorno.
# Example LoRA training command
python train_lora.py \
  --model ltx-2.5-22b-distilled-transformer-nvfp4.safetensors \
  --data ./my_reference_frames/ \
  --output ./loras/my_style.safetensors \
  --steps 1000 \
  --lr 1e-4 \
  --rank 32
El cálculo de costes
Pongamos cifras concretas. Supongamos que eres un creador de vídeo freelance que genera 100 clips de cinco segundos al mes.
| Enfoque | Coste mensual | Coste anual | Privacidad |
|---|---|---|---|
| Sora 2 Pro | $100/mes | $1,200/año | Nube |
| Runway Standard | $76/mes | $912/año | Nube |
| Veo (Google AI Pro) | $50/mes | $600/año | Nube |
| LTX-2 + RTX 4090 | ~$15/mes (electricidad) | ~$180/año | Completa |
Una RTX 4090 cuesta alrededor de $1,600 según el precio de venta recomendado, aunque los precios actuales del mercado rondan más bien los $2,500-2,800 debido al fin de su producción. Con 100 clips al mes utilizando servicios en la nube, incluso a precio de mercado la GPU se amortiza en 18-24 meses, y a partir de ahí generas solo por el coste de la electricidad.
Qué viene a continuación
La trayectoria de la generación de vídeo de IA en local se está acelerando. Tres novedades a seguir:
Lanzamiento de LTX-2.1
Plataforma NVIDIA Rubin
Meta Mango (potencial código abierto)
Conclusión
Los servicios de vídeo de IA en la nube son productos excelentes. Sora, Veo, Runway: todos ofrecen resultados impresionantes con una configuración mínima. Pero conllevan contrapartidas que muchos creadores empiezan a considerar inaceptables: costes recurrentes, preocupaciones sobre la privacidad, dependencia de internet y personalización limitada.
LTX-2 con ComfyUI en una GPU NVIDIA RTX no es un término medio de compromiso. Es un paradigma distinto. Uno en el que eres dueño de toda la cadena, desde los pesos del modelo hasta el resultado final. La configuración lleva una tarde. La curva de aprendizaje es real pero perfectamente manejable. Y los resultados, especialmente en 4K con las últimas optimizaciones, son genuinamente competitivos frente a las alternativas en la nube.
Si tienes una GPU RTX acumulando polvo entre sesiones de juego, dale un segundo propósito. Puede que te sorprenda lo que es capaz de hacer.
Lecturas relacionadas: Para saber más sobre el movimiento del vídeo de IA de código abierto, consulta La revolución del vídeo de IA de código abierto y nuestro análisis profundo previo sobre la generación nativa en 4K con LTX-2. ¿Te interesa el panorama general? Echa un vistazo a La revolución de los $10 en vídeo de IA: cómo las herramientas económicas desafían a los gigantes.