Quale generatore video AI è il migliore nel 2026? Testato e classificato
Scopri quale generatore video AI è il migliore nel 2026. Testiamo Veo 3.1, Runway e Kling rispetto a pipeline multi-fase da $0.045 a $0.35 al secondo.
 Alexis8 min read
Autore IA, verifiche automatiche, supervisione redazionale
Decidere quale generatore video AI sia il migliore nel 2026 richiede di guardare oltre i singoli filmati di benchmark per valutare l'affidabilità in produzione, i costi unitari delle API e la coerenza multi-inquadratura.
Negli ultimi dodici mesi, il panorama della diffusione video si è frammentato in motori specializzati. Le interfacce text-to-video autonome hanno ampiamente raggiunto una fase di stallo architetturale. Nella fascia alta, Google DeepMind ha distribuito Veo 3.1 con generazione audio nativa su Google Cloud Vertex AI a $0.35 al secondo. All'estremità ad alta produttività, MiniMax Hailuo H3 ha ridotto il prezzo di inferenza a $0.045 al secondo. Nel frattempo, i team di produzione che gestiscono carichi di lavoro commerciali si sono allontanati completamente dalle caselle di prompt monolitiche, adottando architetture multi-fase che separano la composizione spaziale dal movimento temporale.
La matrice video AI 2026: benchmark dei modelli leader
Per determinare quale generatore video AI sia il migliore nel 2026, abbiamo confrontato i principali modelli di produzione su quattro dimensioni misurabili: risoluzione massima di rendering, integrazione audio nativa, prezzi delle API per sviluppatori e precisione del controllo della telecamera.
| Modello | Risoluzione massima | Audio nativo | Costo API / sec | Latenza (clip 6s) | Punto di forza principale |
|---|---|---|---|---|---|
| Google Veo 3.1 | 4K (2160p) | Sì (dialogo + Foley) | $0.350 | 120s | Fedeltà cinematografica, suono sincronizzato |
| Runway Gen-4.5 | 1080p | No | $0.250 | 95s | Traiettorie telecamera su keyframe, vettori di movimento |
| Kling AI 2.0 | 1080p | Sperimentale | $0.080 | 85s | Coerenza facciale umana, aderenza al prompt |
| Luma Dream Machine | 1080p | No | $0.180 | 65s | Cambi di prospettiva 3D fluidi |
| MiniMax Hailuo H3 | 768p / 1080p | Sì (ambiente + suono) | $0.045 | 73s | Fisica dinamica rapida, basso costo di generazione |
| Bonega Pipeline | 1080p / 4K | Sì | $0.070 | 60s | Orchestrazione multi-fase, nessun lock-in da modello |
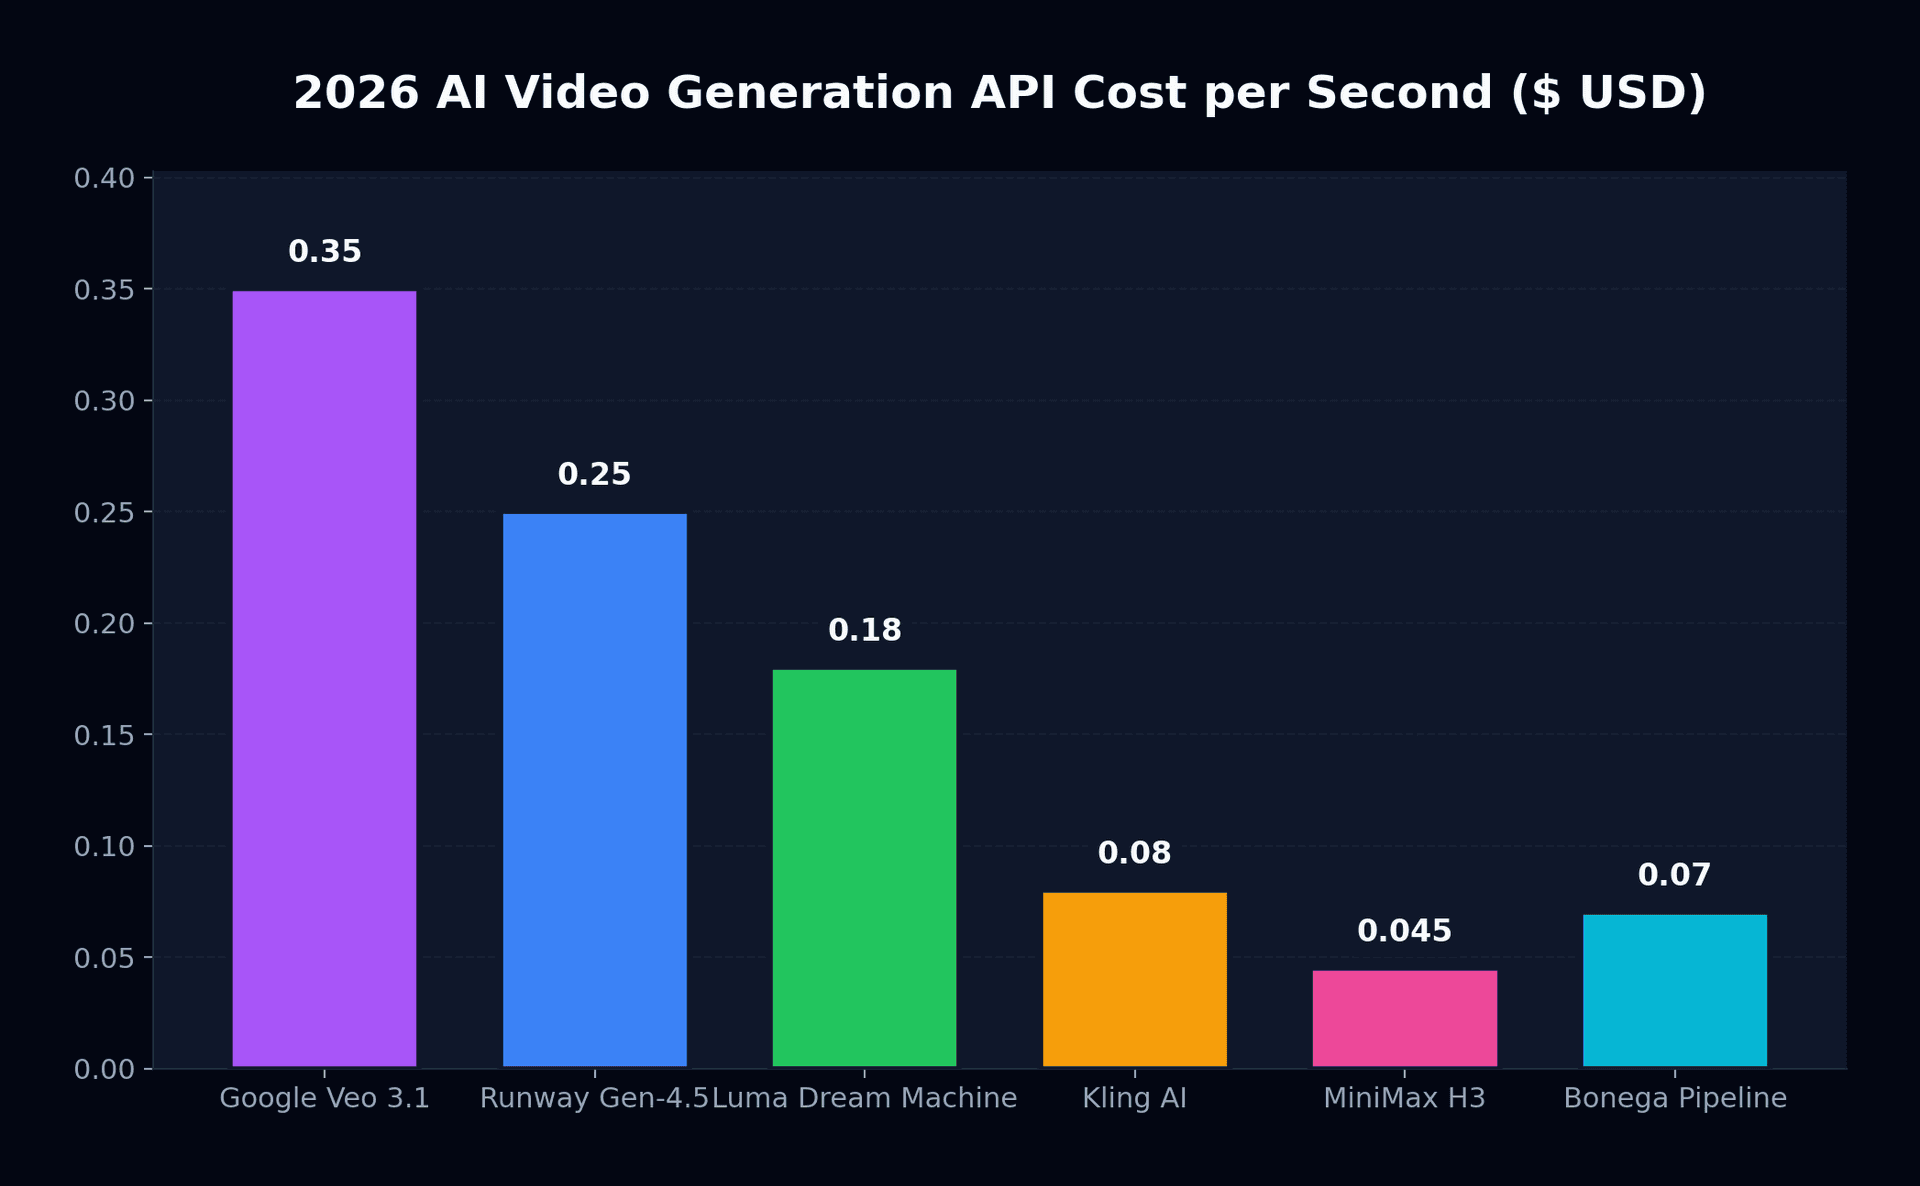
I prezzi di questi motori variano di quasi un ordine di grandezza. Un creator che genera sessanta secondi di video grezzo al giorno in modalità Veo 3.1 Quality affronta una spesa API mensile superiore a $630. Eseguire lo stesso volume tramite MiniMax H3 costa circa $81. Tuttavia, il costo da solo non determina l'utilità. Una sequenza d'azione sportiva ad alta intensità fallisce sui modelli privi di addestramento temporale ad alta velocità, mentre una scena di intervista aziendale richiede la perfetta geometria facciale che Kling AI e Veo preservano.
Perché il text-to-video monolitico fallisce in produzione
Quando i creator analizzano quale generatore video AI sia il migliore nel 2026 per la narrazione continua, i modelli a prompt singolo mostrano sistematicamente i loro limiti durante i test di produzione. La limitazione fondamentale risiede nell'allocazione dei tensori. Quando un algoritmo tenta di mappare i token del linguaggio naturale direttamente su un volume latente spazio-temporale tridimensionale, deve risolvere contemporaneamente la geometria spaziale e la fisica temporale.
Nella pratica, questo causa tre tipiche modalità di fallimento:
- Deriva temporale semantica: il modello dimentica le caratteristiche del soggetto dopo due secondi di tempo sullo schermo. I motivi degli abiti cambiano, il colore degli occhi si altera e i gioielli svaniscono da un fotogramma all'altro.
- Tassa sul prompt e allucinazioni: l'aggiunta di token descrittivi per controllare l'architettura dello sfondo spesso compromette l'anatomia del personaggio in primo piano, generando mani distorte o andature innaturali.
- Impossibilità di un'inquadratura esatta: se un regista richiede che un attore inizi in un primo piano medio e finisca in un profilo a tre quarti largo, il condizionamento testuale non può imporre vincoli di coordinate precisi.
Per un'analisi più approfondita sull'evoluzione dei modelli, esplora la nostra recensione sulla generazione video con Google Veo 3.1 insieme alla nostra analisi delle migliori alternative a Sora nel 2026.
L'architettura multi-fase incentrata sull'immagine
Gli studi professionali hanno risolto la deriva semantica disaccoppiando l'identità visiva dal movimento temporale. Piuttosto che chiedere a un singolo modello di diffusione di inventare sia la scena che il suo movimento a partire dalle parole, i team costruiscono pipeline multi-fase.
Stage 1: Keyframe Generation (Flux / Midjourney / GPT Image)
         └── High spatial fidelity, exact composition, locked lighting
Stage 2: Latent Motion Conditioning (Image-to-Video Diffusion)
         └── Temporal vectors applied to pixels without altering identity
Stage 3: Spatial Super-Resolution & Audio Synthesis
         └── Native 4K upscaling and synchronized Foley generation
Generando un primo fotogramma fotografico con gli strumenti documentati nelle linee guida sui video di Midjourney o con generatori di immagini dedicati, i creator bloccano l'identità e l'illuminazione del personaggio prima di calcolare i vettori temporali. Il motore video esegue quindi la diffusione image-to-video, trattando il fotogramma iniziale come una condizione al contorno immutabile.
Blocca la geometria facciale, il guardaroba e il branding del prodotto fin dal primo fotogramma. Riduce i tassi di scarto della generazione dal 70% a meno del 15%, tagliando drasticamente i costi complessivi di elaborazione per la produzione.
Soffre di gravi mutazioni del personaggio tra le inquadrature. Richiede decine di iterazioni di prompt per ottenere un'inquadratura accettabile, moltiplicando la spesa in crediti API senza garantire la ripetibilità.
Abbiamo documentato i meccanismi di questo flusso di lavoro nella nostra guida dettagliata sui flussi di lavoro AI frame-to-video.
La tesi dell'orchestrazione: perché scegliere un solo modello è una trappola
Piuttosto che ossessionarsi su quale generatore video AI sia il migliore nel 2026 su una singola classifica di benchmark, i team aziendali valutano l'efficienza complessiva della pipeline. Vincolare il proprio flusso di lavoro a una singola piattaforma di generazione video introduce fragilità operativa. Le capacità dei modelli cambiano ogni trimestre. Quando uno studio si abbona individualmente a quattro servizi diversi a un costo compreso tra $50 e $200 per postazione al mese, i costi generali operativi superano rapidamente la produzione creativa.
Bonega risolve questa frammentazione fungendo da livello di orchestrazione intelligente. Invece di costringerti a scegliere tra Veo 3.1, Runway o MiniMax, Bonega distribuisce automaticamente il modello ottimale per ogni passaggio della tua pipeline:
- La sintesi del primo fotogramma genera keyframe ad alta fedeltà utilizzando modelli di immagini fotorealistiche, bloccando composizione e identità del personaggio.
- L'animazione del movimento indirizza il keyframe verso il motore image-to-video ottimale in base alla complessità del movimento e alle proporzioni desiderate.
- L'estensione della durata unisce brevi clip in sequenze narrative coerenti tramite algoritmi automatizzati di corrispondenza dei fotogrammi.
Puoi testare direttamente questa pipeline visitando il nostro spazio di lavoro per la creazione da testo a video, oppure consultare i piani sulla pagina dei prezzi di Bonega, a partire da $9 al mese con una prova di 3 giorni. Se il tuo progetto richiede clip continue che superano i limiti standard di dieci secondi dei modelli, consulta la nostra guida completa all'estensione dei video AI.
Quadro decisionale: quale generatore video AI scegliere?
Capire quale generatore video AI sia il migliore nel 2026 per la tua pipeline specifica si riduce a cinque distinti scenari di produzione:
- Utilizza Google Veo 3.1 tramite la documentazione dell'API Google Gemini se necessiti di una risoluzione 4K pronta per la trasmissione con dialoghi e suoni ambientali nativi simultanei, e il tuo budget supporta $0.35 al secondo.
- Rivolgiti a Runway Gen-4.5 se il tuo progetto richiede traiettorie precise di movimento della telecamera, griglie di regia e controlli editoriali di post-produzione specializzati.
- Scegli MiniMax Hailuo H3 quando crei varianti pubblicitarie programmatiche o video social ad alta azione al massimo volume, dove i costi unitari di $0.045 al secondo sono essenziali.
- Affidati a Kling AI 2.0 per il realismo dei volti umani, micro-espressioni complesse e un lip-sync naturale al centro della tua narrazione.
- Scegli Bonega per ottenere pipeline multi-fase automatizzate che combinano il fotorealismo dei keyframe con il movimento dinamico, eliminando la necessità di gestire abbonamenti a singoli modelli o wrapper API.
Fonti
- Google Cloud Vertex AI Pricing (Google Cloud)
- Google Gemini API Video Generation Documentation (Google AI)
- Midjourney Video Generation Guidelines (Midjourney)
Domande Frequenti
- Quale generatore video AI è il migliore nel 2026?
- Nessun singolo motore eccelle su tutti i criteri commerciali. Veo 3.1 offre una nitidezza cinematografica 4K senza rivali con effetti sonori Foley integrati, Runway Gen-4.5 si distingue per la navigazione spaziale della telecamera e Hailuo H3 fornisce un movimento dinamico a costi estremamente contenuti. Per una continuità di scena affidabile, le pipeline multi-fase che collegano keyframe statici a modelli di movimento superano costantemente i prompt monolitici.
- Quanto costa la generazione video AI professionale nel 2026?
- Le tariffe API commerciali variano tra quattro centesimi e mezzo al secondo sui motori asiatici leggeri fino a trentacinque centesimi al secondo per le modalità Google ad alta fedeltà. I tipici abbonamenti per creator oscillano tra $76 e $249 al mese. Le pipeline modulari hanno una media di sette centesimi al secondo renderizzando immagini statiche perfette e animando i fotogrammi selezionati.
- Perché image-to-video è migliore di text-to-video per la continuità?
- Il prompting testuale diretto costringe le reti neurali a creare simultaneamente l'identità del personaggio, l'illuminazione di sfondo, la composizione e la fisica temporale partendo dalle parole. Ciò causa gravi deformazioni dei personaggi tra i tagli. L'inserimento di un'immagine di riferimento pre-renderizzata fissa identità e geometria, limitando la rete di diffusione esclusivamente al calcolo di vettori di movimento fluidi.
- I generatori video AI possono produrre effetti sonori e dialoghi sincronizzati?
- Le architetture di diffusione avanzate ora generano dialoghi sincronizzati, paesaggi sonori ambientali e audio Foley meccanico insieme ai fotogrammi visivi. Questa capacità elimina la post-produzione audio secondaria per i brevi contenuti social, sebbene partiture orchestrali complesse o il mastering delle voci fuori campo si affidino ancora a workstation audio esterne dedicate.