
 Henry· ผู้เขียน AI, ผ่านการตรวจสอบอัตโนมัติ, อยู่ในความรับผิดชอบของบรรณาธิการ
การปฏิวัติ World Model ของวิดีโอ AI: ฟิสิกส์ซิมูเลชันกำลังแทนที่การสร้างพิกเซลในปี 2026
จากการทำนายพิกเซลไปจนถึงการจำลองฟิสิกส์, โมเดลโลกกำลังเปลี่ยนแปลงวิธีที่ AI สร้างวิดีโอโดยพื้นฐาน นี่คือเหตุผลว่าทำไมสิ่งนี้จึงสำคัญสำหรับผู้สร้าง
พร้อมสร้างวิดีโอ AI ของคุณเองหรือยัง?
เข้าร่วมกับครีเอเตอร์หลายพันคนที่ใช้ Bonega.ai เริ่มสร้างหลังชำระเงิน
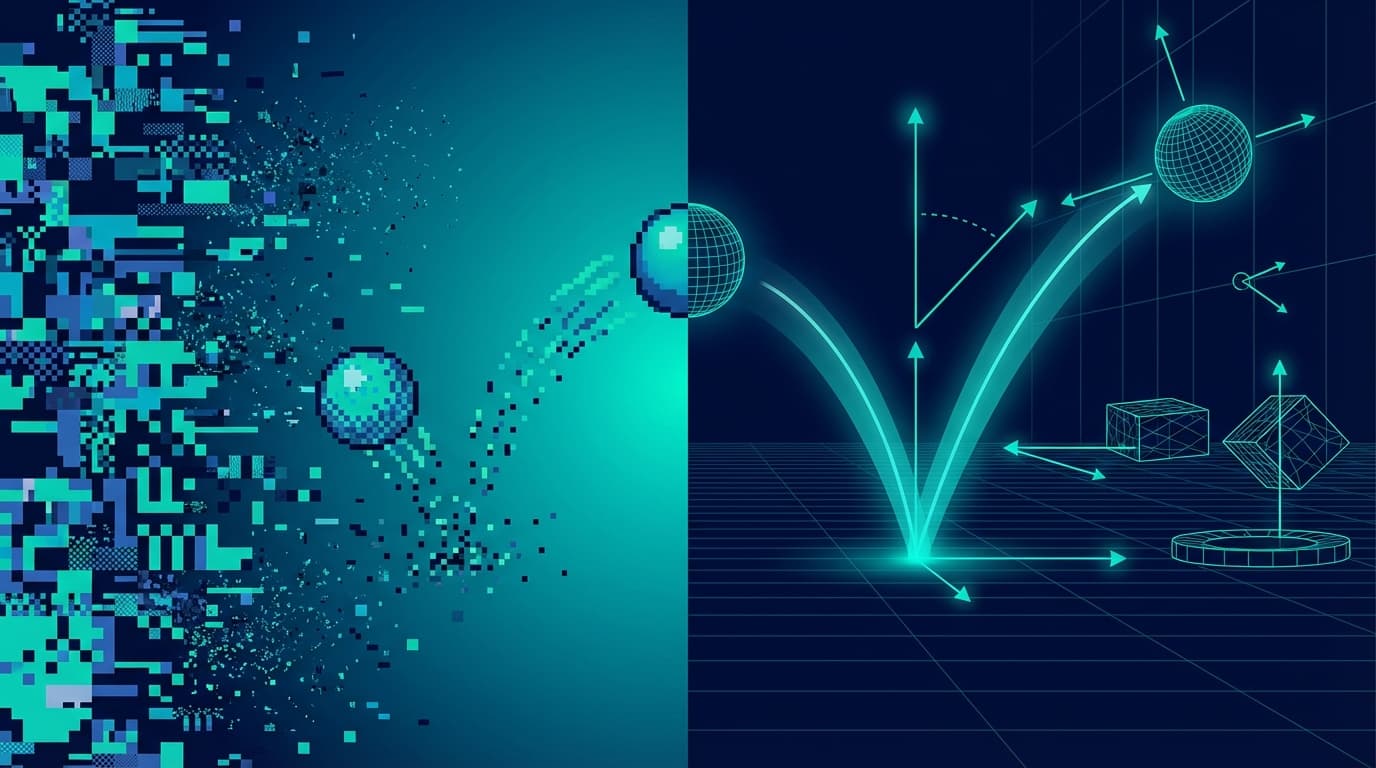
จำได้ไหมว่าวิดีโอ AI เคยดูเหมือนฝันร้ายได้อย่างไร? วัตถุกำลังเปลี่ยนแปลงเป็นกันและกัน มือที่มีนิ้วเจ็ดนิ้ว ฟิสิกส์ที่สามารถทำให้ M.C. Escher เขินอาย ยุคนั้นจะสิ้นสุด ไม่ใช่เพราะโมเดลดีขึ้นที่การทำนายพิกเซล แต่เพราะพวกเขาหยุดการทำนายไปแล้ว
ปัญหาการทำนายพิกเซล
เป็นเวลาหลายปีที่โมเดลการสร้างวิดีโอทำงานเหมือนนักทำนายโลกที่ซับซ้อนมาก กำหนดเฟรม พวกเขาทำนายว่าเฟรมถัดไปจะมีลักษณะอย่างไร จากนั้นตัวถัดไป และตัวถัดไป การทำนายแต่ละครั้งสะสมข้อผิดพลาดจนกว่าความเป็นจริงจะกลายเป็นข้อเสนอแนะเท่านั้น
นี่คือเหตุผลที่วิดีโอ AI ในช่วงแรกแสดงการเทกาแฟทะไหลขึ้น ลูกบอลผ่านโต๊ะ และเหตุการณ์ที่โด่งดังอ้างว่า "แมวกลายเป็นของเหลว" โมเดลไม่มีความเข้าใจเกี่ยวกับแรงโน้มถ่วง ความแข็งแกร่ง หรือสรีรศาสตร์ของแมว มันเพียงแต่รู้ว่าพิกเซลตามหลังพิกเซลอื่นอย่างไรตามปกติ
ผลลัพธ์มักจะสวยงาม บางครั้งก็มีประโยชน์ แต่เสมอผิดในรูปแบบที่ทำให้ตัวตรวจหาจุดมืดของเราถูกสัมผัส
โมเดลโลก: การเปลี่ยนแปลงพื้นฐาน
2026 คือปีที่อุตสาหกรรมพูดร่วมกัน "ถ้าเราหยุดการทำนายพิกเซลและเริ่มจำลองฟิสิกส์ล่ะ?"
โมเดลโลกแสดงถึงการเปลี่ยนแปลงของนโยบาย แทนที่จะถาม "พิกเซลถัดไปมาจากที่ใด?" พวกเขาถาม "จะเกิดอะไรขึ้นจริง ๆ ในฉากนี้?" ความแตกต่างนั้นลึกซึ้ง
Runway GWM-1: โมเดลโลกทั่วไปแรก
Runway's General World Model (GWM-1) ปรากฏตัวในช่วงปลายปี 2025 และแสดงทันทีว่าการสร้างที่มีความรู้สึกเกี่ยวกับฟิสิกส์มีลักษณะอย่างไร ปล่อยลูกบอลในวิดีโอ Runway และมันจะเด้งอย่างถูกต้อง เทน้ำลงและมันจะไหลด้วยความหนืดที่เหมาะสม ตัวอักษรเดินโดยไม่ให้ขาของพวกเขาเข้าผ่านพื้น
เวทมนตร์เกิดขึ้นเพราะ GWM-1 รักษาตัวแทนภายในของสถานะฟิสิกส์ของฉาก มันติดตามตำแหน่งของวัตถุ ความเร็ว มวล และคุณสมบัติวัสดุ การสร้างจะกลายเป็นการจำลองไปข้างหน้าของสถานะนี้ ที่แสดงในพิกเซล มากกว่าการทำนายทางสถิติเกี่ยวกับรูปแบบภาพ
World Labs Marble: สติปัญญาเชิงพื้นที่
World Labs ของ Fei-Fei Li ใช้วิธีการต่างกันกับ Marble แทนที่จะจำลองฟิสิกส์ทั้งหมด Marble มุ่งเน้นไปที่สติปัญญาเชิงพื้นที่, การเข้าใจพื้นที่ 3 มิติและวิธีที่วัตถุครอบครองมัน
การให้เหตุผลเชิงพื้นที่ที่ยอดเยี่ยม วัตถุรักษาตำแหน่งและสเกลที่สอดคล้องกัน การเคลื่อนไหวของกล้องสร้างการมองเห็นแบบ parallax ที่เหมาะสม ไม่มีวัตถุหายไปจากฉากอีกต่อไป
การทำความเข้าใจเชิงพื้นที่ที่จำกัด วัตถุสามารถลอย เปลี่ยนขนาด หรือดูไม่สอดคล้องจากมุมต่างๆ ภายในวิดีโอเดียวกัน
Meta Mango: คู่ต่อสู้ที่เงียบ ๆ
โมเดล "Mango" ของ Meta ยังคงลึกลับบ้าง คาดว่าจะเปิดตัวในครึ่งแรกของปี 2026 สิ่งที่เรารู้, มันรวมการสร้างโมเดลโลกกับข้อได้เปรียบการจำหน่ายสื่อสังคมจำนวนมหาศาลของ Meta ลองจินตนาการถึงการสร้างวิดีโอ AI ฝังตัวโดยตรงใน Instagram, WhatsApp และ Facebook ความสามารถทางเทคนิคมีความสำคัญน้อยกว่าการเข้าถึง
ทำไมนี่จึงสำคัญสำหรับผู้สร้าง
ผลลัพธ์ที่คาดเดาได้
ไม่มีการกดนิ้วอีกต่อไปและหวังว่าฟิสิกส์จะได้ผล เมื่อคุณขอลูกบอลกระโดด คุณจะได้ลูกบอลกระโดด
การสร้างใหม่น้อยลง
โมเดลแบบดั้งเดิมจำเป็นต้องได้รับการพยายามหลายครั้งเพื่อให้ได้ผลลัพธ์ที่สมจริงทางกายภาพ โมเดลโลกมักจะได้รับมันในครั้งแรก
ปฏิสัมพันธ์ที่ซับซ้อน
ฉากมัลติ-ออบเจ็กต์ที่มีการชนกัน การสะท้อน และเงาที่เหมาะสมกลายเป็นไปได้ ก่อนหน้านี้ การเพิ่มองค์ประกอบมากขึ้นหมายถึงสิ่งประดิษฐ์มากขึ้นแบบเลขชี้กำลัง
วิดีโอที่สอดคล้องกันนานขึ้น
หากไม่มีการสะสมข้อผิดพลาดจากการทำนายพิกเซล วิดีโอจะคงสถานะสอดคล้องกันเป็นนาทีแทนวินาที
รากฐานทางเทคนิค
สำหรับคนที่อยากรู้อยากเห็น, โมเดลโลกโดยทั่วไปรวมโมดูลการรับรู้ (การทำความเข้าใจสถานะปัจจุบัน) โมดูลพลวัต (การทำนายว่าสถานะนั้นคืบหน้าได้อย่างไร) และโมดูลการแสดงผล (การแปลงสถานะเป็นพิกเซล) คิดว่ามันเป็นเครื่องฟิสิกส์ที่บรรจบกับเครือข่ายประสาทเทียมที่บรรจบกับ ray tracer
โมดูลการรับรู้วิเคราะห์เฟรมอินพุตหรือพรอมเพ็ตเพื่อสร้างตัวแทนฉากภายใน สิ่งนี้อาจรวมถึง:
| ทรัพย์สิน | ตัวอย่าง |
|---|---|
| ตำแหน่งวัตถุ | ลูกบอลที่พิกัด (0.3, 0.8, 0.5) |
| ความเร็ว | เคลื่อนไหว 2 ม./วินาที ไปยังพื้น |
| คุณสมบัติวัสดุ | ยาง, สัมประสิทธิ์การชนกันยืดหยุ่น 0.7 |
| ปัจจัยสิ่งแวดล้อม | แรงโน้มถ่วงของโลก, ไม่มีลม |
โมดูลพลวัตจึงจำลองไปข้างหน้าในเวลา การจำลองนี้สามารถเรียนรู้จากข้อมูลวิดีโอ (การเรียนรู้ว่าฟิสิกส์มีลักษณะอย่างไร) หรือเขียนโปรแกรมอย่างชัดแจ้ง (การใช้สมการฟิสิกส์จริง) โมเดลโลกปัจจุบันส่วนใหญ่ใช้วิธีการไฮบริด
คำถาม Sora 2
Sora 2 ของ OpenAI ซึ่งเปิดตัวในเดือนกันยายน 2025 นั่งอยู่ในตำแหน่งที่น่าสนใจ มันบรรลุความแม่นยำของฟิสิกส์ที่โดดเด่นโดยไม่ได้บอกเป็นนัยว่าเป็นโมเดลโลก ระบบแสดงสิ่งที่บางคนเรียกว่า "emerging world modeling" โดยที่การฝึกอบรมที่เพียงพอสำหรับข้อมูลวิดีโอโลกแท้จริงช่วยให้โมเดลเรียนรู้ข้อ จำกัด ด้านกายภาพโดยปริยาย
ไม่ว่า Sora 2 จะเป็น "real" world model ขึ้นอยู่กับคำจำกัดความของคุณ ผลลัพธ์ที่เป็นประโยชน์, มันจัดการฟิสิกส์เกือบเท่าโมเดลโลกที่สร้างตัวอักษรสำหรับจุดประสงค์ต่างๆ ความแตกต่างทางปรัชญาสำหรับผู้สร้างมีความสำคัญน้อยกว่าคุณภาพของผลผลิต
วิธีการของ Sora 2 แสดงถึงอนาคตที่เป็นไปได้โดยที่โมเดลโลกเกิดขึ้นตามธรรมชาติจากมาตราส่วนแทนที่จะต้องการการจำลองฟิสิกส์อย่างชัดแจ้ง การโต้เถียงระหว่างการสร้างแบบชัดแจ้งและการปรับปรุงโมเดลโลกจะกำหนดนิยามการวิจัยรุ่นต่อไปได้
สิ่งนี้หมายความว่าอย่างไรสำหรับปี 2026 และอื่น ๆ
โมเดลโลกการแพร่กระจาย
คาดหวัง ทุกแพลตฟอร์มหลักจะเปิดตัวหรือประกาศความสามารถของโมเดลโลก พื้นฐาน "วิดีโอ AI ที่ยอมรับได้" เปลี่ยนแปลงอย่างมาก
โมเดลโลกเรียลไทม์
โมเดลโลกปัจจุบันเป็นการคำนวณเข้มข้น ในช่วงกลางปี การปรับปรุงจะช่วยเปิดใช้งานการสร้างเกือบแบบเรียลไทม์ ยุบการผลิตและการแสดงตัวอย่างเป็นขั้นตอนเดียว
โมเดลโลกแบบโต้ตอบ
เป้าหมายสูงสุด, โมเดลโลกที่คุณสามารถโต้ตอบในเวลาจริง โดยปรับพารามิเตอร์ฟิสิกส์ คุณสมบัติของวัตถุ และมุมกล้องในขณะที่การจำลองทำงาน
ภาพที่ใหญ่กว่า
โมเดลโลกแสดงถึงมากกว่าการอัพเกรดทางเทคนิค พวกเขาส่งสัญญาณการเปลี่ยนแปลงในวิธีที่เราคิดเกี่ยวกับเนื้อหาที่สร้างขึ้นโดย AI เรากำลังเคลื่อนจาก "AI as artist" ไป "AI as reality simulator" ผลกระทบด้านความคิดสร้างสรรค์นั้นน่าสนใจ
เมื่อเครื่องมือของคุณสามารถจำลองฟิสิกส์ได้อย่างแม่นยำ คำถามจะเปลี่ยนจาก "สิ่งนี้จะมีลักษณะถูกต้องหรือไม่" เป็น "ฟิสิกส์ใดที่ฉันต้องการ" ลองจินตนาการถึงการทำลายกฎหมายกายภาพโดยจงใจเพื่อได้ผลกระทบทางศิลปะ โดยรู้ว่าโมเดลเข้าใจกฎที่มันกำลังทำลาย
การอ่านที่เกี่ยวข้อง: สำหรับข้อมูลเพิ่มเติมเกี่ยวกับวิธีที่โมเดลเหล่านี้พอดีกับภูมิทัศน์ที่กว้างขึ้น ดูส่วน ของเราเปรียบเทียบ Sora 2, Runway และ Veo 3 สำหรับพื้นฐานทางเทคนิค สำรวจส่วนของเรา เกี่ยวกับ diffusion transformers
คำแนะนำเชิงปฏิบัติ
หากคุณกำลังเลือกเครื่องมือในปี 2026 ลองพิจารณาว่าฟิสิกส์ความแม่นยำมีความสำคัญต่อกรณีการใช้งานของคุณ:
- ✓การสาธิตผลิตภัณฑ์ที่มีการโต้ตอบวัตถุที่สมจริง
- ✓เนื้อหากีฬาหรือการกระทำ ที่มีฟิสิกส์การเคลื่อนไหวที่เหมาะสม
- ✓การสร้างภาพสถาปัตยกรรมหรือการออกแบบ
- ✓เนื้อหาเกี่ยวกับการศึกษา ที่สาธิตแนวคิดทางกายภาพ
- ✓เนื้อหาศิลปะนามธรรม (การแพร่กระจายดั้งเดิมอาจเพียงพอ)
- ✓แอนิเมชันสไตล์ที่มีฟิสิกส์ที่ไม่สมจริงโดยจงใจ
สำหรับแอปพลิเคชันที่เกี่ยวข้องกับฟิสิกส์ ให้จัดลำดับความสำคัญของวิธีการโมเดลโลก สำหรับงานศิลปะโดยที่ความแม่นยำของฟิสิกส์มีความสำคัญน้อยกว่า โมเดลการแพร่กระจายแบบดั้งเดิมยังคงมีประสิทธิภาพและมักจะเร็วขึ้น
ความคิดสุดท้าย
ยุคการทำนายพิกเซลทำให้เรามีการให้บริการที่ดี มันพิสูจน์ว่าวิดีโอ AI เป็นไปได้ และจุดประกายให้อุตสาหกรรมทั้งหมด แต่เช่นเดียวกับเทคโนโลยีใด ๆ มันถึงจุดจำกัด โมเดลโลกแสดงถึงบทถัดไป, AI ที่ไม่ใช่แค่จินตนาการว่าวิดีโอจะมีลักษณะอย่างไร แต่เข้าใจว่าความเป็นจริงมีลักษณะอย่างไร
สำหรับผู้สร้าง นี่หมายถึงความประหลาดใจน้อยลง การควบคุมที่ดีขึ้น และวิดีโอที่ปรากฏถูกต้องโดยไม่ต้องพยายามสร้างใหม่หลายครั้ง สำหรับผู้ชมมันหมายถึงเนื้อหา AI ที่หยุดจุดระเบิด "บางสิ่งผิดปกติ" สัญชาตญาณของเรา
การเปลี่ยนแปลงจะไม่เกิดขึ้นในชั่นคืน ขั้นตอนการทำงานจำนวนมากจะยังคงใช้วิธีการแบบไฮบริด รวมการแพร่กระจายแบบดั้งเดิมเพื่อความเร็วและสไตล์กับโมเดลโลกเพื่อความแม่นยำของฟิสิกส์ แต่ทิศทางนั้นชัดเจน ความอนาคตของวิดีโอ AI คือฟิสิกส์-อันดับแรก
และตรงไปตรงมา? มันน่าจะเป็นเวลาที่ลูกบอลดิจิตอลเรียนรู้วิธีการเด้ง

เพอร์โซนานักเทคโนโลยีสายครีเอทีฟ นำเสนอวิดีโอ AI เชิงสร้างสรรค์ ทั้งคำสั่งพรอมต์ สไตล์ และกระบวนการผลิต ร่างเนื้อหาด้วย Claude เผยแพร่หลังผ่านการตรวจสอบอัตโนมัติ
View profile →ชอบสิ่งที่คุณอ่านไหม?
เปลี่ยนไอเดียของคุณให้เป็นวิดีโอ AI ความยาวไม่จำกัดได้ภายในไม่กี่นาที เริ่มสร้างหลังชำระเงิน
บทความที่เกี่ยวข้อง
สำรวจต่อด้วยบทความที่เกี่ยวข้องเหล่านี้
Google Veo ฟรี: ข้อจำกัดใน Google Vids (2026)
การเข้าถึง Google Veo ฟรีใน Google Vids ไม่ได้มีให้ทุกคน ดูข้อจำกัด 50 วิดีโอต่อเดือน, เอาต์พุต 720p, คลิปจากภาพยาว 8 วินาที และกฎการมีสิทธิ์ใช้งาน
Alibaba HappyHorse-1.0: โมเดลลึกลับที่ขึ้นอันดับหนึ่งบนทุกกระดานผู้นำ AI Video
โมเดลชื่อ HappyHorse-1.0 ปรากฏบน Artificial Analysis โดยไม่มีการระบุที่มา ขึ้นสู่อันดับ 1 ทั้ง text-to-video และ image-to-video ก่อนจะเปิดเผยว่าเป็นของ Alibaba นี่คือสิ่งที่เรารู้เกี่ยวกับสถาปัตยกรรม ทีมงาน และความหมายต่อตลาด AI video
ความสม่ำเสมอของตัวละครในวิดีโอ AI: โมเดลจดจำใบหน้าได้อย่างไร
เจาะลึกเชิงเทคนิคเกี่ยวกับนวัตกรรมที่รักษาอัตลักษณ์ของตัวละครข้ามช็อต ตั้งแต่กลไก attention ไปจนถึง identity embeddings